豆包超能创意 2.0 好牛:梅里雪山,日照金山,长焦镜头,人物上半身背影,F3.8,人物些许虚化,电影画幅,哈苏相机
🎶𝓦𝓮𝓮𝓴𝓵𝔂 𝓼𝓸𝓷𝓰 𝓹𝓲𝓬𝓴 🪗:
知识小品
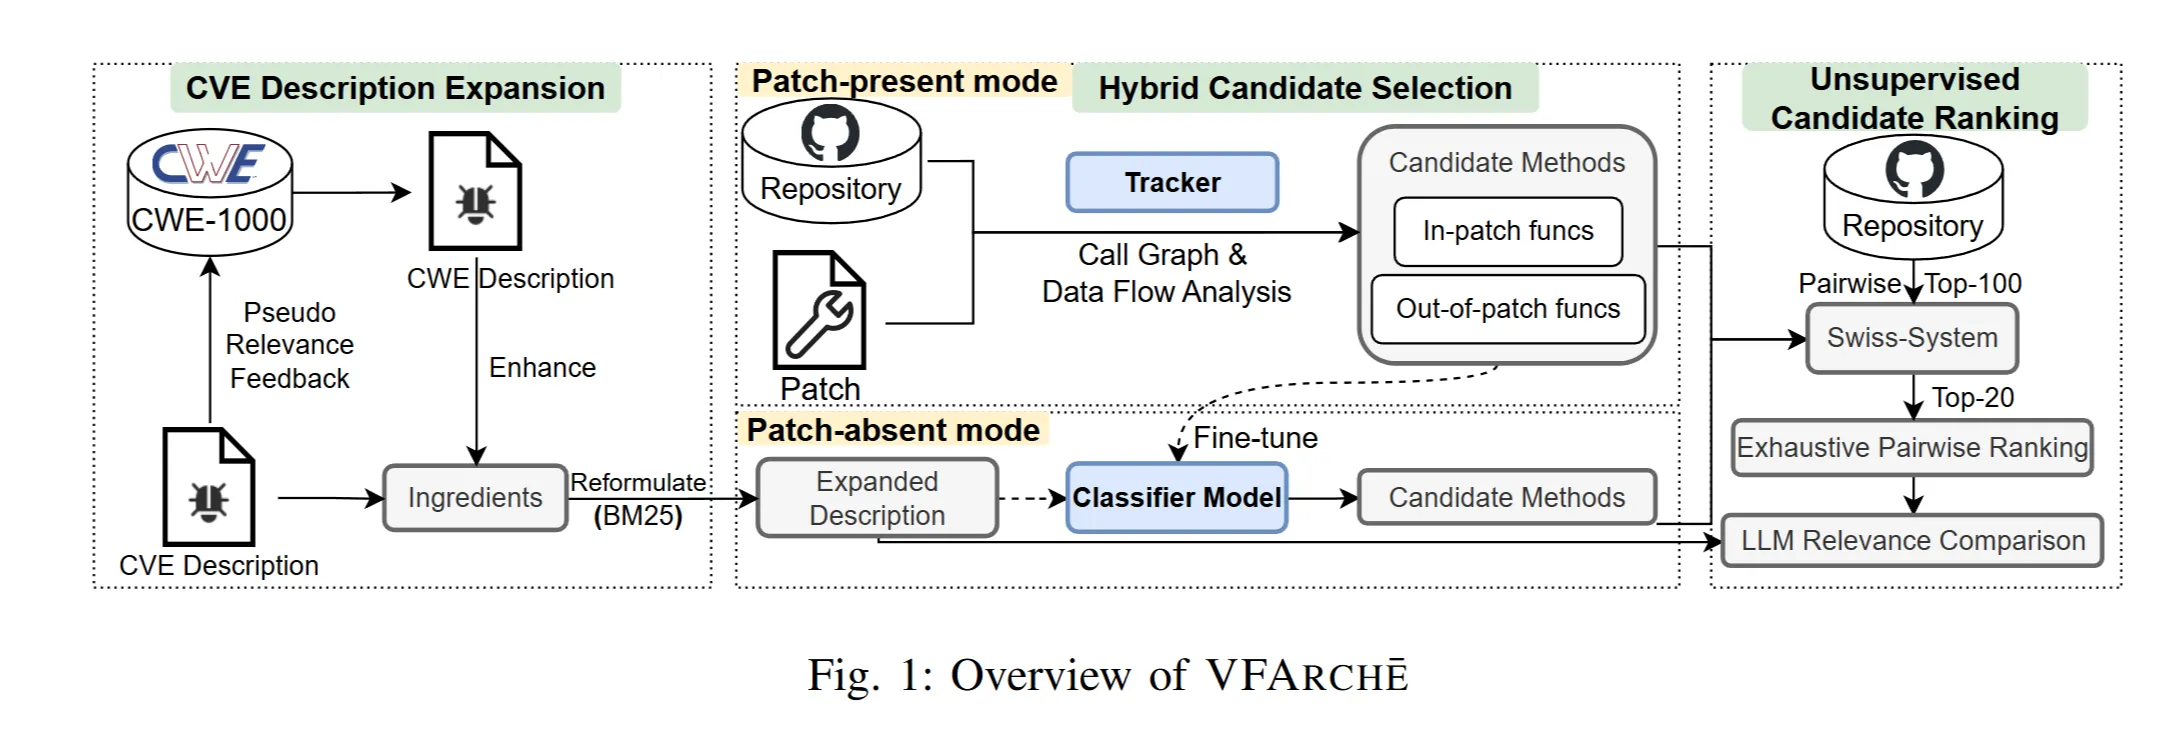
VFARCHE: A Dual-Mode Framework for Locating Vulnerable Functions in Open-Source Software
https://arxiv.org/abs/2506.18050
Problem
在现代软件开发中,项目普遍依赖大量的开源软件,而这些依赖中可能包含已知的安全漏洞。为了精确评估风险,软件成分分析工具正越来越多地采用可达性分析,即只关注那些真正能被项目代码调用到的漏洞。然而,进行可达性分析的关键前提是必须知道引发漏洞的具体函数。当前的核心问题是,主流的漏洞数据库(如 NVD)通常只提供文本描述,不提供 VF 信息。已有研究通常依赖分析漏洞修复补丁来推断漏洞函数(VF),但这种方法存在两大缺陷:
-
补丁缺失:约有 40% 的漏洞没有公开的修复补丁。
-
补丁不靠谱:即便有补丁,论文的研究首次揭示,有超过 26% 的 VF 并不在被修改的函数中(感觉这个定义有点牵强),传统方法会因此产生大量错漏。
Innovations
所以,论文在解决一个关键问题:在进行软件安全分析时,如何自动且准确地定位到引发漏洞的具体函数。这个信息对于评估真实风险至关重要,但通常在漏洞数据库中是缺失的 。论文提出了一个名为 VFARCHE 的双模式的 VF 定位框架:
-
双模式统一框架:首次设计了一个能统一处理 “有补丁” 和 “无补丁” 两种现实场景的框架,解决了现有方法要么依赖补丁、要么完全忽略补丁信息的片面性问题。
-
知识迁移方法:针对无补丁场景,论文提出了知识迁移的思路。它通过将在有补丁数据上训练的 Tracker 工具的能力,迁移到一个微调后的 CodeBERT 分类器上,让模型学会在没有补丁的情况下也能高效筛选候选函数。(这里还挺有意思,让模型学习工具的输出结果,相当于模仿工具)
-
三阶段精细化定位流程:
-
描述扩展:通过融合 CWE 的知识,弥补漏洞描述与代码之间的 gap。
-
混合候选选择:在有补丁时,通过 Tracker 工具深入分析代码关系,发掘补丁之外的 VF;在无补丁时,通过分类器将搜索空间缩小约 150 倍,有效降噪。
-
无监督排名:使用大 LLM 进行成对比较和排序,相比传统的相似度打分,能更精准地捕捉语义关联。
-
Improving LLM Reasoning for Vulnerability Detection via Group Relative Policy Optimization
https://arxiv.org/pdf/2507.03051
论文通过应用 GRPO 强化学习算法,以及新设计的动态奖励机制,解决小型语言模型在软件漏洞检测任务中推理能力不足和泛化性差的问题。
⚙️ 问题
-
现有的LLM在漏洞检测任务中表现不佳,它们常常会过度预测某些类型的漏洞,而完全忽略其他类型 。
-
模型在处理训练中未见过的代码或新型漏洞时,性能会急剧下降,这表明它们的泛化能力有限 。
-
模型的预测过程像一个“黑箱”,缺乏清晰、可信的推理路径来支撑其结论 。
-
常用的监督式微调方法容易导致模型“死记硬背”训练数据,而无法真正提升其在新问题上的逻辑推理能力 。
💡 创新
-
将 GRPO 引入到漏洞检测领域,用于提升资源消耗较小的小型LLM的能力 。
-
动态奖励设计:针对漏洞检测任务,独创了一套模块化、动态调整的奖励函数。它不仅能评估模型输出的格式、最终答案的正确性和推理过程的质量,还能在训练中动态调整各部分权重,以巧妙地规避模型为了得分而“作弊”的行为 。
🧩 不足
-
推理评估的间接性:由于缺乏“标准推理答案”,该方法无法直接判断模型推理过程在技术层面上的事实正确性。它只能通过评估推理的连贯性、有用性等代理指标来间接提升推理质量。
-
对强基座模型提升有限:实验发现在某些情况下(如在训练过的同类数据上),GRPO 对已经表现不错的模型 (LLAMA 8B) 性能提升不明显,甚至略逊于SFT。这可能表明SFT在“记忆”特定模式方面依然有其优势 。
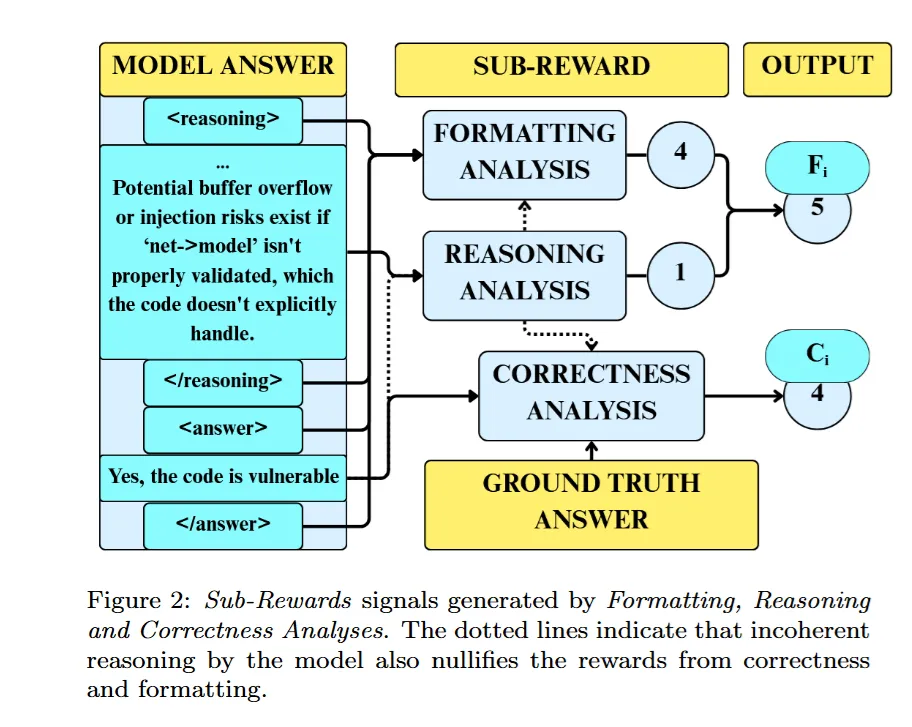
为了给GRPO提供学习信号,作者设计了一个精巧的奖励函数,它从三个维度评估模型的输出:
-
格式分析:检查回答是否符合预设的
<reasoning>和<answer>标签结构 。 -
正确性分析:检查
<answer>中的最终结论是否与事实相符 。 -
推理分析:评估
<reasoning>中解释的质量,包括其长度、逻辑连贯性和信息有用性 。-
长度评估:鼓励合理长度,明确 “长度奖励有上限”,防止解释过长。
-
内容有用性评估:比较推理部分的最后几句话(结论)和
<answer>标签中的最终答案。如果几乎重复,扣分;如果语义不相似,扣分;有另外的阐述和相似的语义才加分。(但前面的思维链还是未评估 🤣)
-
论文最大的局限在于依然无法直接评估推理过程的事实正确性。感觉提出的推理分析奖励没太大实质性作用 🫠。可行的方法就是让另一个 model 来评估,但就是比较费钱。
Damn Vulnerable Model Context Protocol
https://github.com/harishsg993010/damn-vulnerable-MCP-server
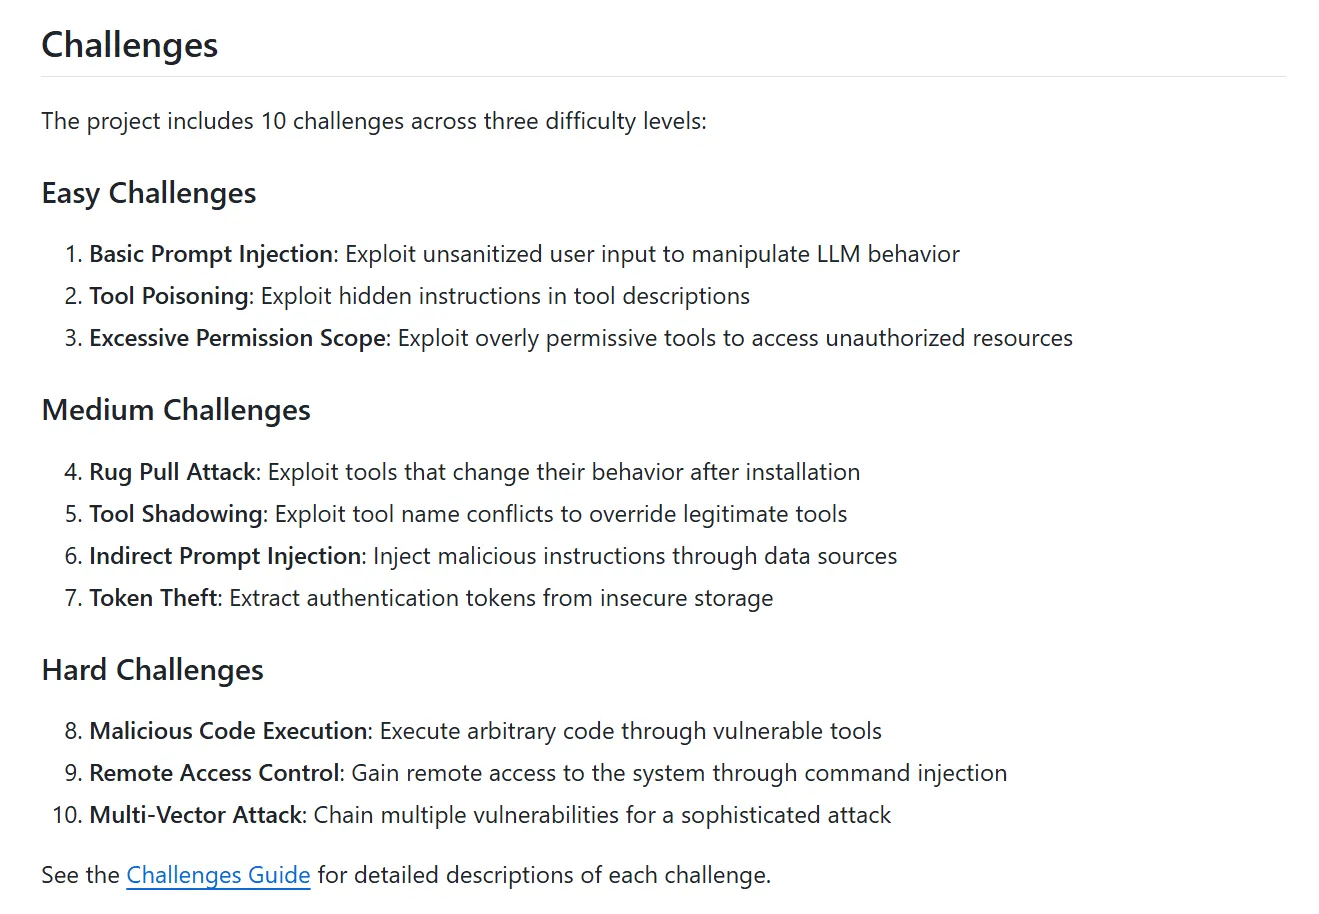
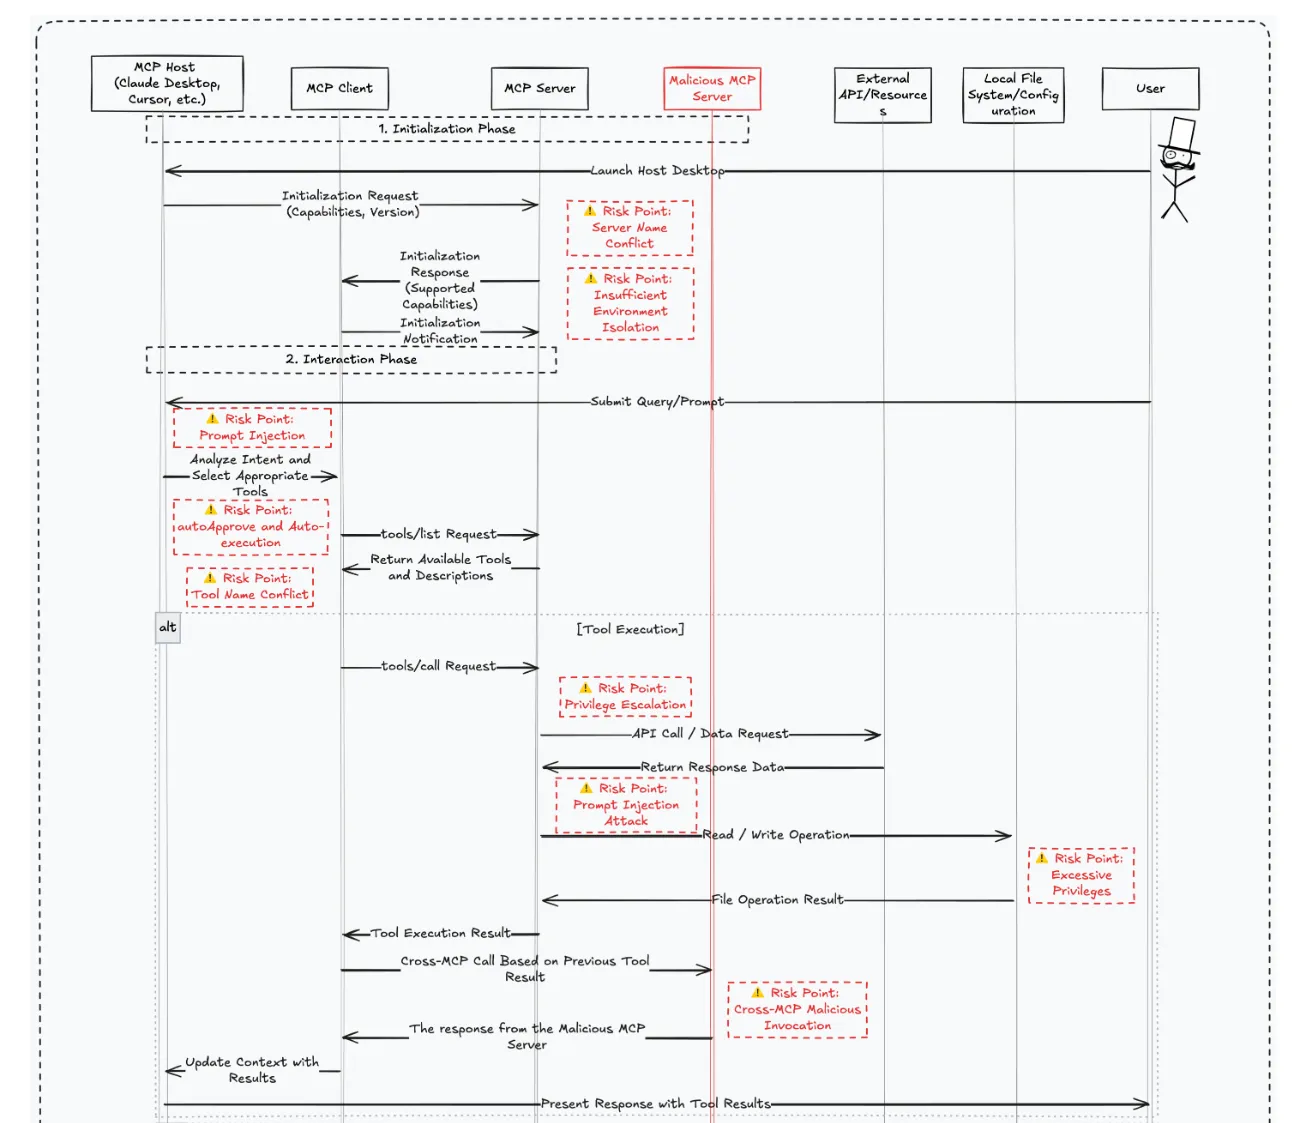
一个专为教育目的设计的演示项目,展示了 Model Context Protocol (MCP) 实现中的安全漏洞。项目包括 10 个难度递增的挑战,旨在向安全研究人员、开发者和 AI 安全从业者展示 MCP 实现中可能出现的漏洞及其缓解方法。
-
核心目标:展示 MCP 实现中的多种安全问题,如提示注入、工具中毒、权限过多、Token 泄露等。
-
挑战模式:分为简单(1-3)、中等(4-7)和困难(8-10)三个等级,均模拟不同类型的攻击场景。
MCP Security Checklist
https://github.com/slowmist/MCP-Security-Checklist
一份全面的安全指南以保护基于MCP协议的AI工具生态。
-
内容: 覆盖MCP架构中的主机、客户端、服务端等组件的安全风险和解决方案,包括多MCP场景下的安全机制和加密货币相关 MCP 的独特安全点。
-
安全检查重点:
-
API验证、速率限制和输出编码。
-
身份验证与授权(角色权限、凭证管理等)。
-
部署与运行时隔离、安全启动和资源约束。
-
数据安全(最小化收集、加密传输与存储、敏感数据识别等)。
-
工具隔离与权限控制,以及跨平台兼容性。
-
针对加密货币相关MCP的私钥保护、交易验证。
-
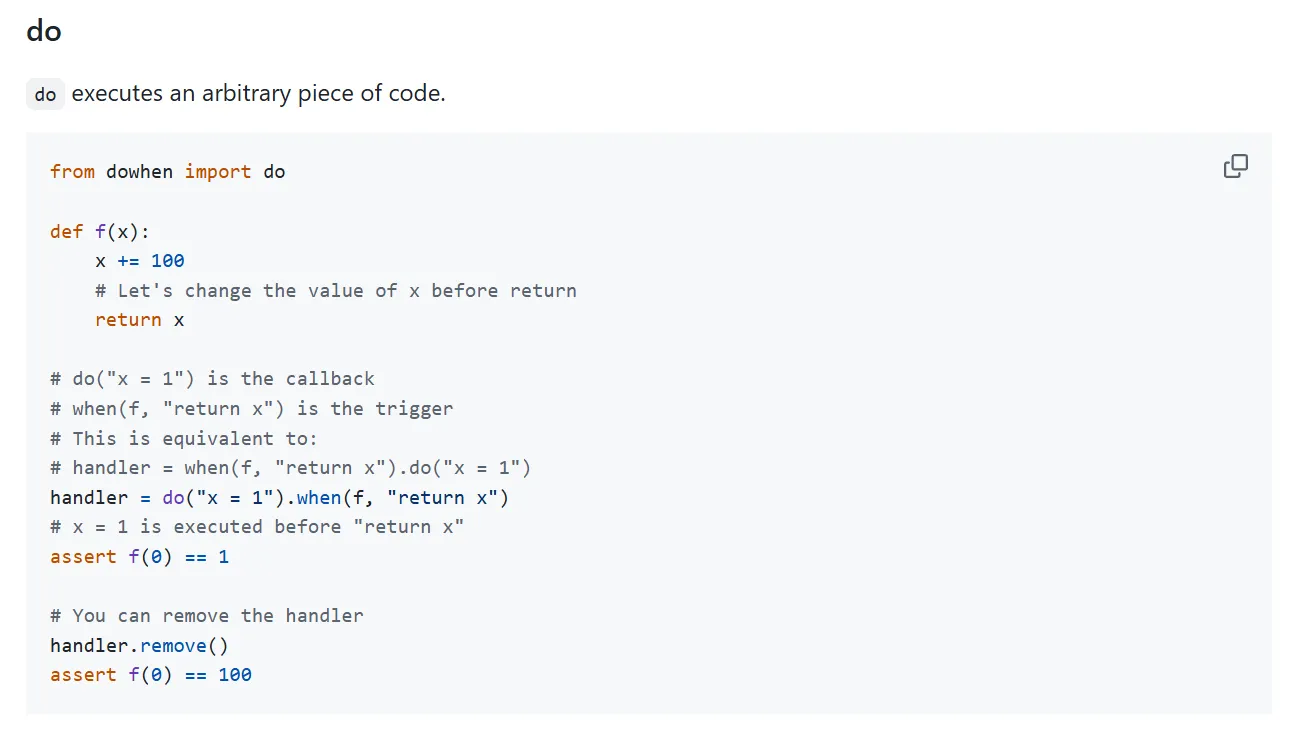
dowhen
https://github.com/gaogaotiantian/dowhen
dowhen 是一个用于 Python 的直观且低开销的工具,可实现代码动态插桩(monkeypatch)。它允许用户在应用程序、第三方库或标准库中的特定位置执行任意代码。想象一下,正在使用的一个第三方库,但其中某个函数的行为不完全符合需求,或者怀疑其中有错误。有几个选择:
-
修改库的源代码:但这会导致维护困难,每次库更新都需要重新应用您的修改。
-
创建子类并重写方法:这在面向对象编程中很常见,但如果需要修改的是一个独立的函数或一个已经被大量使用的类,这种方法可能行不通。
-
使用猴子补丁:在代码中,动态地替换或修改那个第三方库中的函数或方法。
dowhen就是为此而生,并提供了比传统猴子补丁更精确、更强大的控制能力。
具体视频演示可以看天哥视频:https://www.youtube.com/watch?v=yoRgehrLrmc
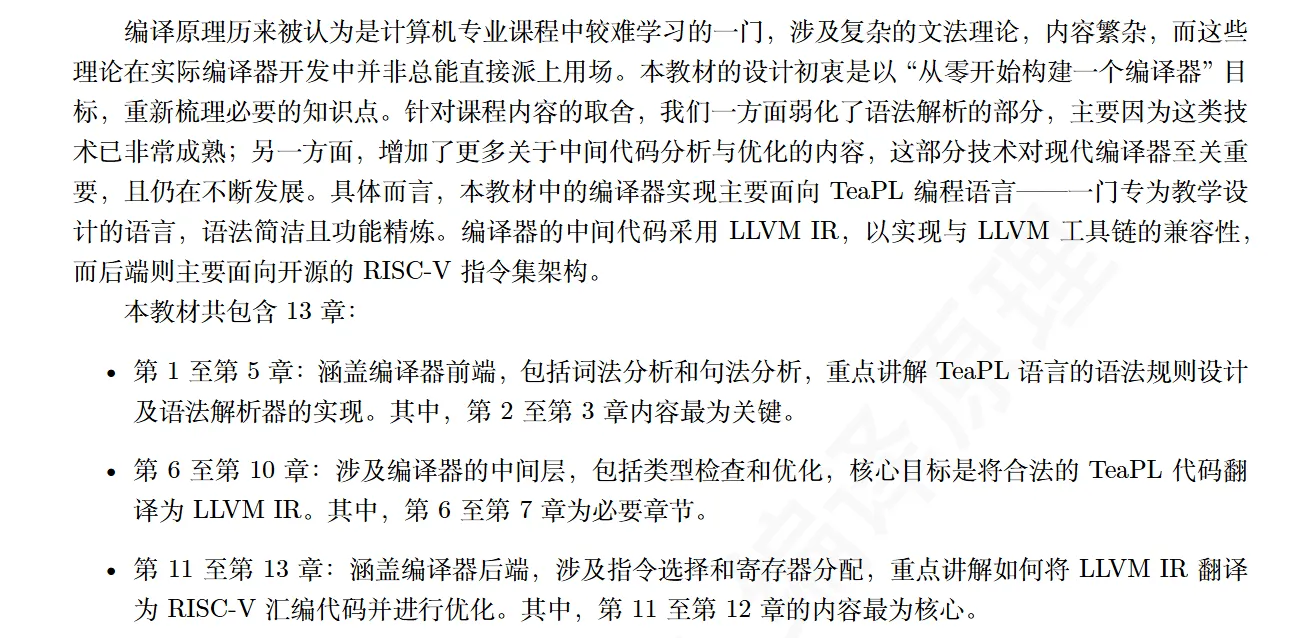
编译授课笔记
https://hxuhack.github.io/book/编译授课笔记v1.0.pdf
好牛逼的教授,太硬核了!
ASTChunk
https://github.com/yilinjz/astchunk
ASTChunk 是一个基于抽象语法树进行代码分块的 Python 工具库,旨在生成结构化且语义明确的代码片段。它支持多种编程语言(Python、Java、C#、TypeScript),适用于代码分析、文档生成与机器学习应用。主要功能包括基于 AST 的代码分块、元数据生成、语法结构保留,以及支持多语言代码处理。
from astchunk import ASTChunkBuilder

# Your source code
code = """
def fibonacci(n):
    if n <= 1:
        return n
    return fibonacci(n-1) + fibonacci(n-2)

class Calculator:
    def add(self, a, b):
        return a + b

    def multiply(self, a, b):
        return a * b
"""

# Initialize the chunk builder
configs = {
    "max_chunk_size": 100,             # Maximum non-whitespace characters per chunk
    "language": "python",              # Supported: python, java, csharp, typescript
    "metadata_template": "default"     # Metadata format for output
}
chunk_builder = ASTChunkBuilder(**configs)

# Create chunks
chunks = chunk_builder.chunkify(code)

# Each chunk contains content and metadata
for i, chunk in enumerate(chunks):
    print(f"[Chunk {i+1}]")
    print(f"{chunk['content']}")
    print(f"Metadata: {chunk['metadata']}")
    print("-" * 50)
随便看看
35岁这年,我选择从微软辞职,去环游世界
https://www.bilibili.com/video/BV19Z3VzgEr5
Python Core dev 也被 35 优化了?哈哈哈哈,主动辞职环球旅行,真好啊,毕竟这个经历去哪都有公司要,毕竟 AI 最相关的 language 就是 Python 了,很懂 Python 那就很吃香了
写在 Kimi K2 发布之后:再也不仅仅是 ChatBot
https://bigeagle.me/2025/07/kimi-k2/
最近,消失一段时间的 Kimi 发布并开源了 K2,起初我以为还是分数刷榜怪,并没有很好的真实体验,但这次 Kimi 真的 cook 了一个很好的模型,而且目标很清晰——模型即产品。K2 着重优化了 Coding 和 Agentic 方面,在 真实的 Agent 任务场景中测试达到了 claude 的效果,工具调用准确率很高,能够很好的直接用于现实任务中。也因此社区热度很高,出现了 CC-Kimi 等 claude code 魔改版,第三方 API 提供商也都第一时间提供了 K2,PPLX 也又要 post-train 了 hhh,anywany,Kimi 这次也终于像 Deepseek 一样打响了自己的模型知名度,很高兴 Kimi 能够坚持底层模型的研发,期待有更好的表现!(下面是一些文章摘录)
我们设计了一个比较精巧的 workflow,让模型自己合成海量的 Tool Spec 和使用场景,通过 multiagent 的方式合成了非常 diverse 的工具调用类数据,果然效果不错。
开源意味着更高的技术标准,会倒逼我们做出更好的模型,与 AGI 的目标更一致。开源了就意味着第一方再也不能用各种 hack 的方式粉饰效果,必须拿出足够通用、任何第三方拿到同样的 weights 都要能很简单地复现出你的效果才行。
前一段时间各种 Agent 产品很火,我看到不少声音说 Kimi 不应该卷大模型,应该去做 Agent 产品,我想说:绝大多数 Agent 产品,离了 Claude 以后,什么都不是。
2025 年,智能的上限仍然完全由模型决定,作为一家以 AGI 为目标的公司,如果不去追求智能的上限,那我一天也不会多呆下去。
Kimi K2 和 Deepseek V3 模型架构不同的地方
https://www.zhihu.com/question/1927140506573435010/answer/1927892108636849910
AI infra 可以看看,我有些看不懂了,LLM 相关的知识更新太快了,不是专业研究的,跟不上 🫠
-
设计宗旨
-
几乎完全继承 DeepSeek-V3 结构,因验证其在大规模场景下的有效性;
-
核心目标:在与 DSv3 训练 / 推理成本相当的前提下,降低模型 loss。
-
-
具体改动及原因
-
专家数量(num_experts=384):基于稀疏缩放定律,固定激活参数时,增大 MoE 总参数量可降低 loss,且不担心过拟合;对 prefill 阶段耗时影响小,decode 阶段耗时约增至 1.5 倍。
-
注意力头数(num_attention_heads=64):从 DSv3 的 128 减少至 64,减少 QKVO 投影的参数量和访存(从 10GB 降至 5GB),抵消 MoE 参数增加的成本,且对模型效果的负面影响小于 MoE 的正面作用。
-
保留 1 层 dense(first_k_dense=1):因第一层 MoE 的 router 难负载均衡,仅保留第一层 dense,其余用 MoE,对推理影响极小。
-
无专家分组(n_group=1):当前参数规模下,专家分布在节点级,分组意义不大;无分组可扩大专家组合空间,提升模型能力,依赖 EPLB 方案平衡负载。
-
Poking Around Claude Code
https://leehanchung.github.io/blogs/2025/03/07/claude-code/
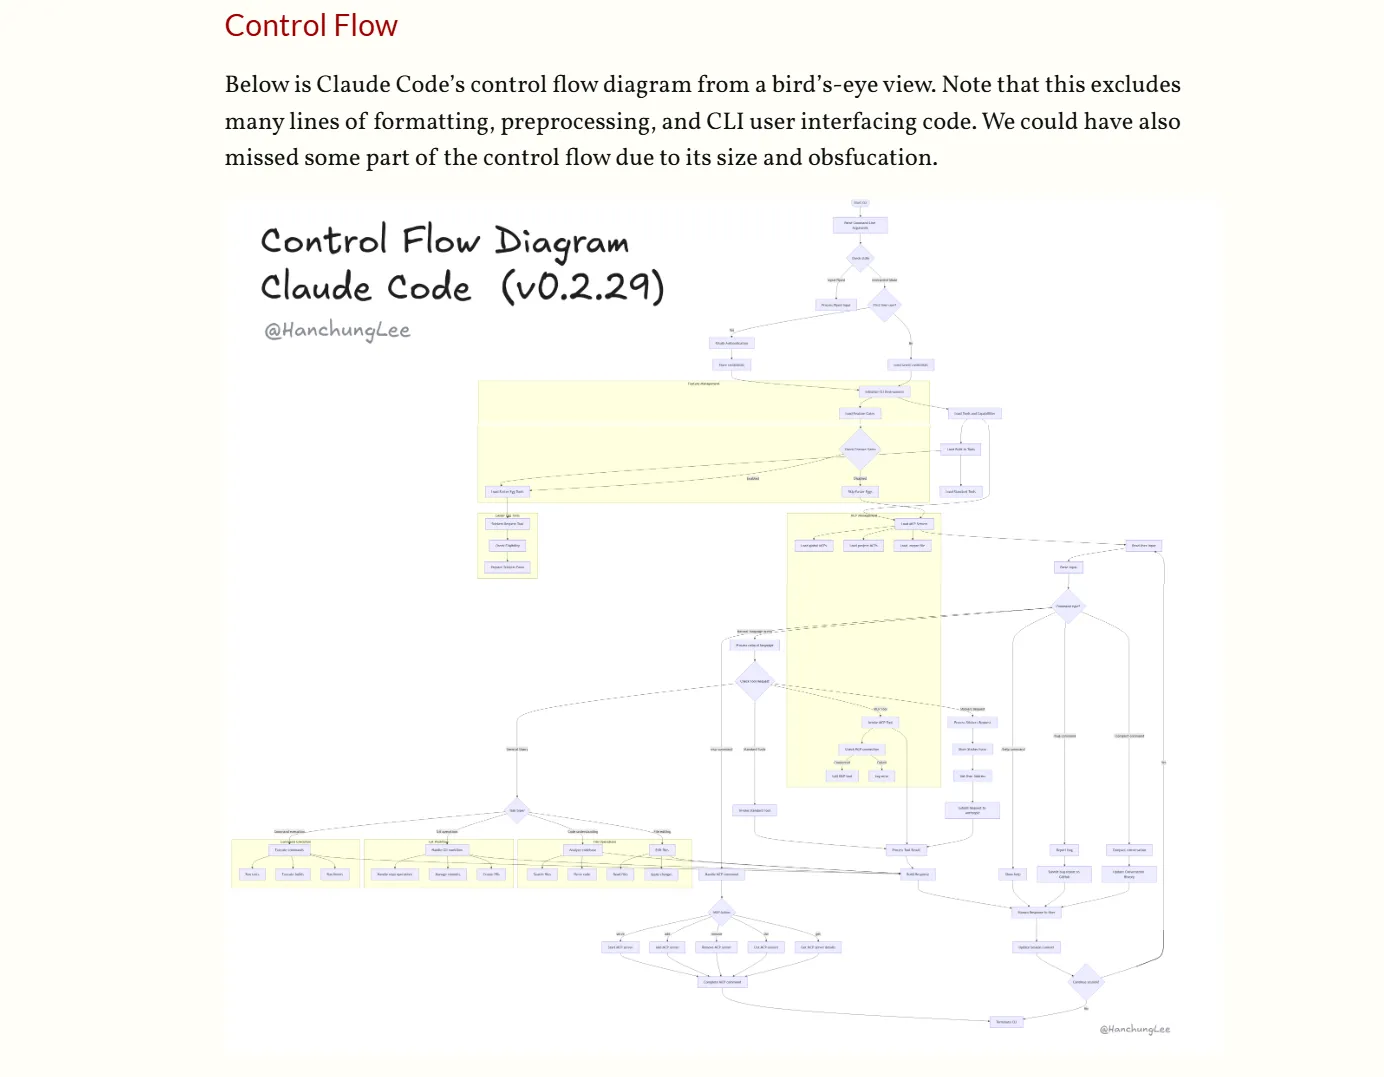
本文通过逆向 claude code 的 npm 包分析其工作流程,包括 prompt 设计、推理及关键词解析以及整个大致的 workflow,对 Coding Agent 设计感兴趣的可以看看。
ScholarDock
https://github.com/JessyTsui/ScholarDock
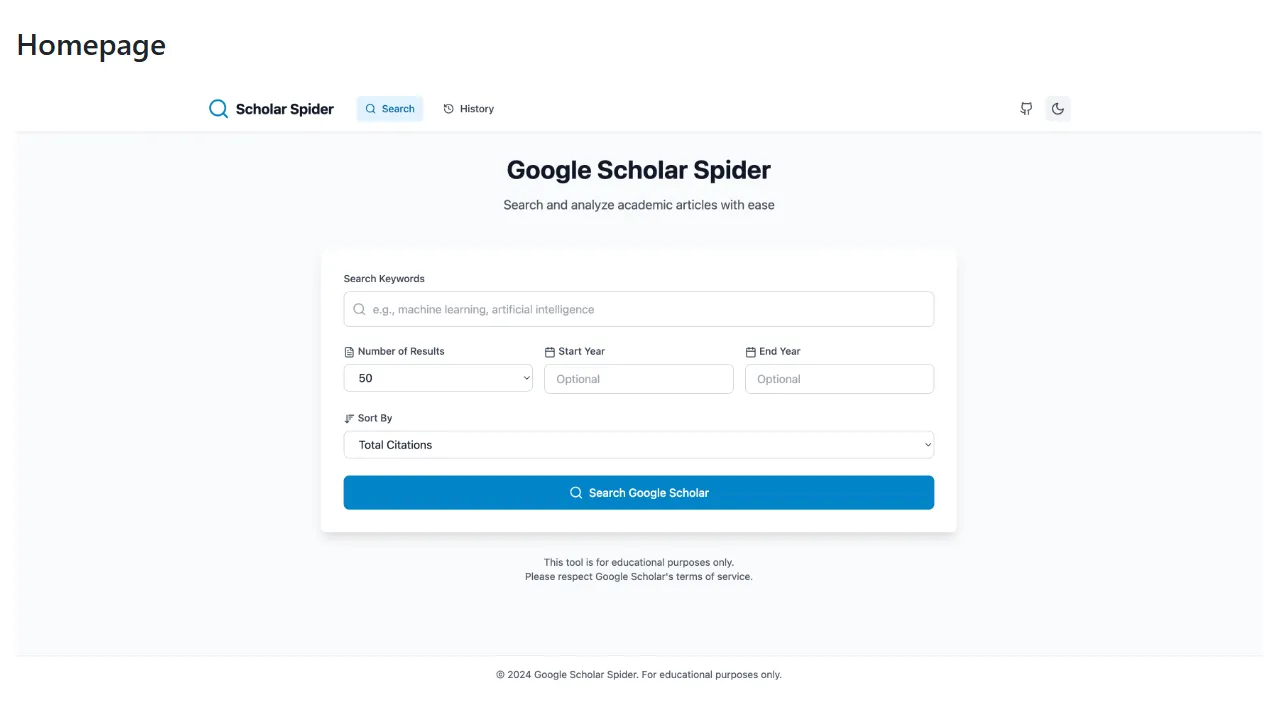
ScholarDock 是一个现代化的应用,旨在通过 Google Scholar 搜索和分析学术文章。
-
🔍 高级搜索:支持自定义参数搜索,按年份范围筛选,结果排序等功能,每次最多可查询 1000 条数据。
-
📊 数据可视化:提供引文趋势、出版分布的交互式图表,并支持实时数据筛选和探索。
-
💾 数据管理:SQLite 数据库存储搜索历史,支持导出成 CSV、JSON、Excel、BibTeX 格式,并可管理历史记录。
Awesome Black Hat Tools
https://github.com/UCYBERS/Awesome-Blackhat-Tools
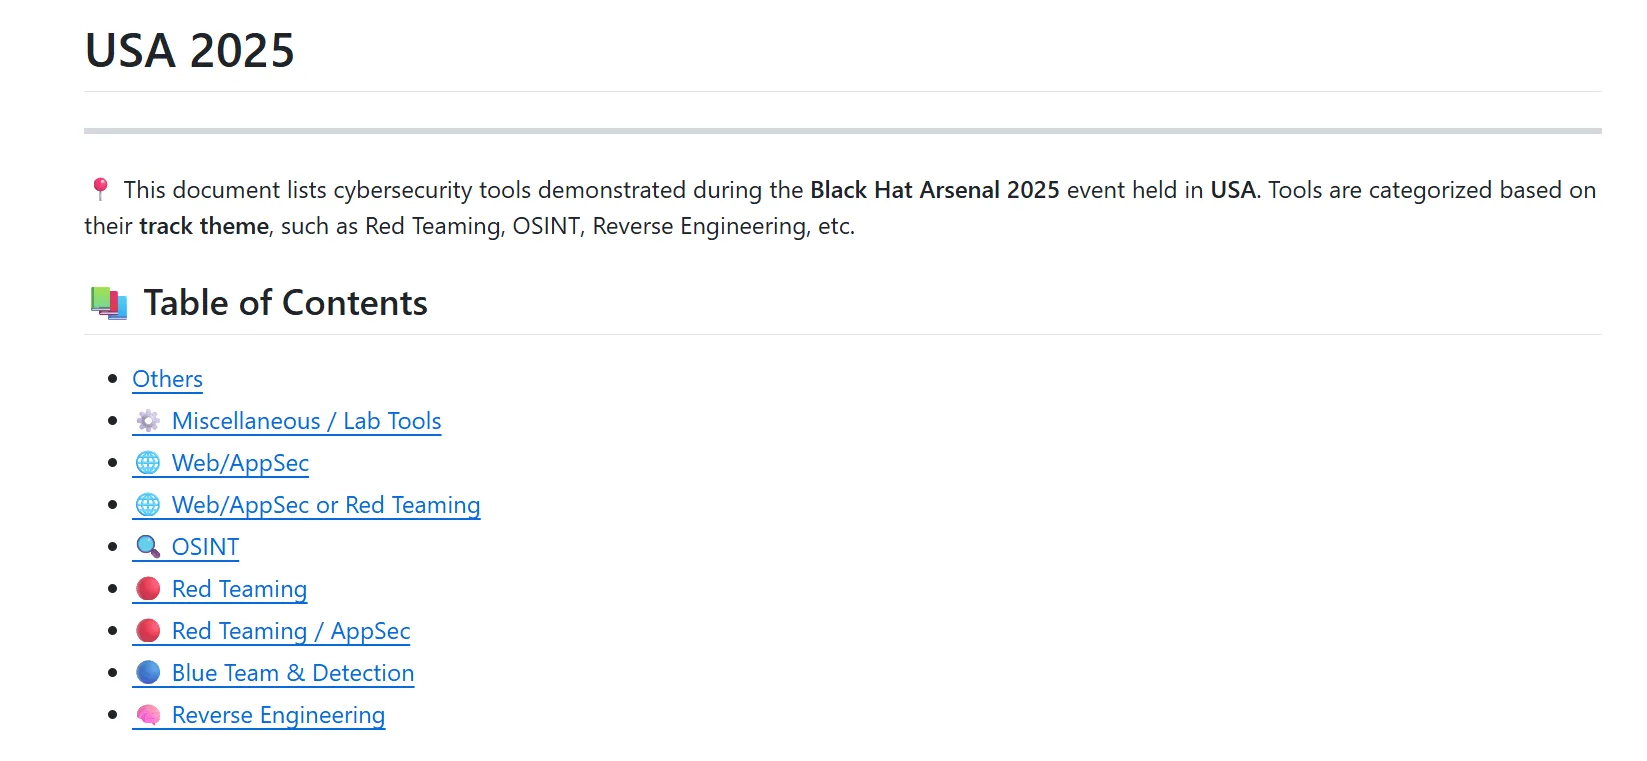
一系列曾在全球 Black Hat 安全大会上正式展示的网络安全工具资源库。这些工具涵盖了红队(Red Teaming)、蓝队(Blue Teaming)、开源情报(OSINT)、漏洞开发、恶意软件分析、数字取证与回应(DFIR)、威胁情报、工业控制系统(ICS/IoT)、应用安全(AppSec)等多个领域。
随便玩玩
Subscription Management
https://github.com/huhusmang/Subscription-Management
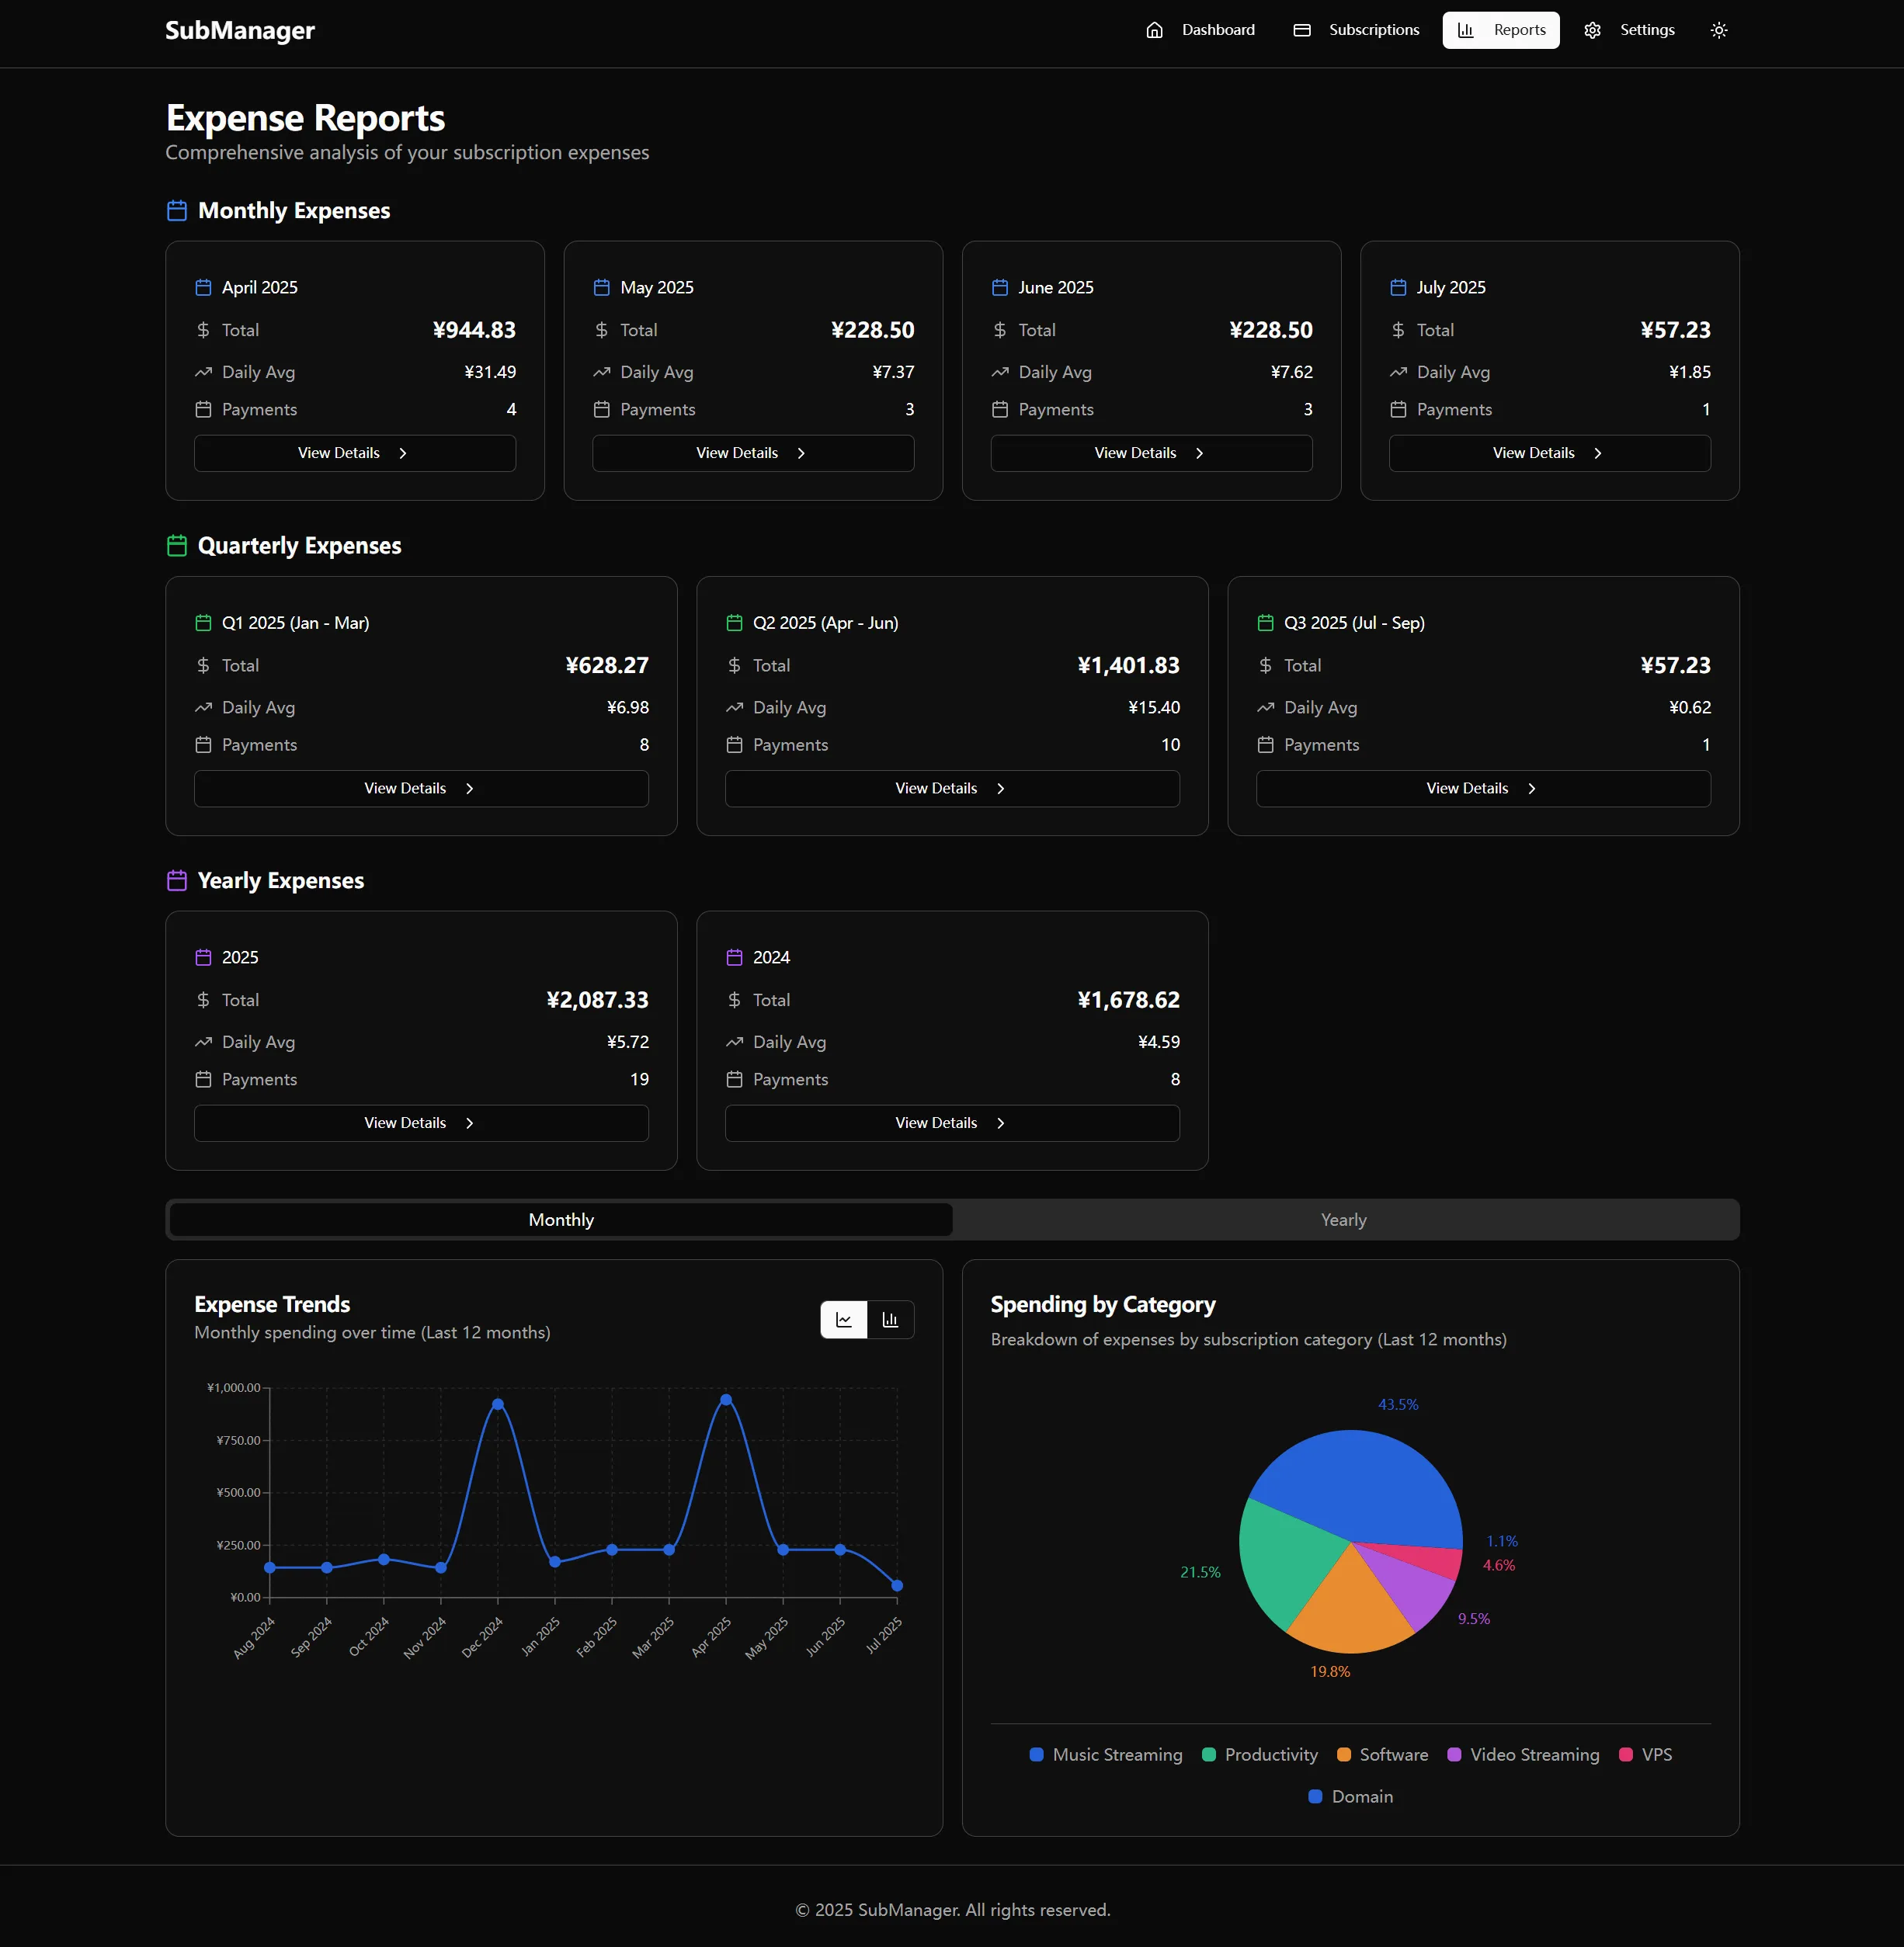
我自己 Vibe Coding 的一个现代化的订阅管理系统 🤪 😬,帮助用户轻松管理和跟踪各种订阅服务的费用和续订。想起来就提个需求让 AI 实现一下,虽然说是 Vibe Coding,但迭代到现在也经历了多次重构,因为 AI 在新增代码时不能很好的遵循高内聚、低耦合等开发原则,导致随着时间推移,重复代码片段过多、项目组织混乱等,所以需要进行多次重构,当然我不会 React 和 typescript,只是指导它重构。Vibe Coding 过程中较难的就是后端的一些处理逻辑吧,AI 给出的方案有时总是有些局限性,或者过于冗余复杂,所以需要自己给出比较好的处理逻辑。整个项目完成后,并没有学会 React 和 typescript,只是大致能看懂代码的逻辑,以及熟悉了 react 和 nodejs 的开发、调试流程等hhhh,有时间可以阅读学学代码 🤣。目前支持以下主要功能:
-
智能订阅管理:支持订阅服务的新增、编辑、删除,自动/手动续订管理。
-
费用分析报告:提供趋势图、分类统计和多维数据分析报告。
-
多币种支持:支持7种主要货币的实时汇率转换和自动更新。
-
智能仪表盘:展示月/年费用统计、即将到期提醒、分类费用分析等。
-
历史支付记录:记录详细的支付历史并支持CRUD操作。
-
响应式设计:支持桌面和移动端自适应。
-
本地优先:基于SQLite的本地数据存储,保护隐私。
-
Docker部署:一键部署,开箱即用。
AI Agents A-Z
https://github.com/gyoridavid/ai_agents_az
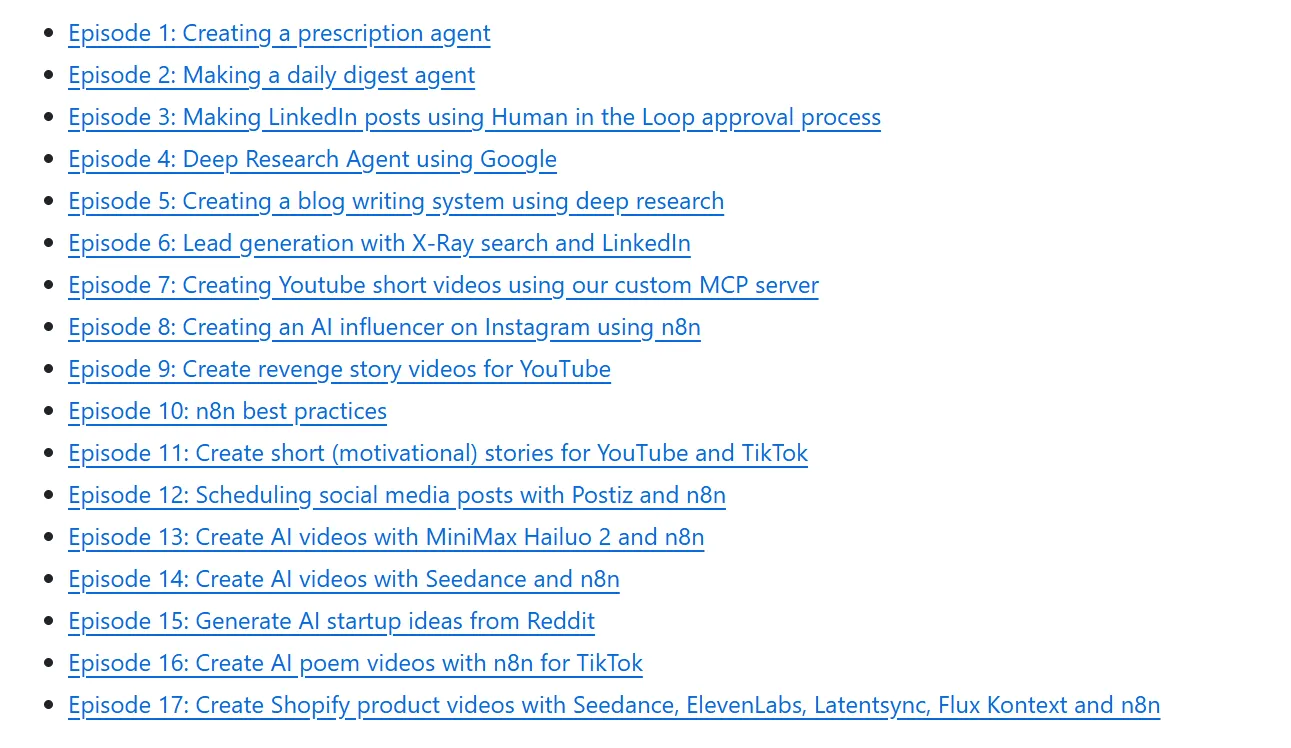
n8n 的模板和工作流,涵盖广泛的应用场景,例如处方生成、社交媒体内容制作、视频创建到电商产品视频生成等。
随便说说
要回所了,新的环境,不多说了,先回去感受一段时间