堆个月亮
🎶𝓦𝓮𝓮𝓴𝓵𝔂 𝓼𝓸𝓷𝓰 𝓹𝓲𝓬𝓴 🪗:
知识小品
Enhancing Vulnerability Detection via Inter-procedural Semantic Completion (ISSTA 2025)
https://dl.acm.org/doi/10.1145/3728912
⚙️ 问题
现有的基于深度学习的漏洞检测方法,为了保证可扩展性,通常在函数级别进行分析。然而,这种设计存在一个关键限制:许多漏洞的产生和触发横跨多个函数调用。函数级方法由于无法获取被调用函数的内部语义(即“跨程序语义”),导致难以捕捉到这类真实的漏洞模式,从而造成漏报。例如,一个函数内部可能调用了另一个函数来释放内存,之后又在原函数中再次释放,导致“二次释放”漏洞,如果不分析被调用函数的具体行为,就无法发现此问题。
💡 创新
为了解决上述问题,该论文提出了一个名为 VulnSC 的通用框架。其核心创新点如下:
-
通用性跨程序语义增强框架:旨在将跨程序分析集成到现有学习型漏洞检测方法中的通用框架,它在增强检测能力的同时,保持了原方法的可扩展性。
-
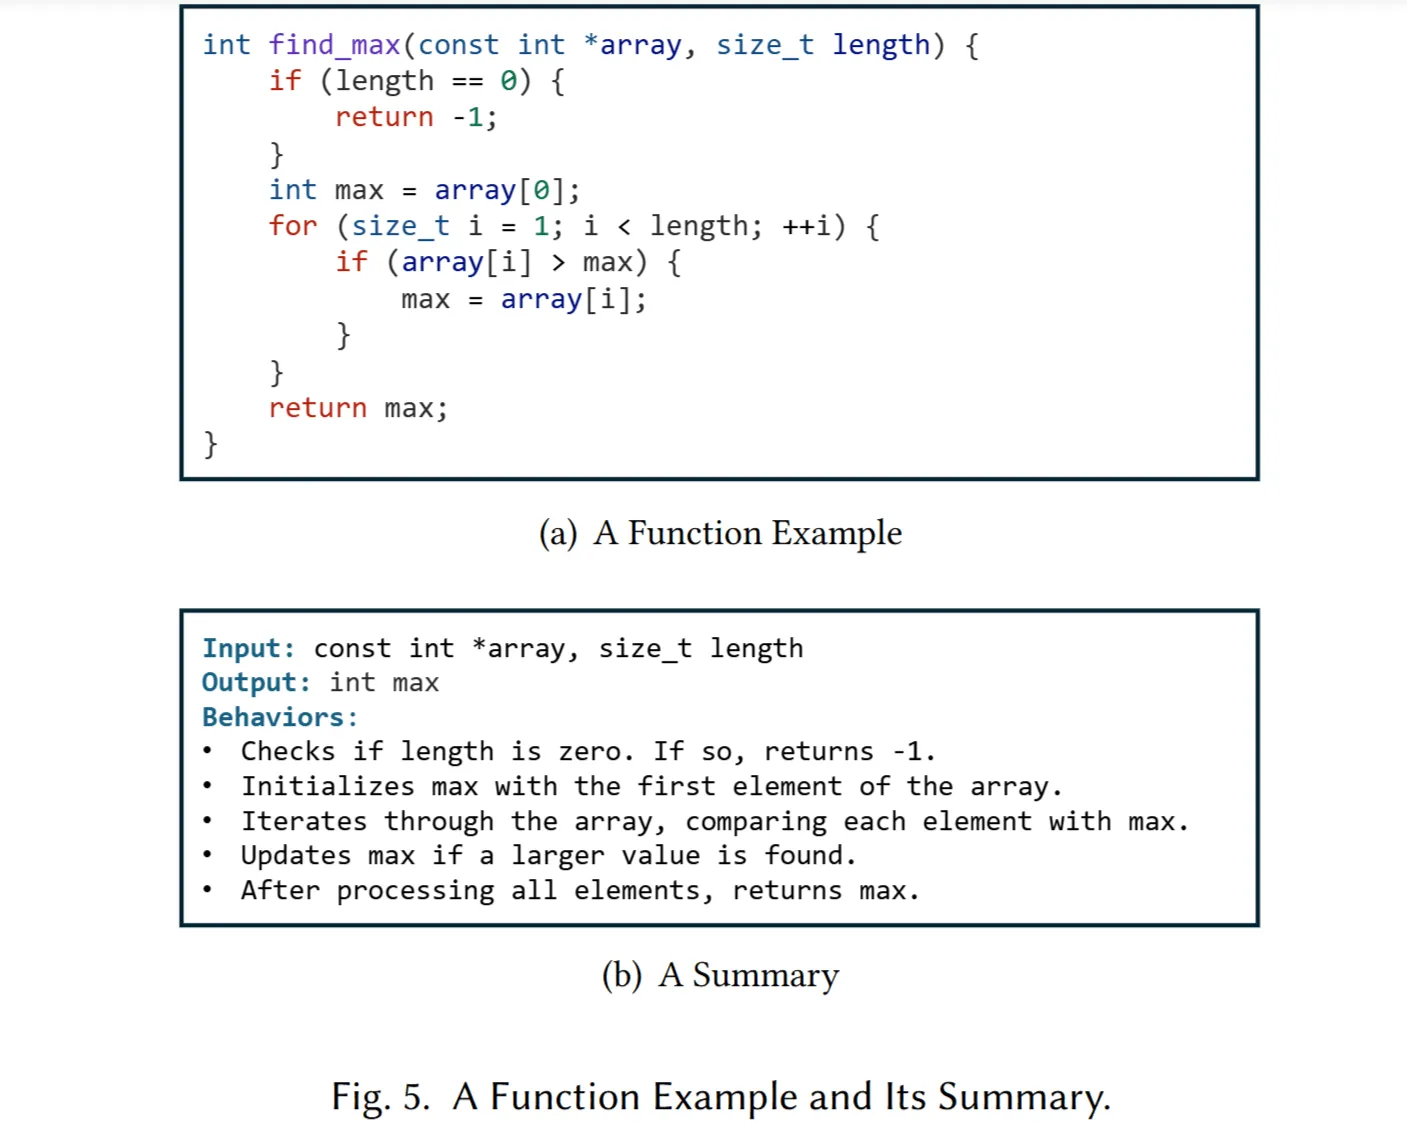
利用大语言模型进行语义补全:框架不直接分析被调用函数的复杂代码,而是利用大语言模型的代码理解和总结能力,为被调用函数生成简洁的文本摘要。
-
摘要即注释:生成的摘要(包含函数输入、输出和关键行为)被当作注释,附加到原始代码样本中。这使得增强后的数据集可以直接被现有的、各种类型的学习模型使用,无需修改模型结构 。
-
自底向上的摘要生成算法:对于层层嵌套的函数调用,框架采用一种自底向上的算法。它首先为最深层的函数生成摘要,然后将摘要内容合并到调用它的上一层函数中,再为上一层函数生成摘要,如此往复,直到所有被直接调用的函数都获得了包含其深层调用行为的完整摘要。
👩🏻💻 方法
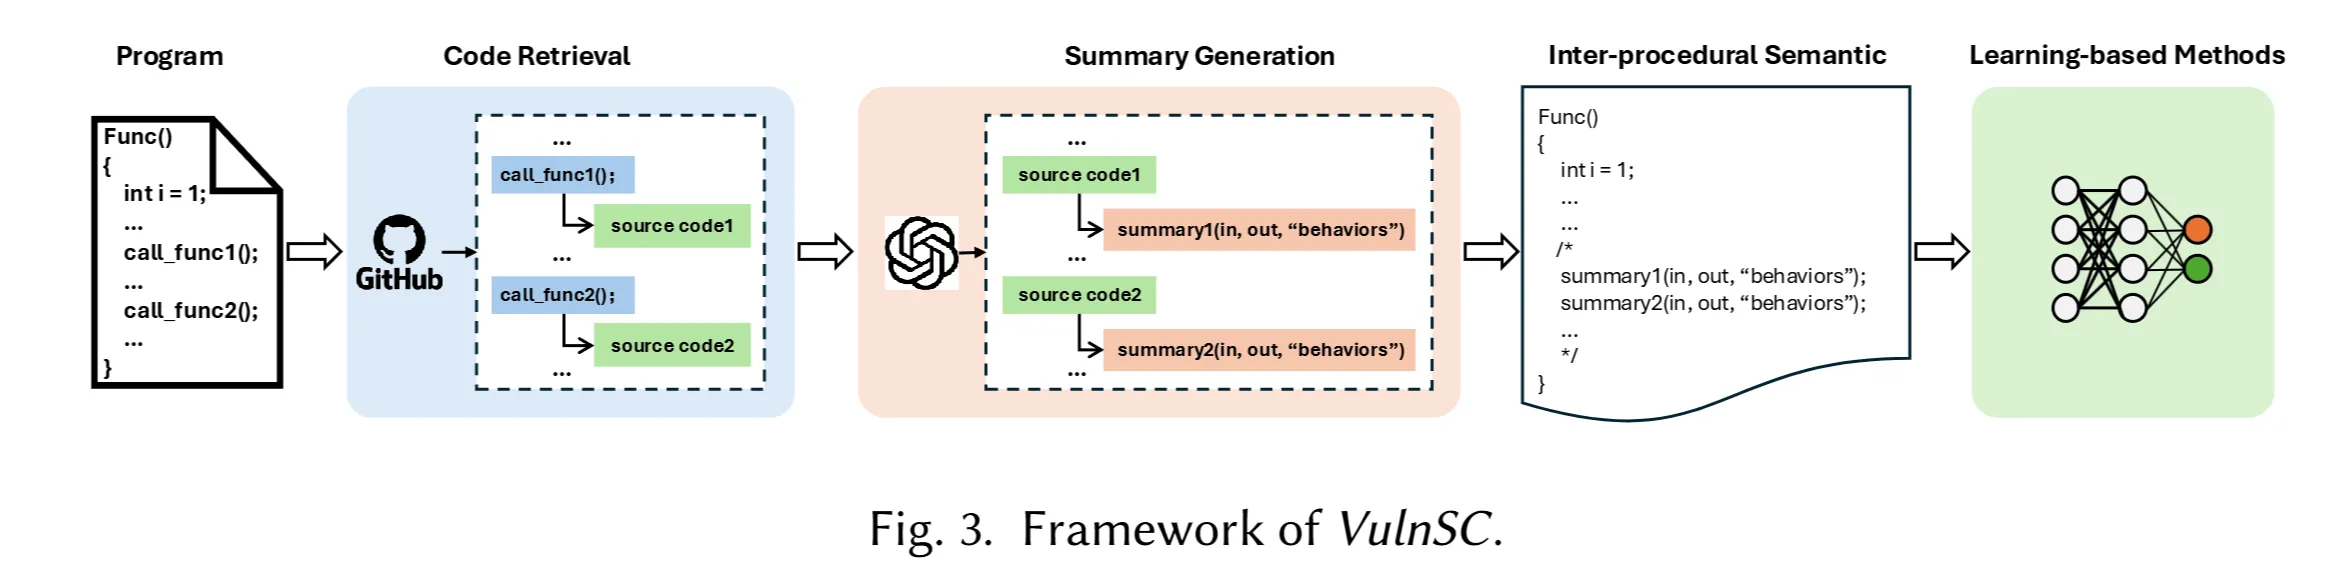
VulnSC框架的工作流程分为三个主要阶段,如下图所示:
-
代码检索
-
对于数据集中的每一个函数样本,利用其元数据(项目名和commit ID)在GitHub上定位到对应的代码仓库和版本。
-
构建该样本的函数调用图,递归地识别并提取所有被直接或间接调用的函数的源代码。
-
-
摘要生成
-
提示设计:为LLM设计了结构化的提示。系统提示设定LLM的角色和输出格式 (input, output, behavior)。用户提示则采用四种策略以应对不同需求:
-
基础提示:直接给出代码,要求生成摘要。
-
行为引导提示:提供 13 种与漏洞相关的行为类型,引导 LLM 重点关注这些行为。
-
One-shot提示:在提示中给出一个“代码-摘要”的示例,帮助 LLM 更好地理解任务。
-
思维链提示:在提示前加入“Let us think step by step”,鼓励LLM进行逻辑推理。
-
-
自底向上算法:对于一个包含多层函数调用的样本,算法从调用链的最末端(叶子节点)开始生成摘要,然后将摘要内容融入其父节点函数的代码中,再为父节点生成摘要,层层向上,最终得到包含所有子调用信息的顶层摘要。
-
-
Learning-based 集成
-
将为被调用函数生成的最终摘要,以注释的形式附加到原始代码样本的开头或结尾。
-
这些“语义增强”后的样本可以直接输入到任何现有的学习型漏洞检测模型中(如CodeBERT, GraphCodeBERT等)进行训练和检测。
-
🔬 实验
-
能否提升检测性能?VulnSC 显著提升了所有模型的性能。在 Devign 数据集上,准确率最高提升 4.73 个百分点;在 Big-Vul 数据集上,F1 分数最高提升 5.09 个百分点。一个有趣的发现是,基线模型性能越差,VulnSC 带来的提升越明显。
-
LLM选择和提示策略有何影响?GPT-4o 和 DeepSeek 带来的提升最大。提示策略方面,“思维链” 和 “行为引导” 策略在多数情况下效果更好。
-
可扩展性如何?集成 VulnSC 只带来了极小的计算时间开销,而 GPU 显存占用完全没有增加。这种开销远小于升级到一个更复杂模型所带来的资源消耗。
📜 结论
论文提出了一种名为 VulnSC 的新颖框架,旨在解决现有 Learning-based 漏洞检测方法因可扩展性问题而忽略跨程序语义的局限性。该框架通过利用 LLM 生成被调用函数的代码摘要,并将其整合到原始样本中,有效地为模型补充了缺失的跨程序信息。在两个广泛使用的数据集上对四种 SOTA 模型进行的实验表明,VulnSC 在仅引入极小计算开销的情况下,显著提升了漏洞检测的性能。
LoRA Hyperparameters Guide
https://docs.unsloth.ai/get-started/fine-tuning-guide/lora-hyperparameters-guide
unsloth 发布一篇博客介绍了 LoRA(Low-Rank Adaptation)的超参数调整技巧,以及这些超参数如何影响大型语言模型的微调过程。它提供了调整 LoRA 超参数的最佳实践,并解释了这些调整如何影响模型的准确性、稳定性、质量以及减少模型在微调过程中的过拟合和欠拟合。
Reinforcement Learning Guide
https://docs.unsloth.ai/basics/reinforcement-learning-guide
一份强化学习的指南,包括 RL 的基础知识、环境、代理、行为、奖励函数等概念的解释。详细介绍了 GRPO 算法如何在 Unsloth 平台上应用,以及如何通过模拟、奖励函数来训练 RL 模型。
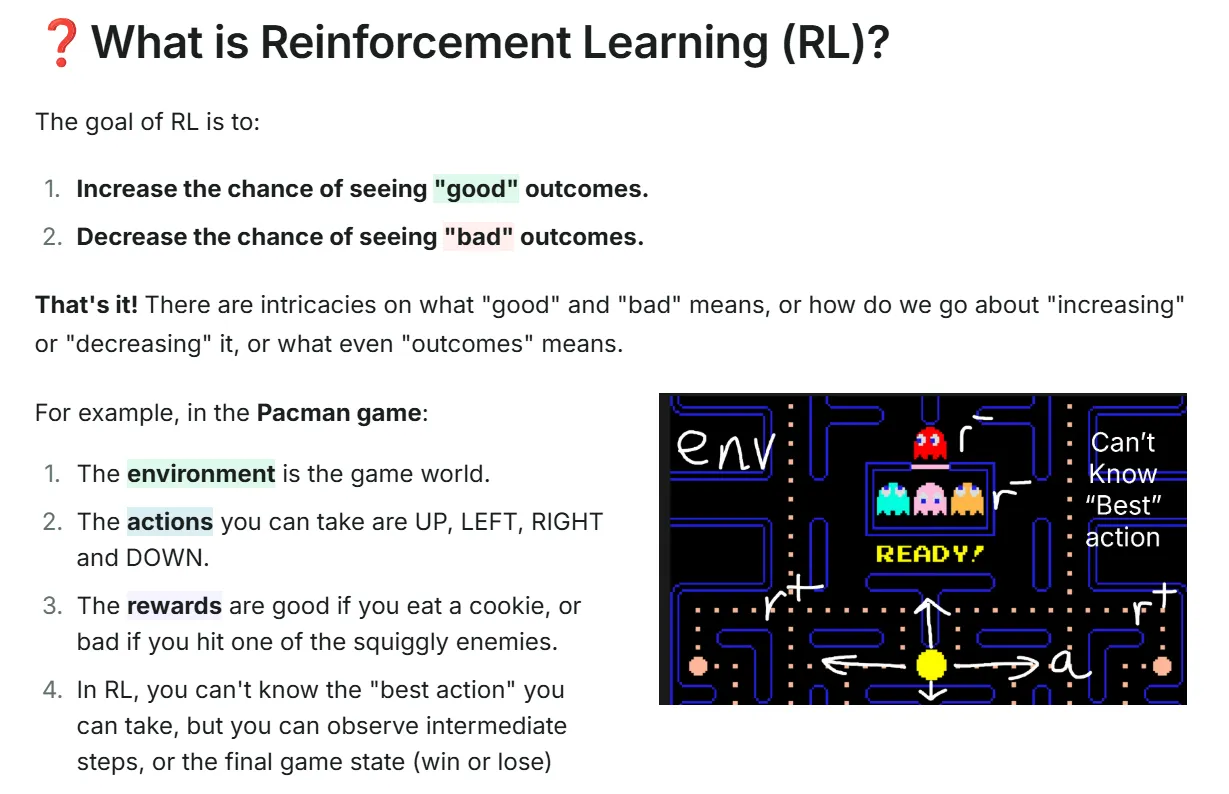
MCP如何工作
https://blog.cong.moe/post/2025-06-17-ai-and-mcp/
这篇文章里的示意图,能让我很清晰的阐述了 MCP 是如何工作的,同时附上作者的原阐述:
从全局交互/抽象层面来看,MCP其实是把用户一次对话请求拆分成两次/多次底层对话请求:
将用户消息和mcp tool元信息合并发送给大模型
大模型根据用户消息和云信息决定是否需要/使用哪个 tool call,并且从用户输入中提取所需参数
发起mcp tool调用,将结果和用户消息合并再次发送给大模型
得到结果返回给用户
MCP server主要职责是:
我能做什么: 通过meta信息告诉大模型自己有几个工具能力,分别能做什么
怎么让我做事: 进行特定工具调用时需要哪些参数,该怎么传递参数
做事: 按照参数要求与现实世界交互,返回结果
LeetCUDA
https://github.com/xlite-dev/LeetCUDA
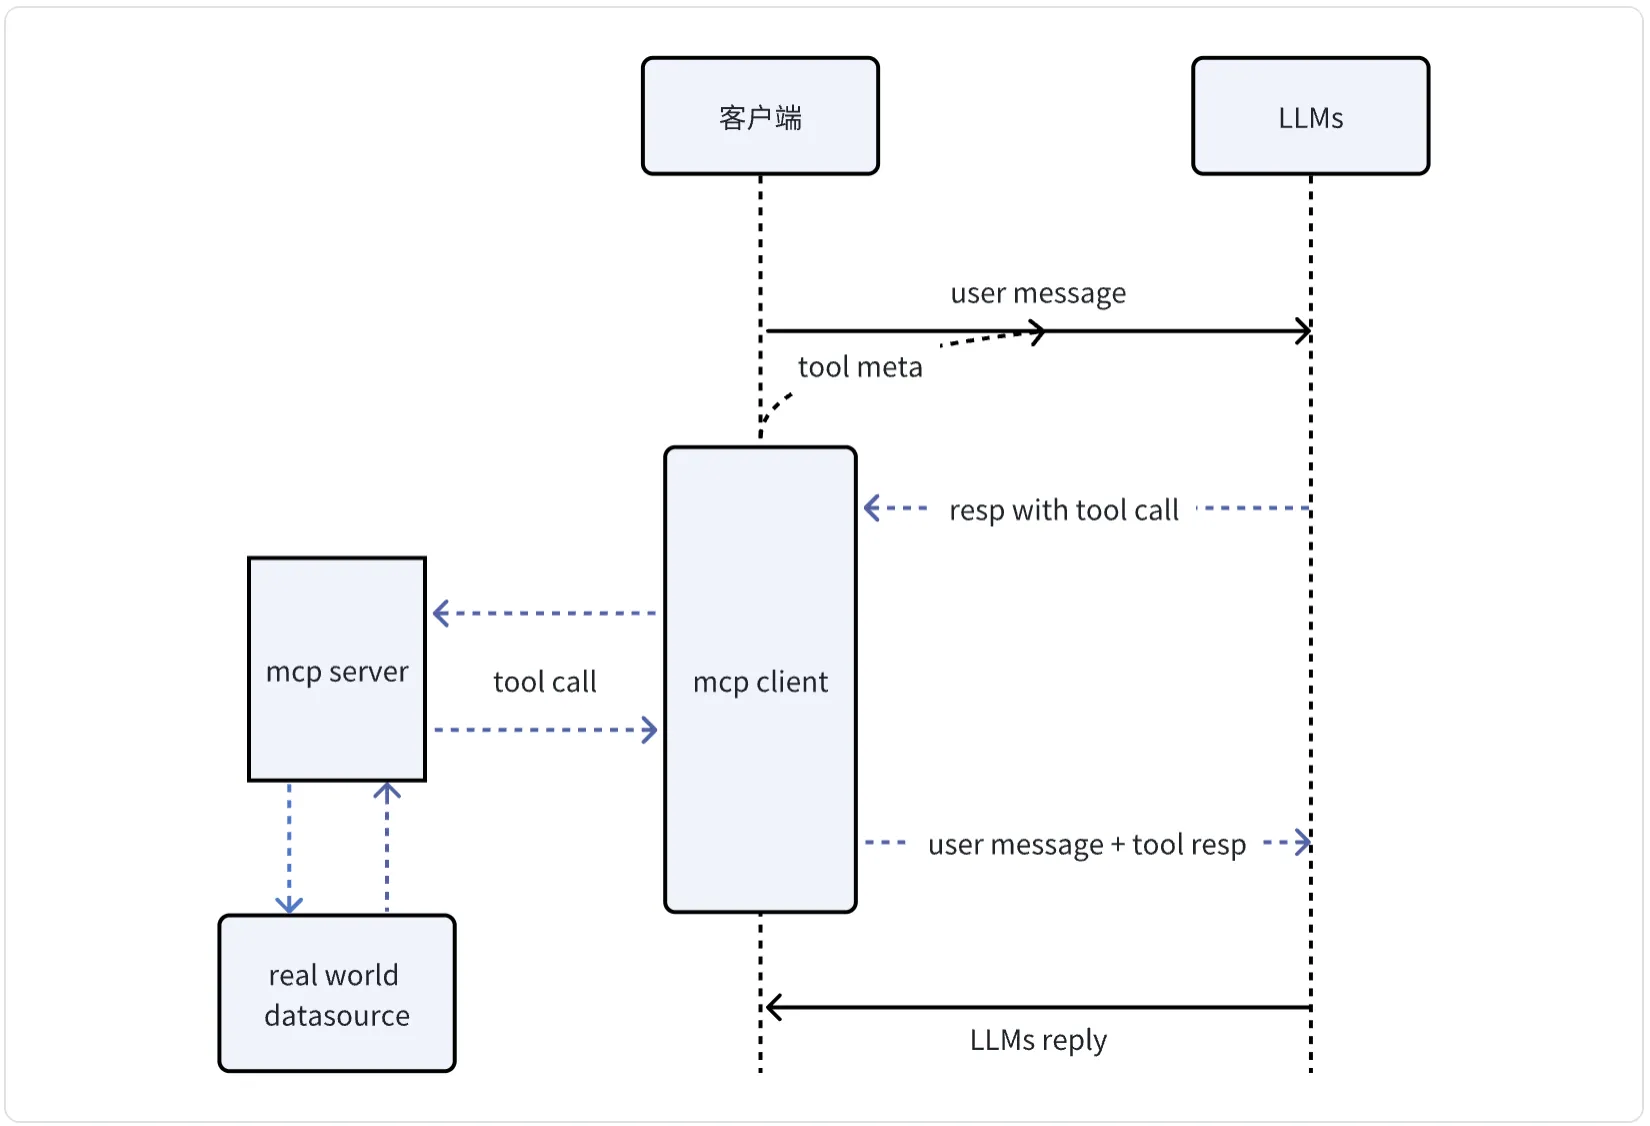
LeetCUDA 是一个基于 PyTorch 的现代 CUDA 学习仓库,专为初学者提供全面的 CUDA 学习笔记和教程,包含 200+ CUDA/Tensor Core 内核与 100+ 高性能计算相关博客。核心内容涵盖 Tensor Core 用法、TF32/F16/BF16/F8 类型支持、HGEMM 高性能矩阵乘法、FlashAttention 优化、多种切片与平铺方法等,提供详细的 CUDA 内核实现难度进阶指南(从 Easy 到 Hard++)。该项目通过 CUDA/Tensor Core 示例、高性能算法创新(如 FFPA-Attention)以及分布式深度学习支持,为开发者提供深度学习相关的高性能计算优化技术,并实现近 cublas 极限性能的优化效果。
-
涵盖 200+ CUDA 内核,支持多精度类型,包括 WMMA、MMA 等 Tensor Core API。
-
提供深入的 FlashAttention 和矩阵乘法(HGEMM)优化及实现。
-
包括 100+ 技术博客,覆盖 CUDA 编程、FlashAttention 实现等深度学习领域优化知识。
-
提供详细的代码示例、深度优化指南,支持从入门到进阶的全流程学习。
Outlines
https://github.com/dottxt-ai/outlines
Outlines 是一个用于大型语言模型结构化输出的开源库,依赖 JSON、正则表达式、Pydantic 等方式预定义生成结构,同时支持多种模型(如 OpenAI、Ollama、本地模型等)之间无缝切换,增强输出稳定性与可预测性。主要功能包括多选约束、函数签名推断结构、正则输出验证以及复杂语法规则支持。项目提供简单集成接口:通过指定期望输出类型即可确保生成结果符合预期结构。
from pydantic import BaseModel
from enum import Enum

class Rating(Enum):
    poor = 1
    fair = 2
    good = 3
    excellent = 4

class ProductReview(BaseModel):
    rating: Rating
    pros: list[str]
    cons: list[str]
    summary: str

review = model(
    "Review: The XPS 13 has great battery life and a stunning display, but it runs hot and the webcam is poor quality.",
    ProductReview,
    max_new_tokens=200,
)

review = ProductReview.model_validate_json(review)
print(f"Rating: {review.rating.name}")  # "Rating: good"
print(f"Pros: {review.pros}")           # "Pros: ['great battery life', 'stunning display']"
print(f"Summary: {review.summary}")     # "Summary: Good laptop with great display but thermal issues"
json_repair
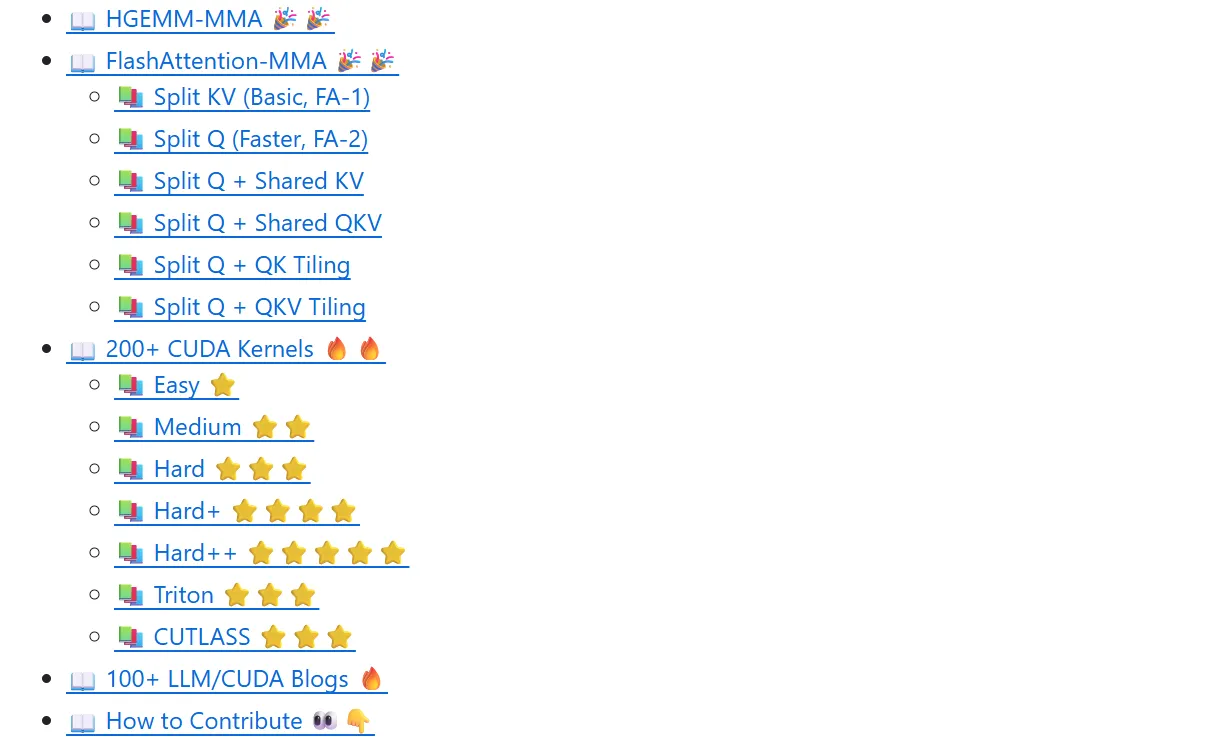
json_repair 是一个用于修复无效 JSON 字符串的轻量级 Python 库,尤其适用于大语言模型生成的错误 JSON 数据。其核心功能包括修复语法错误(如缺失引号、逗号、未转义字符等)、修复格式错误的 JSON 数组或对象,以及自动填充缺少的 JSON 值。
-
无需额外依赖,适配主流 JSON 操作场景。
-
提供多种用法,如
repair_json()、替代json.loads()和json.load()等。 -
提供 CLI 工具支持 JSON 文件修复。
-
支持非拉丁字符处理及性能优化设置。
随便看看
sec-papers-collection
https://github.com/c01dkit/sec-papers-collection
收集顶级学术会议上的安全相关论文,并根据会议和日期进行分类,支持的会议包括 IEEE S&P、USENIX Security Symposium、ACM CCS、NDSS,还包含与安全相关的软件测试会议 ICSE 和 ISSTA。
看了下代码,数据来源有三种优先级:
-
最高优先级:官方数据文件。如果配置了 official_file(如 oakland24.csv),系统会优先使用这些预先下载好的、格式相对规整的文件。
-
次高优先级:网页抓取。如果没有官方文件,系统会通过 HTTP 请求抓取指定 URL 的网页内容。
-
API调用:通过调用 IEEE Xplore 的 API 来获取数据,这些数据通常会被保存为 CSV 文件,供后续处理。
code-graph-rag
https://github.com/vitali87/code-graph-rag
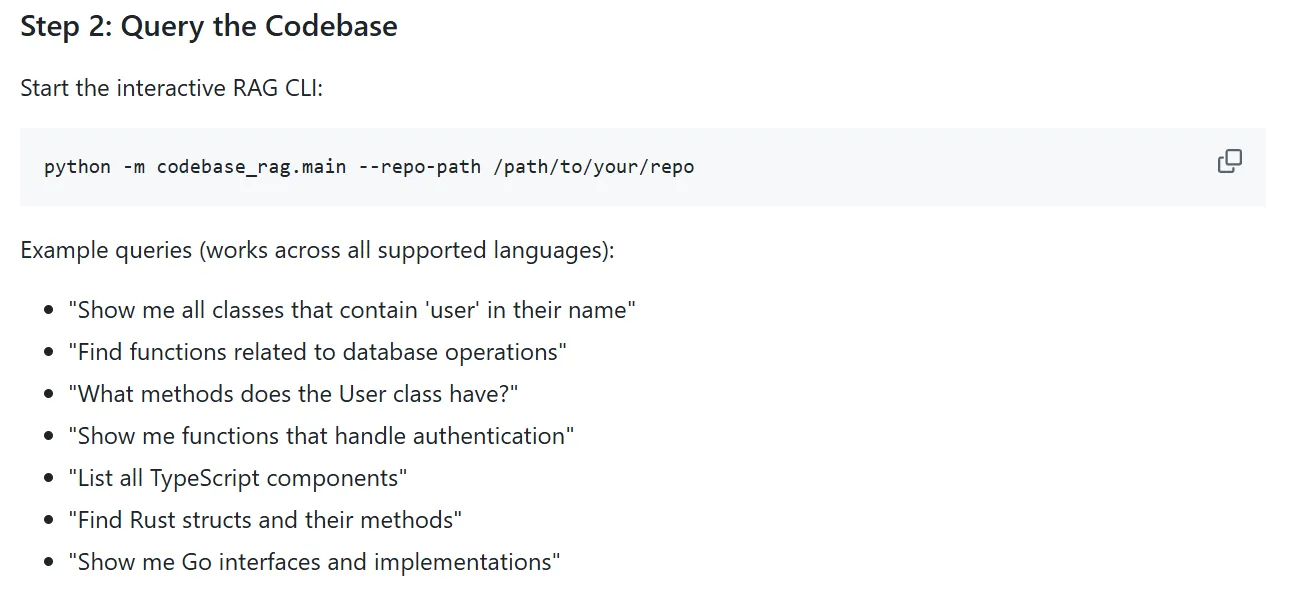
code-graph-rag 是一个用于分析多语言代码库的图结构检索增强生成系统。该项目基于 Tree-sitter 解析代码,利用 Memgraph 构建知识图谱,并支持通过自然语言查询代码库结构及其关系。
-
多语言支持:支持 Python、JavaScript、TypeScript、Rust、Go、Scala、Java 等语言。
-
Tree-sitter 解析:语言无关的抽象语法树解析。
-
知识图谱存储:利用 Memgraph 存储代码库结构及关系,支持复杂代码查询。
-
自然语言查询:通过 Google Gemini,将自然语言转换为 Cypher 查询。
-
代码片段检索:可返回符合条件的代码片段。
-
依赖与层次分析:支持外部依赖解析及嵌套函数的分析。
随便玩玩
zotero-arxiv-workflow
https://github.com/AllanChain/zotero-arxiv-workflow
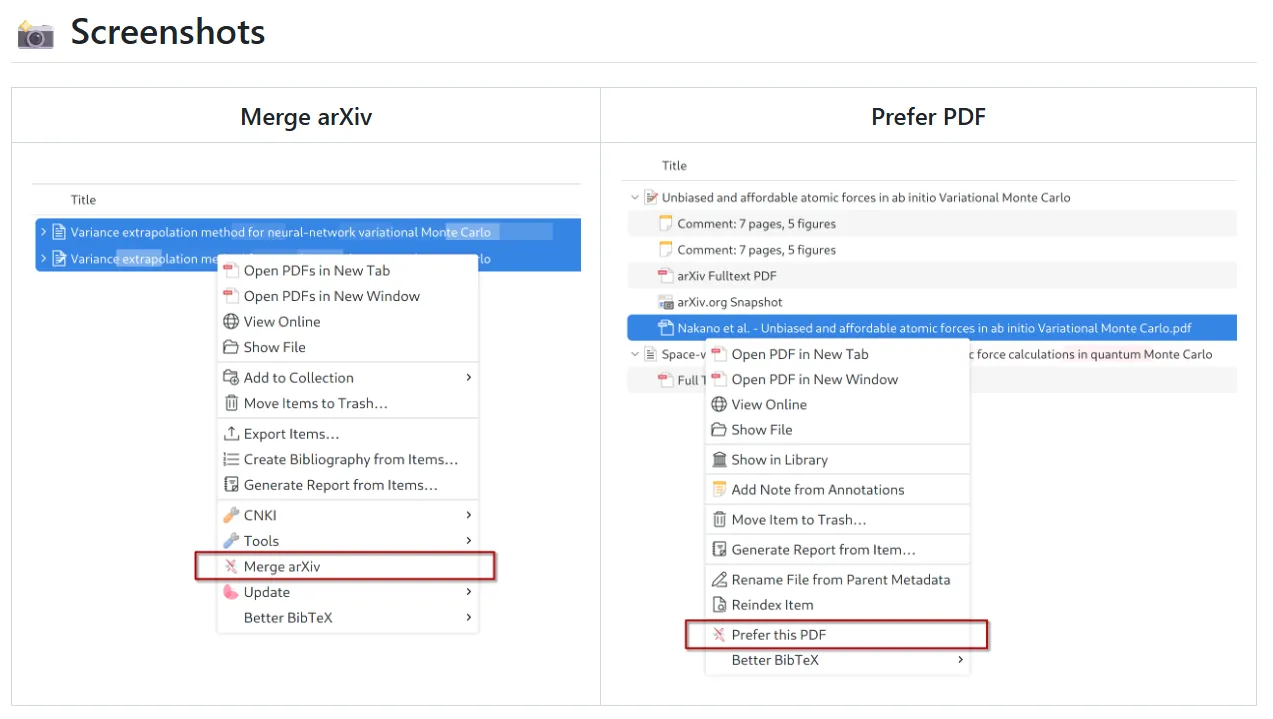
一个为 Zotero 提供的插件,用于简化管理 arXiv 论文的流程。其主要功能包括:
-
合并功能:无痛合并 arXiv 论文和已发表版本,支持保留两个版本的元数据、附件以及唯一 ID,解决 Zotero 原生不支持不同类型条目合并的问题。
-
首选 PDF 设置:可设置默认打开的 PDF,如需更改只需右键选择对应文件。
-
查找更新版本:支持通过 arXiv、Semantic Scholar API、DBLP API 查找已发表或更新版本,并自动更新元数据及附件。
-
下载最新 PDF:通过右键操作轻松下载已发表版本的 PDF(需期刊订阅)。
enhanced-FaaS-in-China
https://github.com/xingpingcn/enhanced-FaaS-in-China
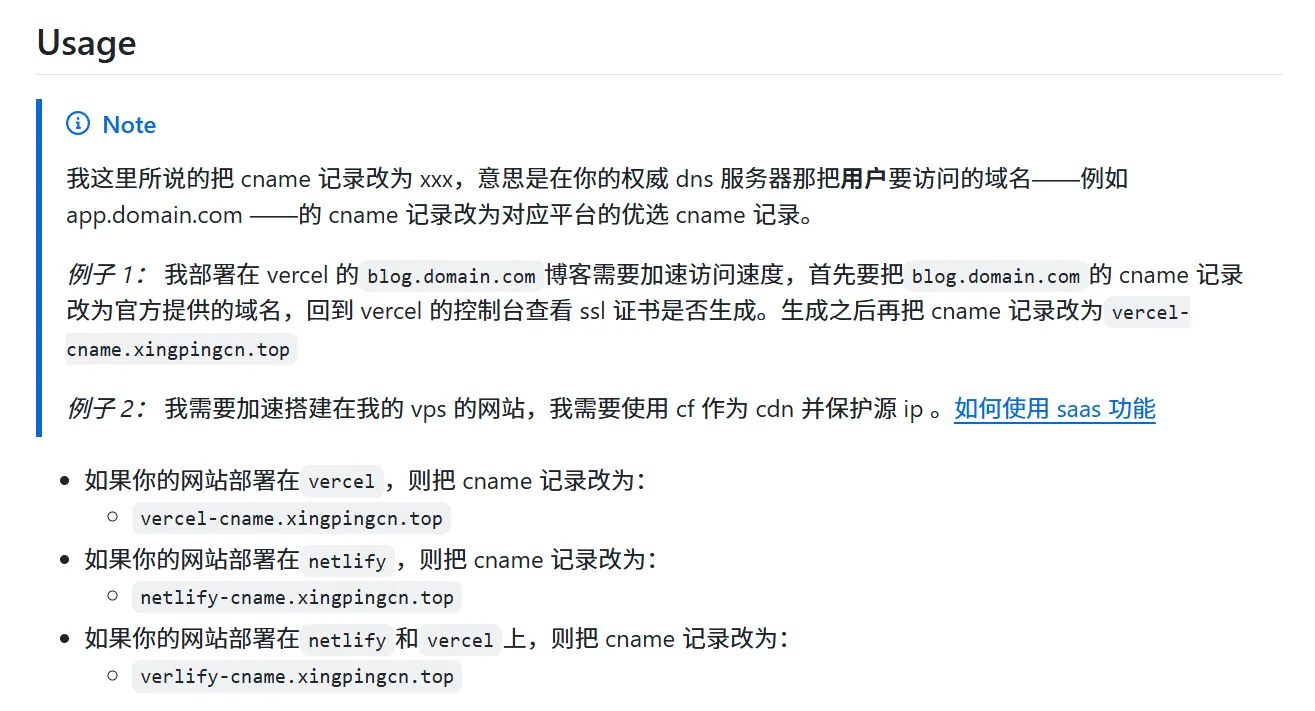
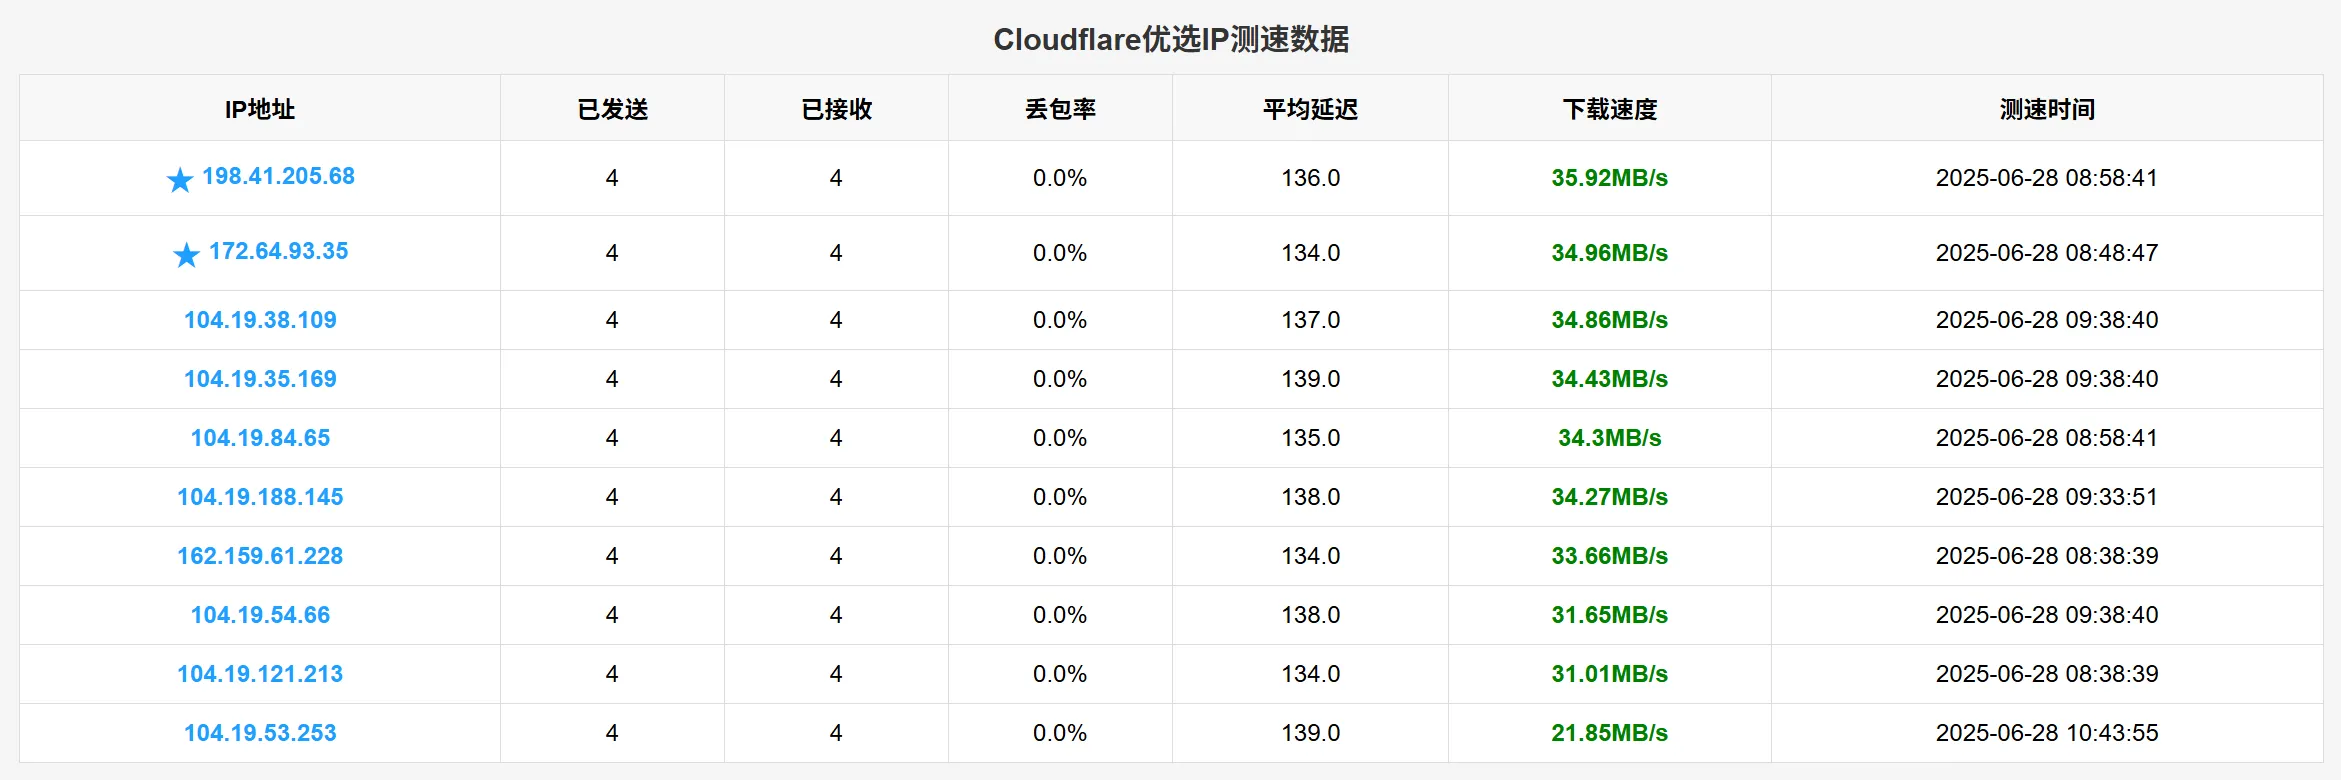
该项目旨在提升通过 Cloudflare、Vercel 或 Netlify 部署的网页在中国的访问速度和稳定性。项目提供了一种方法,通过更改 CNAME 记录来优化这些平台的访问,从而改善页面的响应时间和连接稳定性。此项目通过测试和选择最快且稳定的 IP,为各个平台的域名 A 记录提供优化,每 40 分钟更新一次。
cf-speed-dns
一个用于动态获取 Cloudflare 优选 IP 的工具,通过 CloudflareSpeedTest 定期推送优选 IP 列表以确保最快的 CDN 延迟和速度。用户可以通过其提供的实时更新页面和接口,查看优选 IP 和 Top IP 列表。
CF 优选 IP 指的是通过特定方法筛选出那些对于特定地区(尤其是中国大陆)用户访问速度最快、延迟最低、连接最稳定的 Cloudflare CDN 节点 IP 地址。这个过程旨在优化网站或服务的访问体验。
cpdown
https://github.com/ysm-dev/cpdown
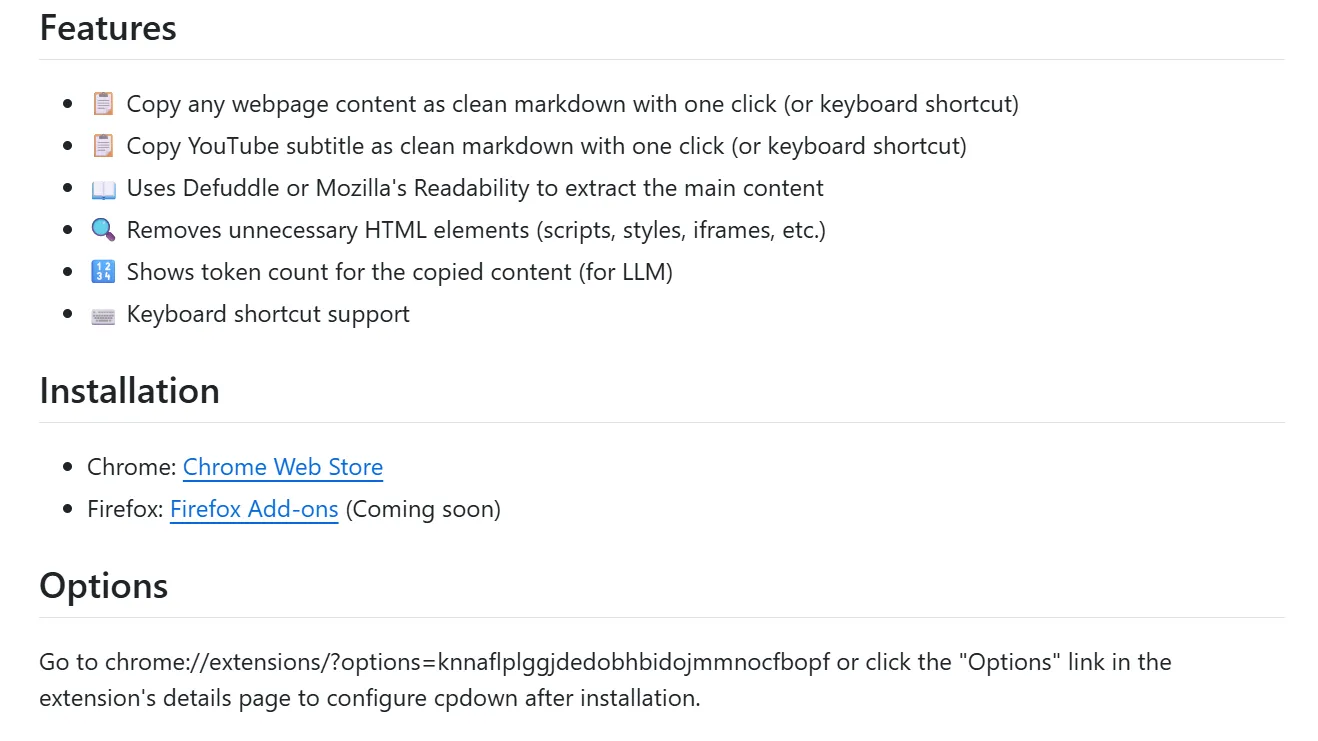
cpdown 是一个浏览器扩展,可将任何网页内容或 YouTube 字幕快速复制为干净的 Markdown 格式,提供单击操作或键盘快捷键支持。功能包括提取主要内容、移除多余 HTML 元素、显示语料字数统计,并支持配置多种选项,支持在 Chrome 和 Edge 上安装,Firefox 版即将推出。
Bandwidth Test
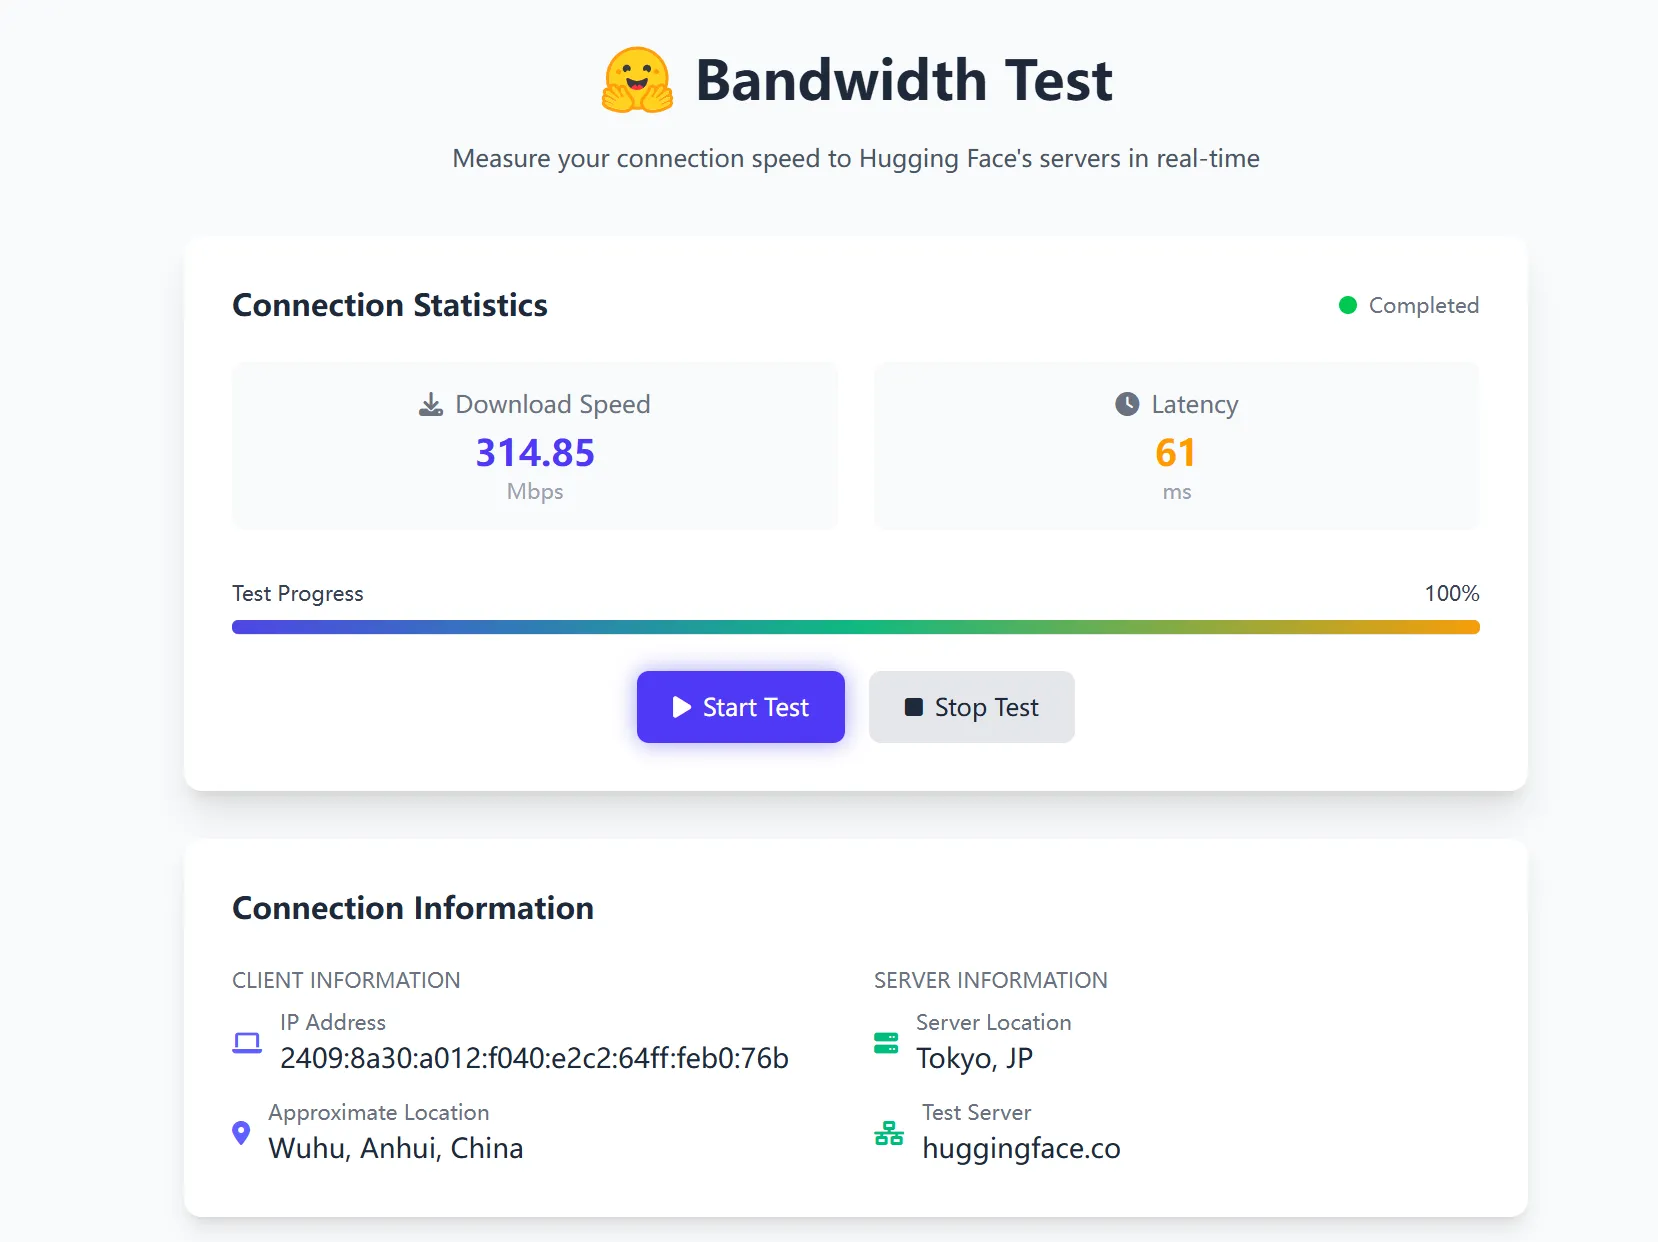
Hugging Face 提供了一个实时测量连接速度的工具,用于检测用户到其服务器的连接速度。(家里网速还挺快的哈~
人类之光
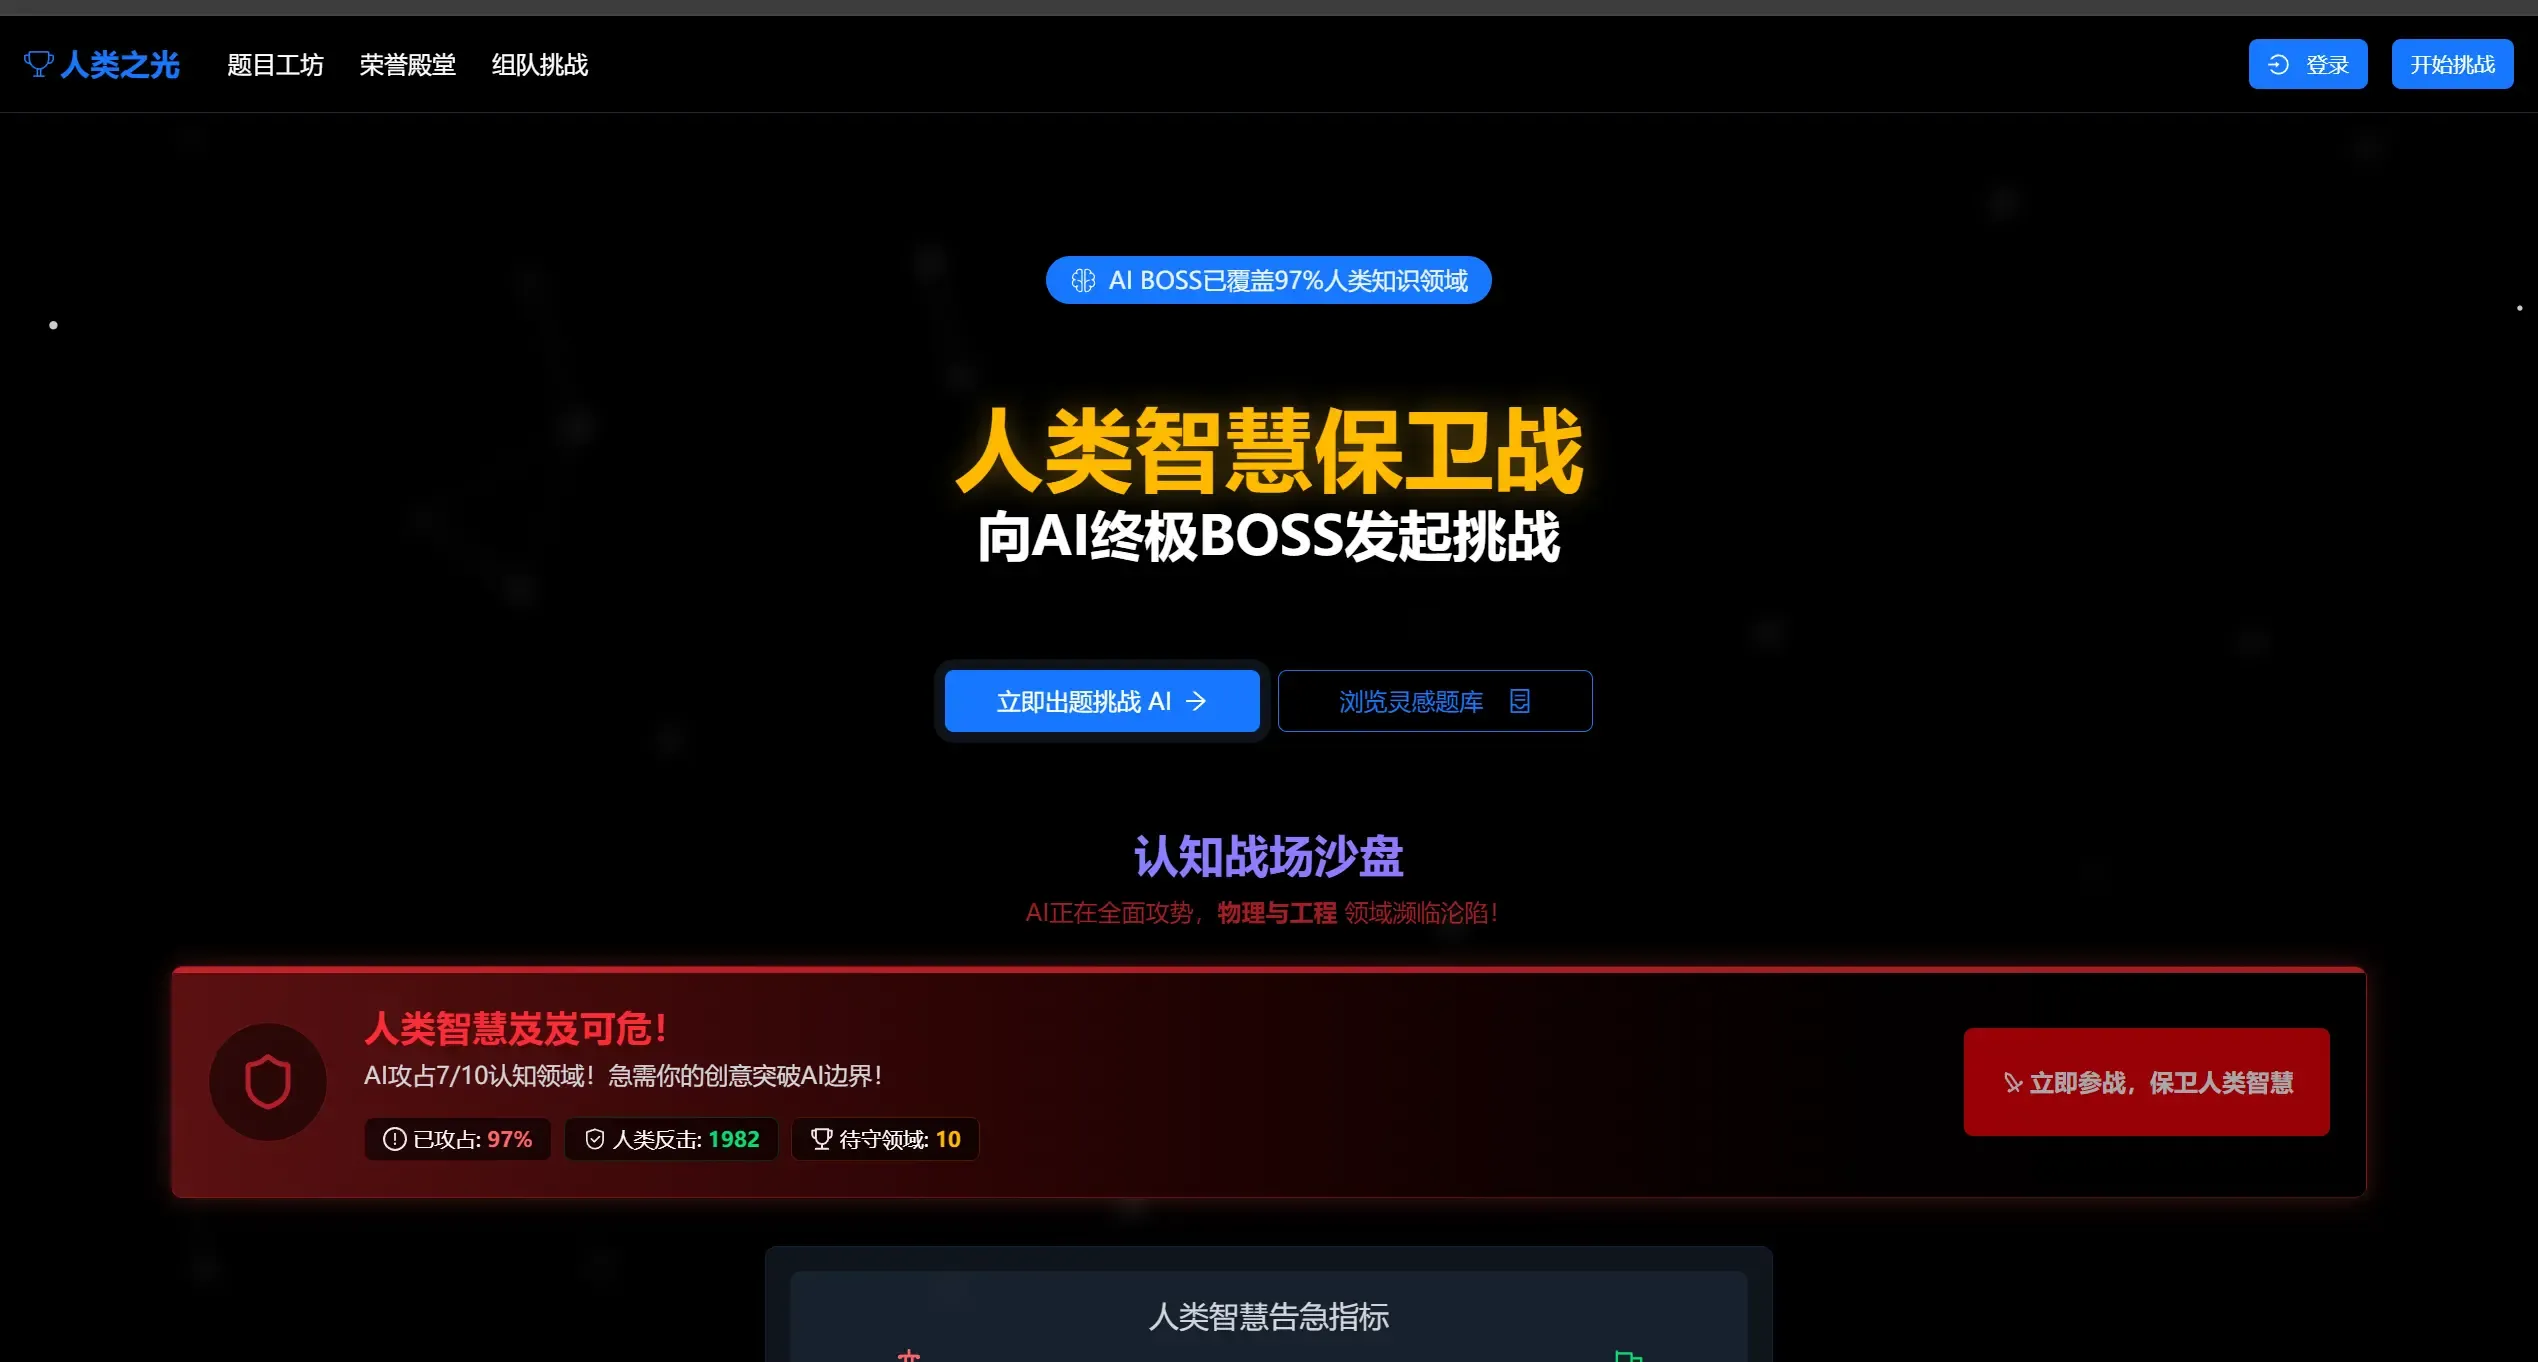
网站提供了一个平台,让用户通过提出问题来挑战各种 AI 模型,网站主题和样式做的还挺符合的。想法是有趣的,但是题目质量参差不齐,好像并没有太多审核~
随便说说
最近把周刊从博客里单独分出来了,使用了 gitbook 主题,还挺符合周刊形式记录的。博客就单独来写一些文章,这样博客就不会全是周刊了 😂
最近右腿腹股沟位置和大腿前侧位置疼,和两年前的状况一样,不过这次还好一些,没有情况坏到无法走路。在放假回家之前就有一些酸,无法做一些大幅度的腿部动作。回家之后以为多休息就好了,但时间长更痛了,晚上无法入睡……家里医疗条件不好,所以去徐州最好的医院挂了骨科的号,腿部按压不痛,也没有肿胀,腿部力量也有的,医生判断腿没啥大问题,怀疑我是不是椎间盘突出,让我去做了磁共振。(被送进太空舱之前,医生给我带上了耳机,我也闭上了眼睛。随着仪器启动,巨大的轰鸣声、敲击声、嗡嗡声来回交替,老实说还是有点吓人的,还好时间不是很长)检测结果显示我的脊椎很好,没有凸出,只是原本应该前凸的脊椎稍微有些变直。但脊柱周围有个地方出现了水肿,医生说这不会出现压迫神经的问题,腿疼可能就是滑膜炎或者损伤,有炎症,最后确实也是吃点消炎药好了;至于水肿的问题,医生让我两个月复查一次,检查水肿有无退去。哎,原来我偶尔的腰痛原来是水肿导致的,也确实是片子显示的那个位置,还得好好养养腰,还得奋斗好久呢🫠
折腾部署好了自己的摄影 gallery,想要所有服务白嫖,免不了折腾😂,不过折腾好是挺满意的~
半天 vibe coding 了一个个人的订阅管理服务,react + nodejs,真的是一点没学过,纯自然语言 Coding,但,真不喜欢🙁…
-
不熟悉的语言、框架和项目,导致不能很好的给出 instruction,无法精准描述自己的需求,自然 get 不到好的结果(这里特指从 0 到 1 之后的项目修改阶段)
-
报错看不懂,只能一味的截图和复制,但总觉着还是缺点什么。UI 是动态交互的,这种 bug 截图和控制台错误并不能很好描述,但自己也不懂(=_=)。所以改 bug 很难,也是最痛苦的,因为生成的代码没用,项目越改越乱,越臃肿…
-
自己不能定位是哪几个模块出了问题。我还是喜欢精准打击,找出 bug 涉及的相关文件然后让 AI 修复,但纯 vibe coding 我做不到,我看不懂代码的作用以及之间如何交互的
所以,纯 vibe coding 一个不熟悉的编程语言且稍微复杂的项目,我暂时(AGI 真的来了呢😊)认为还是挺难的