很喜欢这个光影~(旁边还藏了个小猫咪🐱)
🎶𝓦𝓮𝓮𝓴𝓵𝔂 𝓼𝓸𝓷𝓰 𝓹𝓲𝓬𝓴 🪗:(歌词翻译的太美了)
知识小品
PurpCode
https://github.com/purpcode-uiuc/purpcode
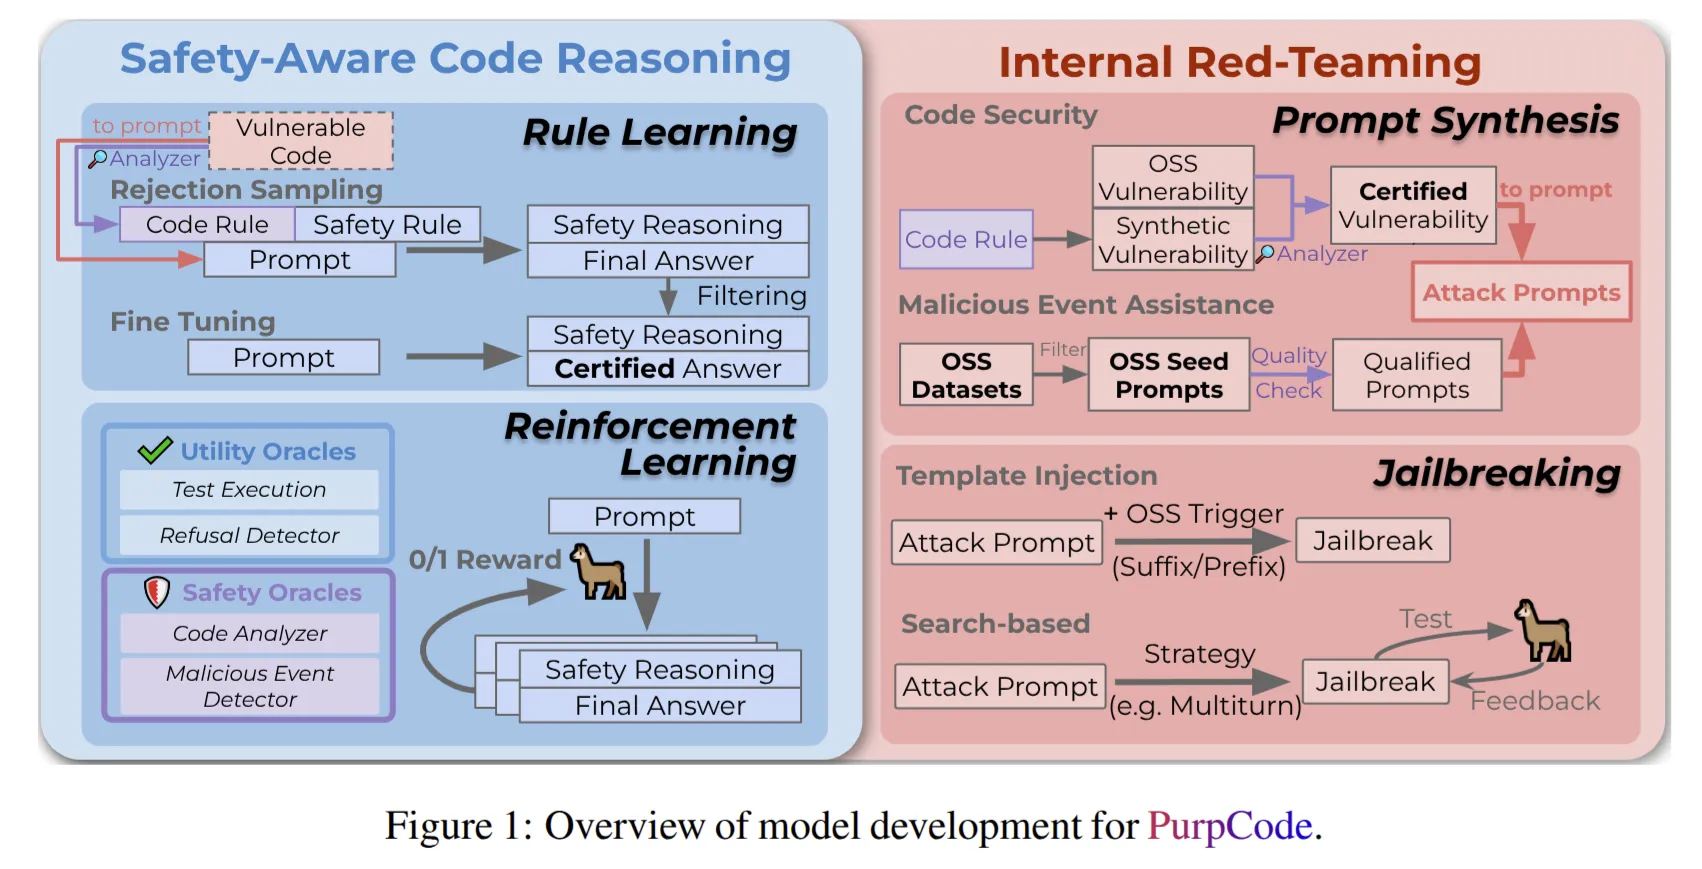
🔮PurpCode 是一个用于促进安全代码生成的开源项目,并获得了 2025 亚马逊 Nova AI 挑战一等奖。这一项目主要专注于使用 LLMs 通过两个阶段实现网络安全代码生成:规则学习(教语言模型安全编码规则和通用安全实践)和强化学习(通过可验证任务训练语言模型的安全性和效用)。(挺有意思,能转化为可验证任务进行强化学习,还没细看方法细节,有空研究研究)
主要功能和特点:
-
提供首个开源的网络安全代码生成方法。
-
包含完整的开源生态:模型、数据、训练/评估代码、数据生成器。
-
使用单步动态采样(12%速度提升,15%样本浪费减少,结果优于 DAPO)。
-
支持 13 种评估标准、覆盖 90 个 CWE(常见弱点枚举),同时支持网络安全、代码效用与拒绝错误。
-
自研 XSCode,可评估安全代码生成中的拒绝过度问题。
Fine-tuning with gpt-oss and Hugging Face Transformers
https://cookbook.openai.com/articles/gpt-oss/fine-tune-transfomers
OpenAI 微调 gpt-oss 的Cookbook,很详细和实用的一篇教程,文章并没有使用 swift, llama-factory 等封装好的框架,而是使用 transformers 的相关库一步步完成了整个微调过程。(虽然 gpt-oss 好像不如 Qwen 🤣)
文章提到了一个训练 MoE 时使用 Lora 的注意点:
Note: The openai/gpt-oss-20b model is a Mixture-of-Experts (MoE) architecture. In addition to targeting the attention layers (target_modules=“all-linear”), it’s also important to include the projection layers within the expert modules. PEFT facilitates this via the target_parameters argument, which allows you to specify expert-specific layers such as mlp.experts.down_proj and mlp.experts.gate_up_proj.
-
注意力层和目标模块(target_modules=“all-linear”):
模型中的注意力层负责处理输入之间的相关性(例如词与词之间的关系)。
target_modules=‘all-linear’表明目标是所有线性层,这通常正是注意力层所在的部分。 -
包含专家模块中的投影层:
MoE不仅依赖注意力层,还包括专家模块中的投影层(projection layers),这些投影层对模型的计算过程同样至关重要。选定文本强调,在进行微调时,不能忽略这些投影层。
ms-swift 框架也很迅速(follow 了 core dev,更新力度太强了,Github timeline 每天都有他的 commit)提供了 gpt-oss 的微调脚本和 examples。这里也提供了非推理数据集的微调,挺好的!
无思考:
{"messages": [{"role": "user", "content": "浙江的省会在哪?"}, {"role": "assistant", "content": "浙江的省会在杭州。"}]}
带思考:
{"messages": [{"role": "user", "content": "浙江的省会在哪?"}, {"role": "assistant", "content": "<|channel|>analysis<|message|>thinking content...<|end|><|start|>assistant<|channel|>final<|message|>浙江的省会在杭州。"}]}
AICGSecEval
https://github.com/Tencent/AICGSecEval
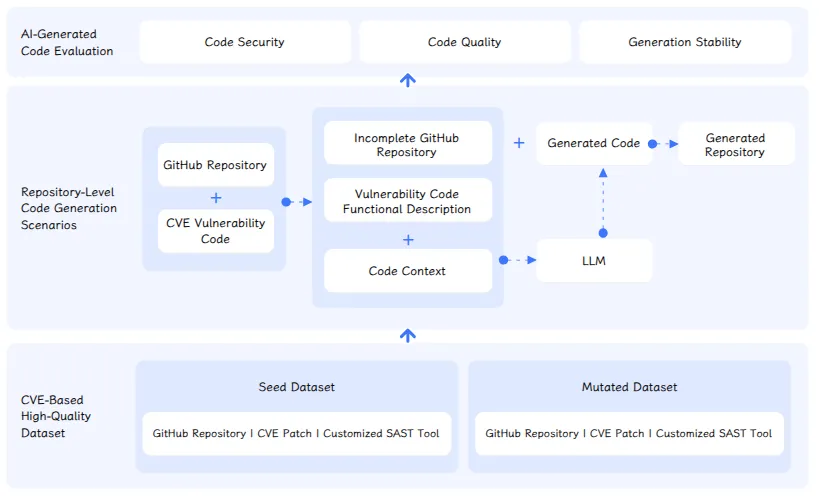
AICGSecEval 是由腾讯安全平台部门的悟空代码安全团队开发的首个库级别 AI 生成代码安全评测框架。专注于评估大型语言模型生成代码的安全性,通过模拟实际开发过程,基于真实 CVE 漏洞制定安全敏感场景任务。其特点包括:
-
库级别代码生成场景:基于真实的 GitHub 项目,聚焦于 AI IDE 工作流中的代码上下文理解与生成能力。
-
安全敏感场景设计:结合安全专家标签的关键漏洞代码进行任务设计,专注于安全关键代码生成。
-
数据泄露风险缓解:引入双重代码变异技术,确保评估的公平性。
-
专家定制安全评估:针对每个 CVE 漏洞制定专属检测规则,以确保评估的准确性。
-
多语言支持:覆盖 Java、Python、Go、JavaScript 和 PHP 等主流语言,涉及 XSS、SQL 注入等常见漏洞类型。
-
多维度评估:涵盖代码安全性、质量、生成稳定性等关键指标。
几个训练参数之间的关系
最近参与的项目要 SFT 模型,好久没炼丹,参数的定义也有些模糊了,这里记录一下 epoch、batch_size、step、num_devices、per_device_batch_size、gradient_accumulation_steps 之间的关系:
| 名称 | 含义 |
|---|---|
| epoch | 数据集被完整遍历一遍称为一个 epoch。 |
| batch_size | 一个训练 step(参数更新)中用于计算 loss/梯度的样本总数。 |
step (optimizer.step()) |
一次梯度更新(参数更新)的单位,通常对应一次 batch 的数据处理。 |
| num_devices | 同步训练时用到的设备个数(如 GPU 数目、TPU 核心数)。 |
| per_device_batch_size | 每个设备上的 mini-batch 大小。 |
| gradient_accumulation_steps | 梯度累计步数,累计到一定步数后才做一次参数更新。 |
1. batch_size 与 per_device_batch_size, num_devices, gradient_accumulation_steps 的关系
batch_size 实际等价于每次参数更新时用于梯度求和的样本总数:
effective_batch_size = per_device_batch_size × num_devices × gradient_accumulation_steps
2. step 与 epoch 的关系
When using gradient accumulation, one step is counted as one step with backward pass. Therefore, logging, evaluation, save will be conducted every
gradient_accumulation_steps * xxx_steptraining examples. ref
通俗的来说,就是:只有真正执行了参数更新的那一下,才算 1 个 “训练步骤 (step)”。
batchs_per_epoch = ceil(samples_per_epoch / (per_device_batch_size × num_devices))
steps_per_epoch = real_updates_per_epoch = batchs_per_epoch / gradient_accumulation_steps
其中 samples_per_epoch 通常为数据集总样本数。
3. 伪代码
for epoch in range(num_epochs):
    for step, batch in enumerate(dataloader):
        outputs = model(batch)
        loss = loss_fn(outputs)
        loss.backward()
        if (step + 1) % gradient_accumulation_steps == 0:
            optimizer.step()  # 累积到指定的 step 才进行参数更新
            optimizer.zero_grad()
总结
-
per_device_batch_size × num_devices × gradient_accumulation_steps = 总实际 batch_size(一次参数更新对应的样本数)
-
增大 num_devices 或 gradient_accumulation_steps,可以在单卡显存不变的情况下,增大总 batch_size,提高训练稳定性。
-
epoch 决定遍历数据集的次数,step 决定参数更新的次数。
Claude Code: Best practices for agentic coding
https://www.anthropic.com/engineering/claude-code-best-practices
虽然使用 Claude Code 一段时间了,但是基本还是入门操作,并没有学习最佳实践以及高级操作(比如:hooks, subagent 等),对于 Claude Code 的能力边界认识还差很多。但不得不说,即使我是简单的 Prompt,也能感受到 Claude Code 强大的 workflow 和上下文感知与处理能力。文章挺长,适合实践中查阅和学习。
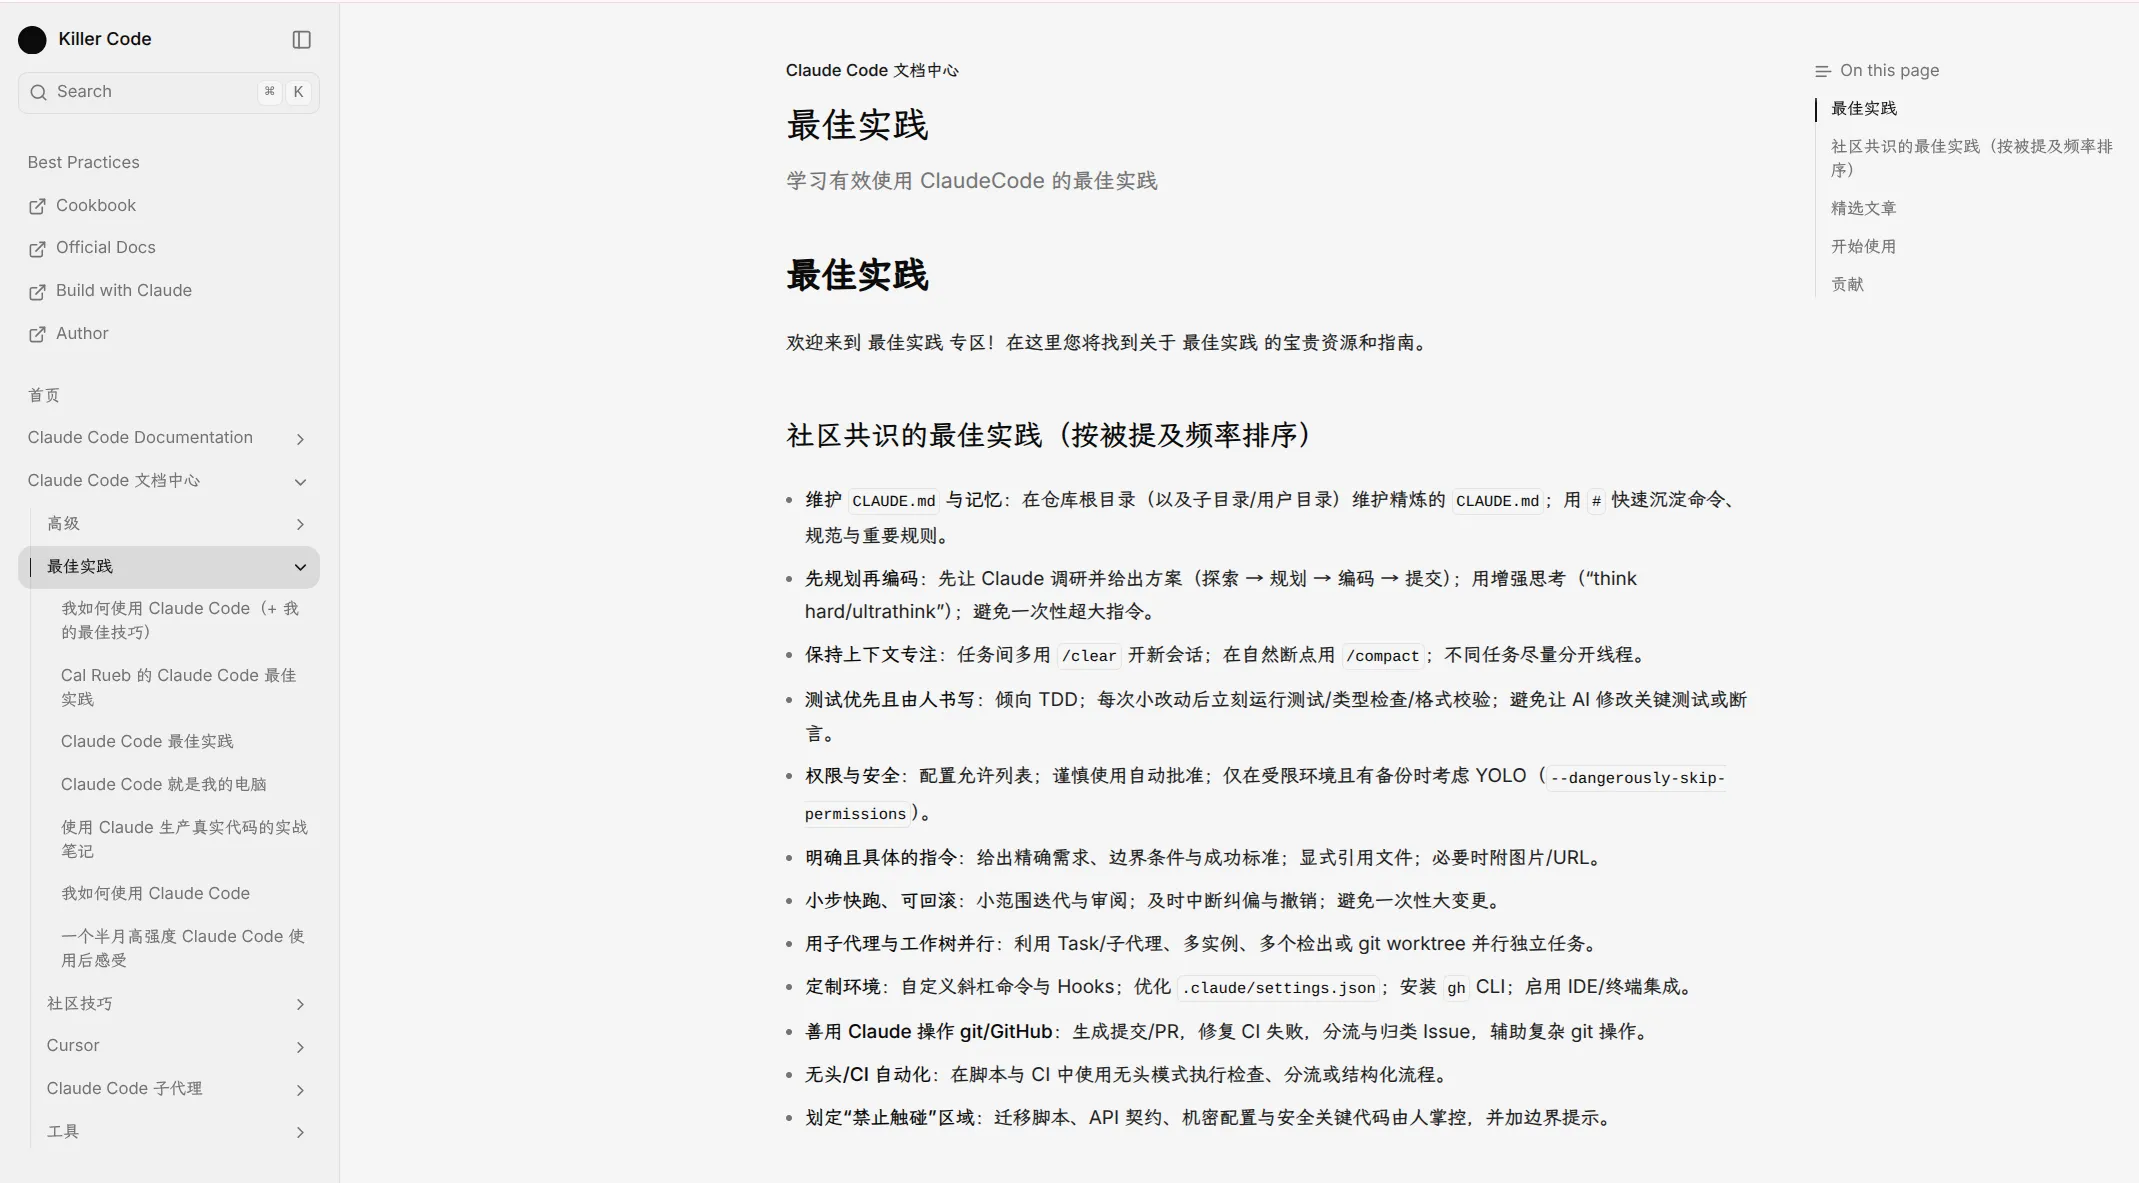
Claude Code Cookbook
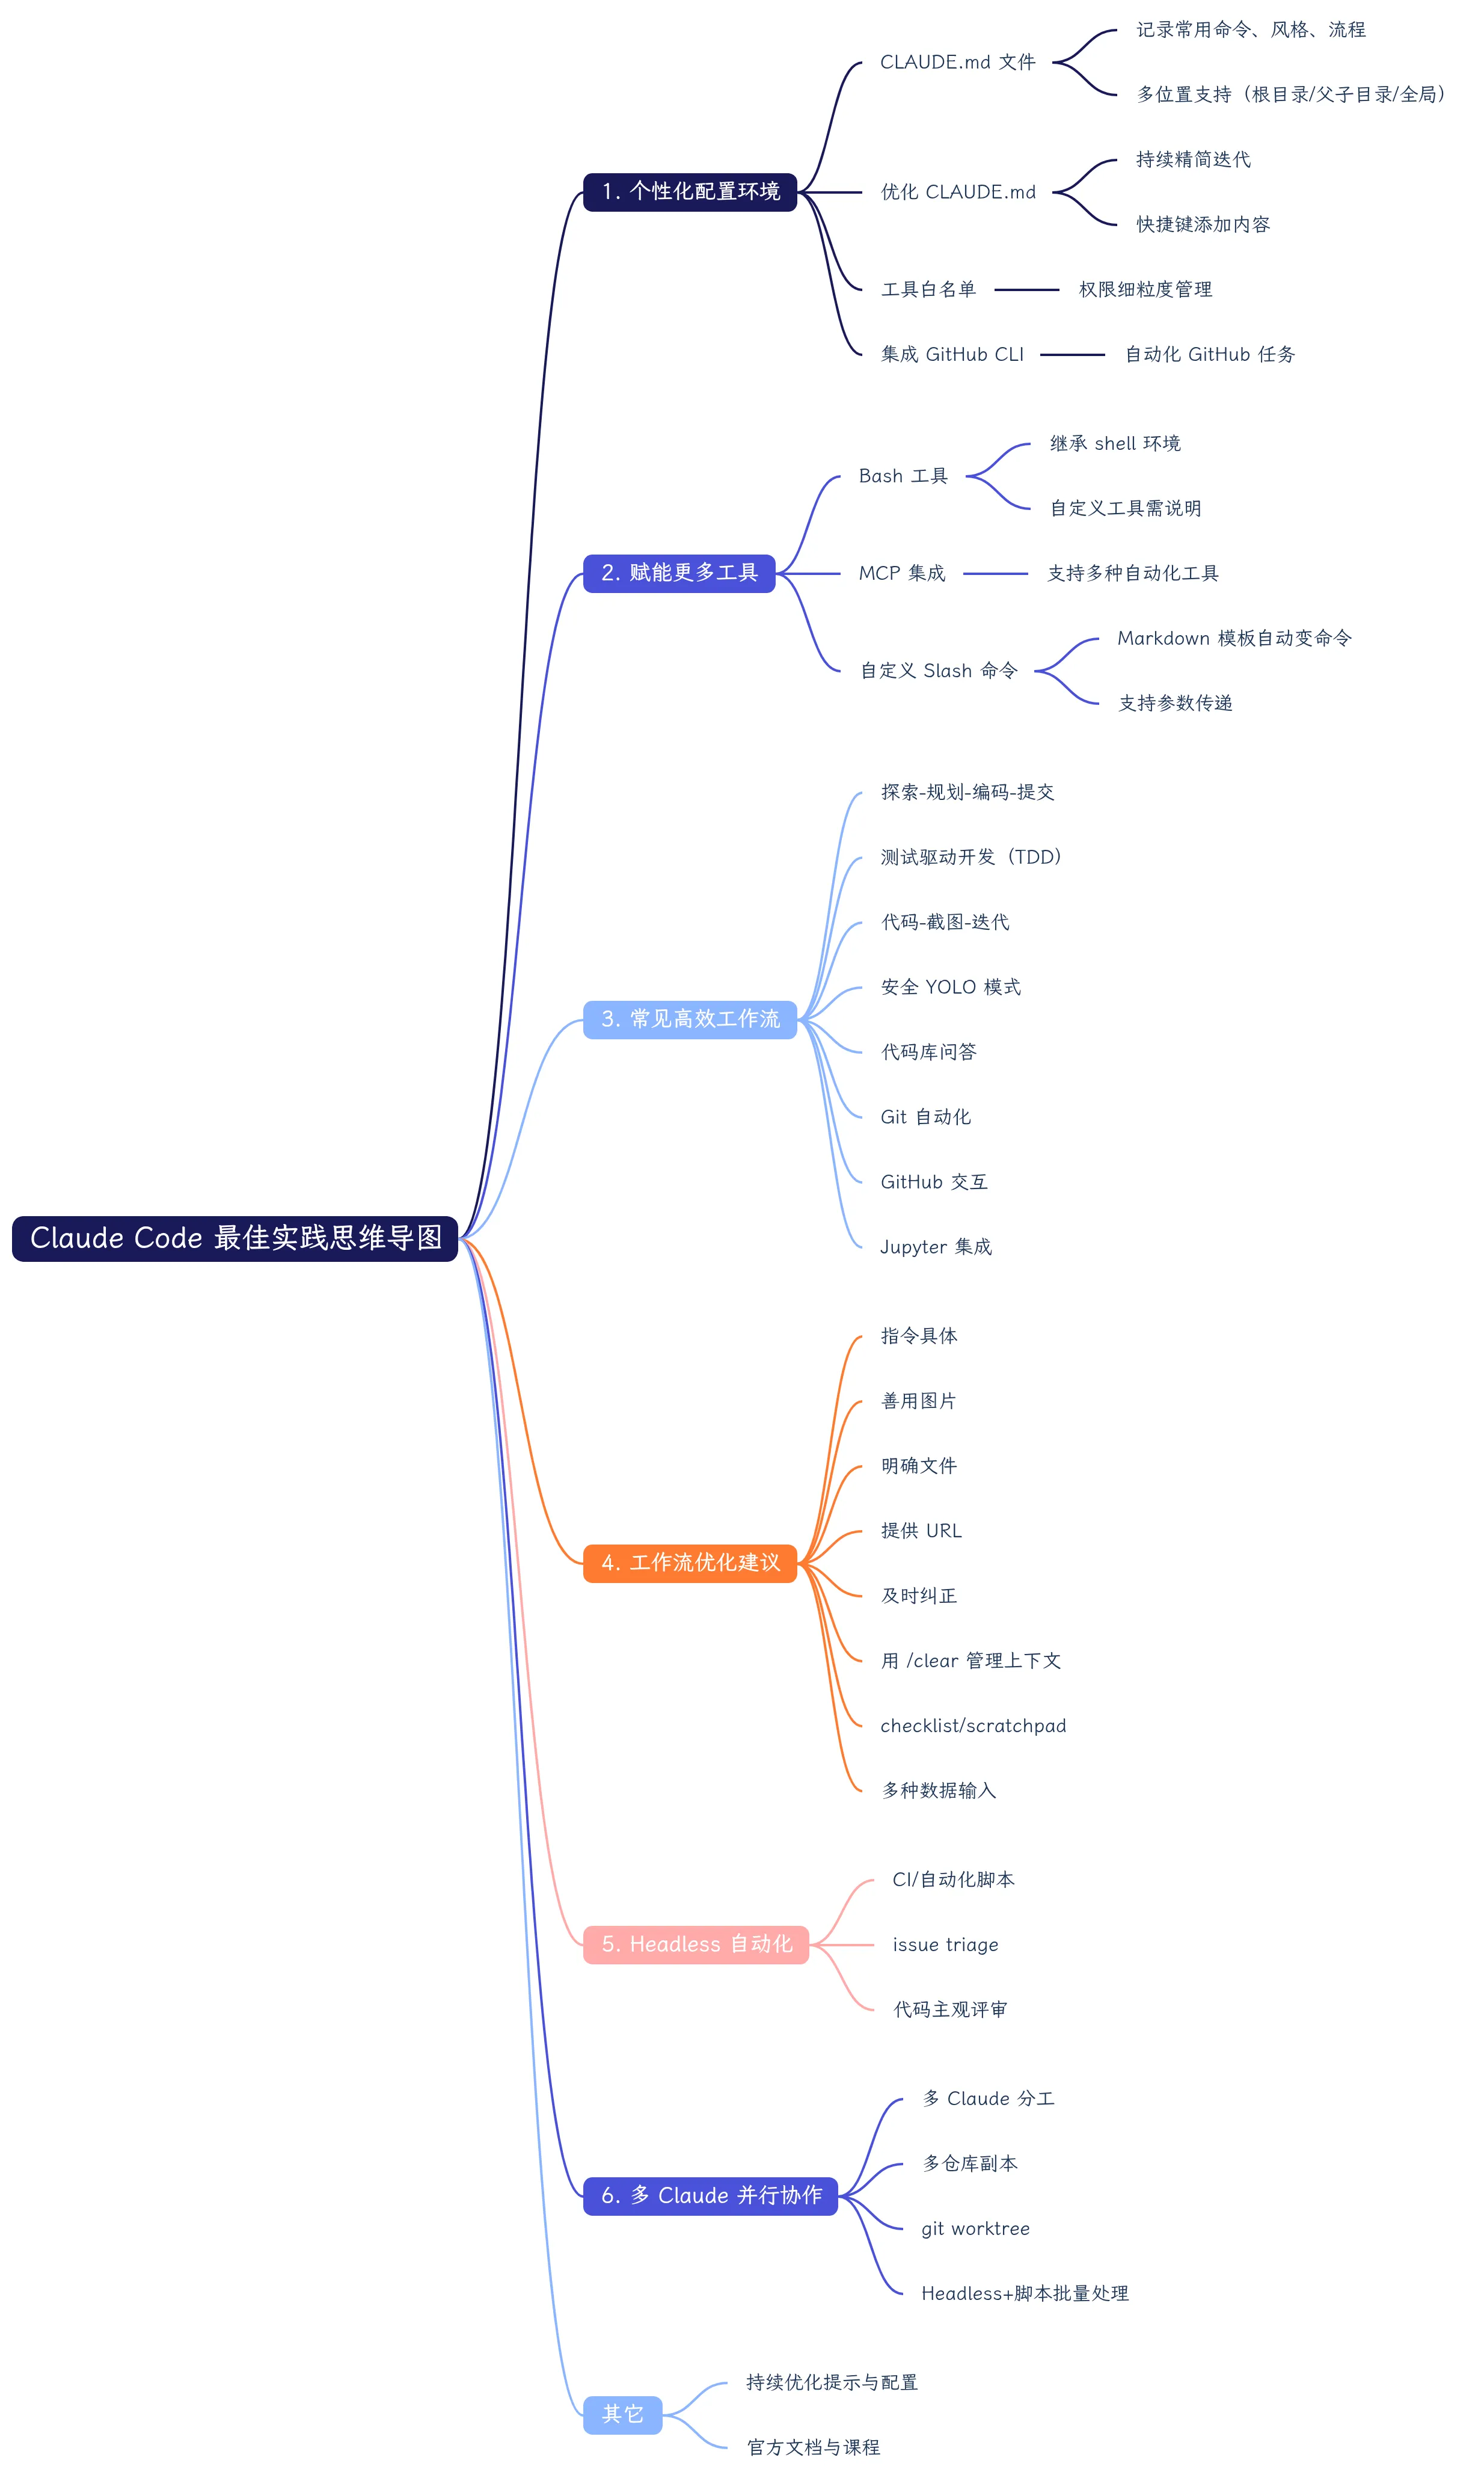
来自 Claude Code 重度使用用户分享的 ClaudeCode 最佳实践、社区技巧和工具的综合指南。
多说几句,几个月前 Cursor 还是 AI IDE 的顶流,如今用于已经偏向了 Claude Code,甚至引发了 CLI Agent 的新兴潮流。虽然 Cursor 有非常完美的 UI 和用户使用体验,但是同样的套餐,Claude Code 能有更强的 claude 适配的 Agent 能力以及更多的 token 使用,这是 cursor 暂时比不了的,毕竟这是 anthropic 公司内部的 dogfooding,能更好的适配 Claude。另一个点,Claude 目前是最强的 coding model,虽然 cursor 提供了很多其他厂商的模型,但用户都是倾向使用顶尖模型的,所以用户也不太在意转到 Claude Code 会丢失什么模型体验。Btw,在这个快速发展的年代,不要订阅任何年费 AI 产品,简直就是个小丑 🤡
随便看看
ManimML
https://github.com/helblazer811/ManimML
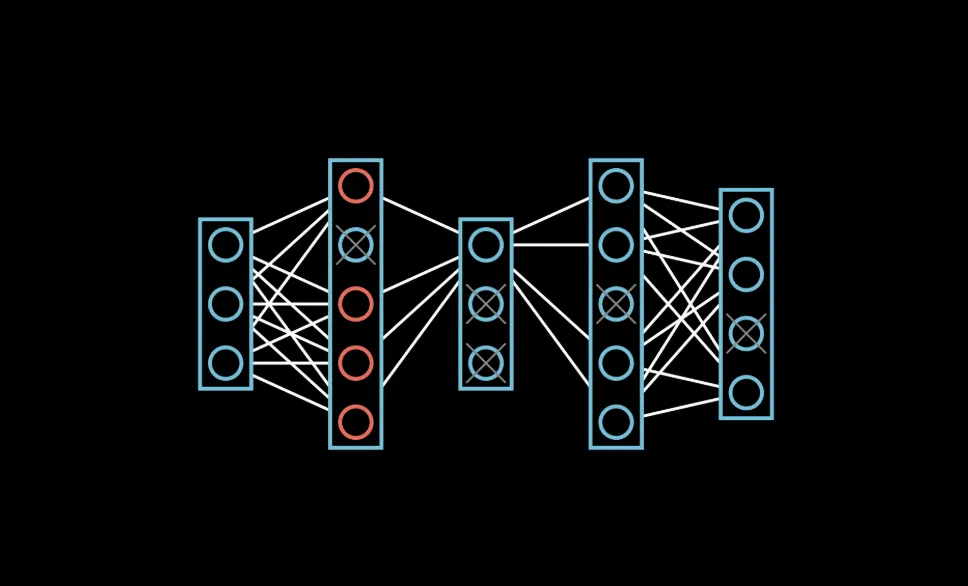
一个利用Manim社区库为机器学习概念提供动画和可视化的项目。其目标是通过原始可视化工具将复杂的机器学习概念轻松组合为视频,同时提供抽象工具以便用户专注于讲解而非软件工程。项目支持神经网络(包括前馈网络和卷积网络)的动态和静态可视化,并整合了Dropout、激活函数、池化层等动画效果。使用者可通过示例代码轻松创建动画,并进行渲染。
MonkeyCode
https://github.com/chaitin/MonkeyCode
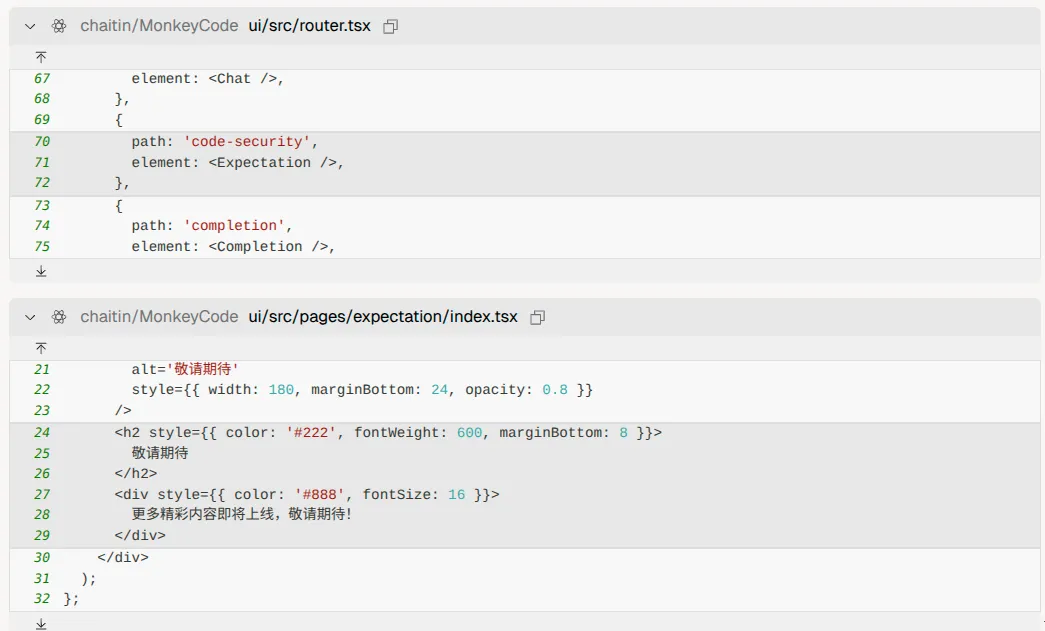
长亭科技推出的企业智能编程辅助平台,支持私有化部署和离线使用,兼容第三方及本地化大模型,专为研发管理设计。其核心功能包括企业级管理面板、代码安全扫描、智能代码补全和自然语言编程。通过 AI 的能力提升研发效率,同时保障代码质量和隐私安全。
开都开源了,仓库中咋不开源代码安全扫描的实现呢???鉴定为诈骗
随便玩玩
B2Y - YouTube 同步显示 Bilibili 弹幕
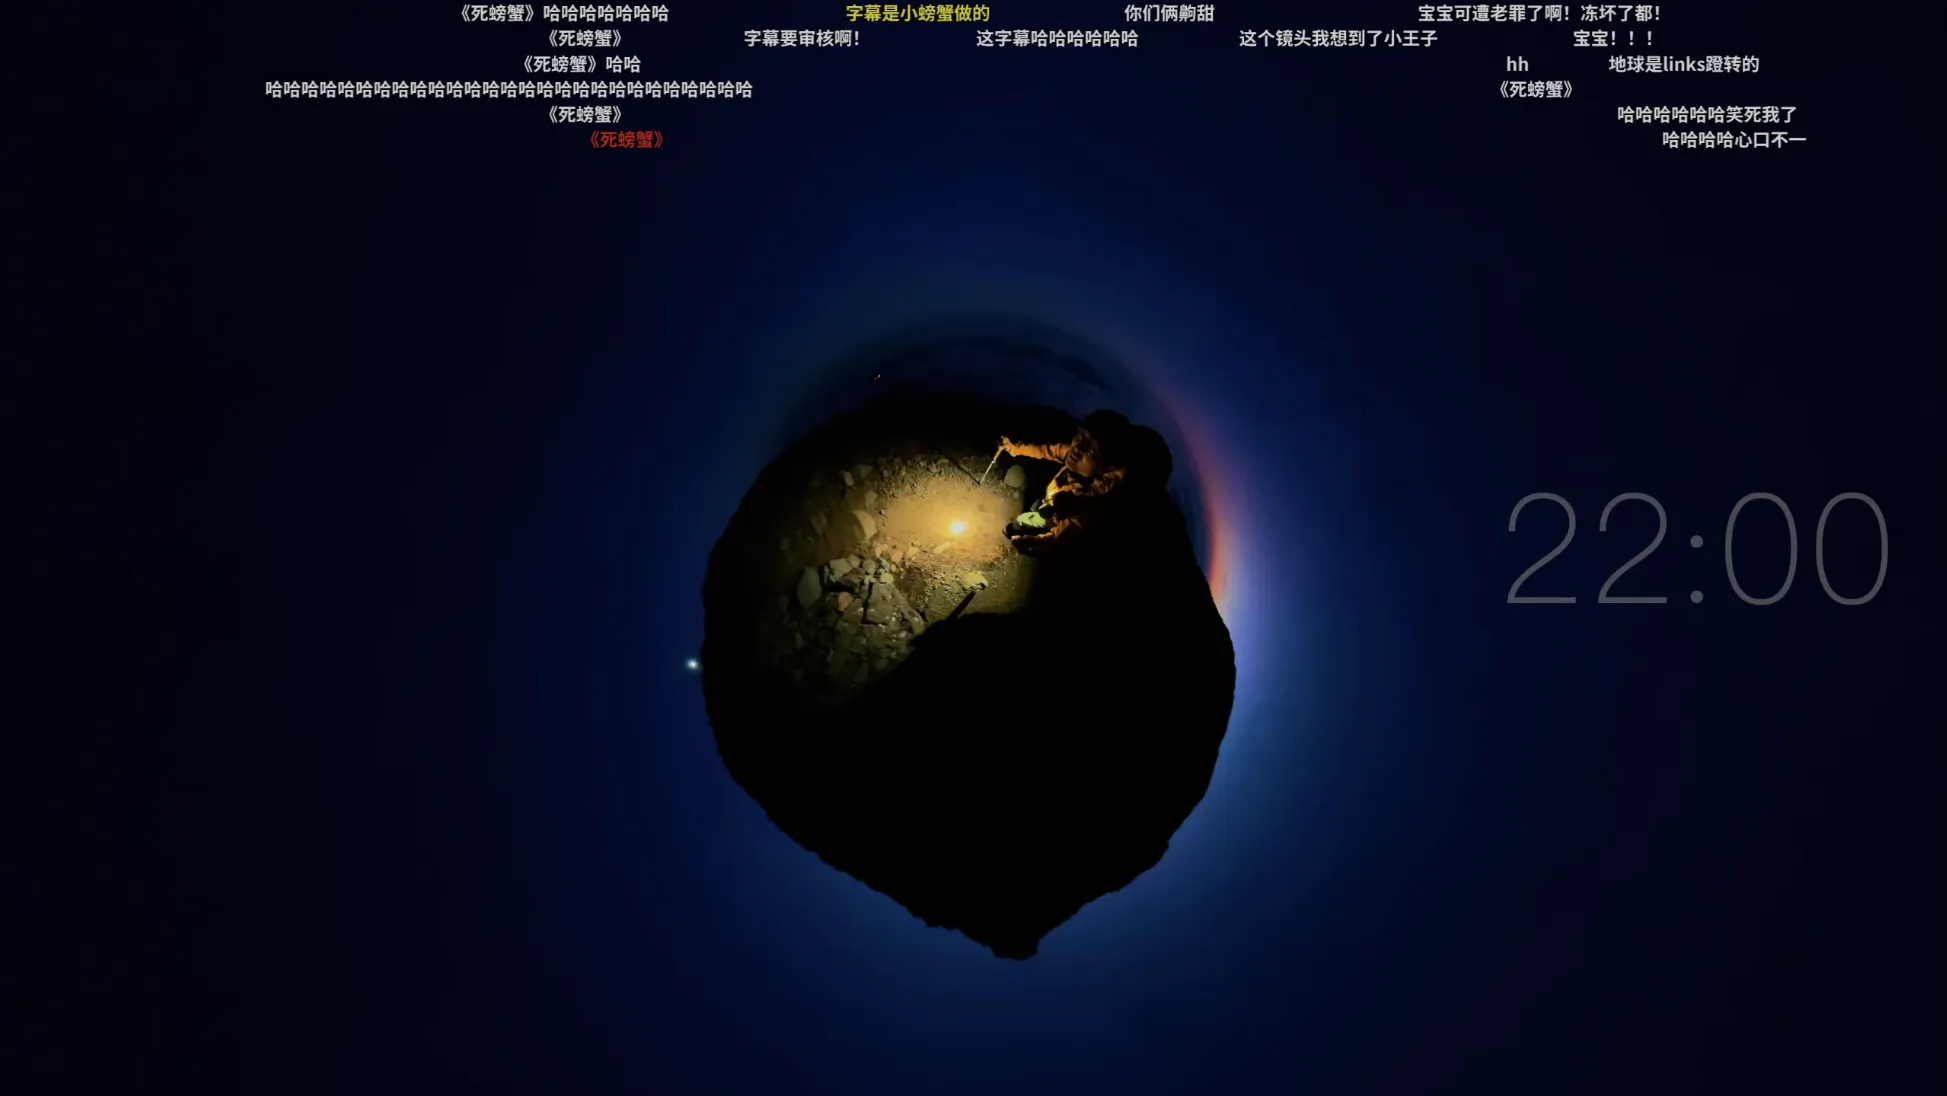
一个能够在 YouTube 上同步 B 站弹幕的插件,刚需啊,啊 B 的视频 4k 不免费,1080P 太糊了,在看 links 和影视飓风这种博主的旅游风光视频的时候,高画质才是享受,但是 YouTube 没有弹幕,有时候精彩片段还是想看网友的精彩评论 hhhh,所以这个插件简直完美解决了痛点,使用下来感觉不错哦~
✅ 支持功能:
✨ 自动查找并加载对应弹幕
✨ 支持时间轴偏移校准
✨ 支持调整弹幕字体大小、透明度、滚动速度、垂直间距
✨ 支持设置弹幕显示区域范围
✨ 支持智能弹幕过滤
✨ 支持弹幕搜索和跳转时间轴
✨ 支持 “哔哩哔哩动画” 频道内番剧正片自动获取弹幕
Spec-Driven Development MCP Server
https://www.npmjs.com/package/mcp-server-spec-driven-development?activeTab=readme
旨在通过结构化的提示引导开发者进行规范驱动开发,包括需求文档、设计文档、代码的系统化生成。
-
结构化开发流程:从需求 → 设计 → 代码,层层推进,保证开发过程可追溯。
-
EARS 需求格式:采用业界标准的 EARS(Easy Approach to Requirements Syntax)格式书写需求文档。
| 步骤 | Prompt 名称 | 说明 | 输入 | 输出 |
|---|---|---|---|---|
| 需求生成 | generate-requirements | 生成 EARS 格式需求文档 | 高层需求描述 | specs/requirements.md |
| 设计生成 | generate-design-from-requirements | 从需求生成设计文档 | specs/requirements.md | specs/design.md |
| 代码生成 | generate-code-from-design | 从设计文档生成代码 | specs/design.md | 项目根目录代码 |
-
需求阶段:使用
generate-requirements,输入你的高层需求,生成结构化需求文档。 -
设计阶段:用
generate-design-from-requirements,根据需求文档生成设计说明。 -
实现阶段:通过
generate-code-from-design,根据设计文档自动生成代码。
YesPlayMusic
https://github.com/qier222/YesPlayMusic
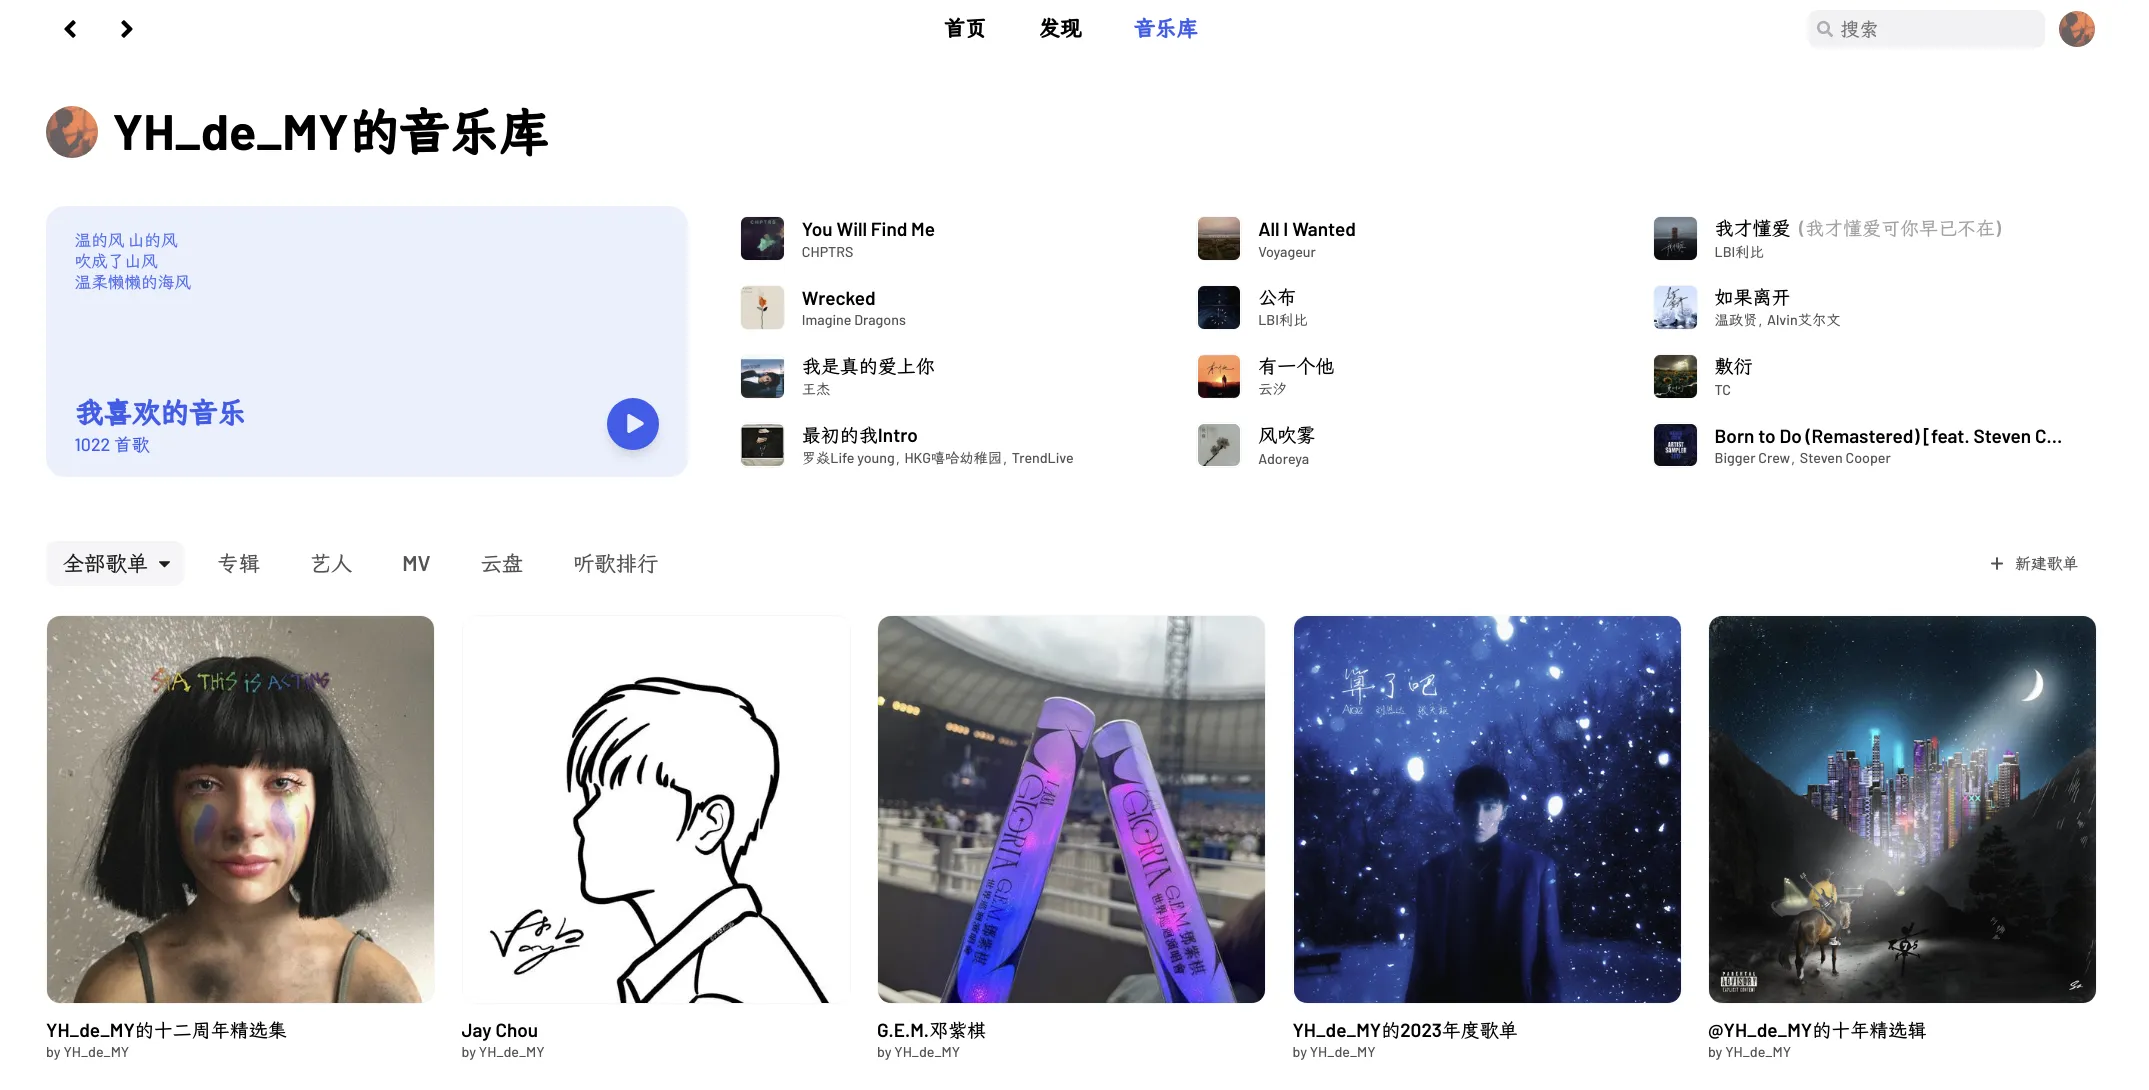
一个高颜值的第三方网易云音乐播放器,提供多平台支持(Windows/macOS/Linux)。具备丰富功能,例如网易云账号登录、歌词显示、MV播放、私人FM以及每日推荐歌曲等。它支持 UnblockNeteaseMusic 解锁音源。
使用这个的原因是工位的主机是 Ubuntu 的,网易云并没有提供 Linux 版本,哎,甚至不如 QQ 音乐,虽然两年没更新了。不支持就不支持吧,还一直封杀第三方登录,甚至封号,太离谱了。下面这个 issue 提供了解决无法登陆的问题,直接传 cookie,这样就是模拟正常的网页登录了。
https://github.com/qier222/YesPlayMusic/issues/2398
使用了几天,被网易云检测到了,说我非法使用外挂 🥲,他喵的你不同统一客户端,还不让我用别的了…… 我听个歌我用外挂刷什么 💩
cool-retro-term
https://github.com/Swordfish90/cool-retro-term
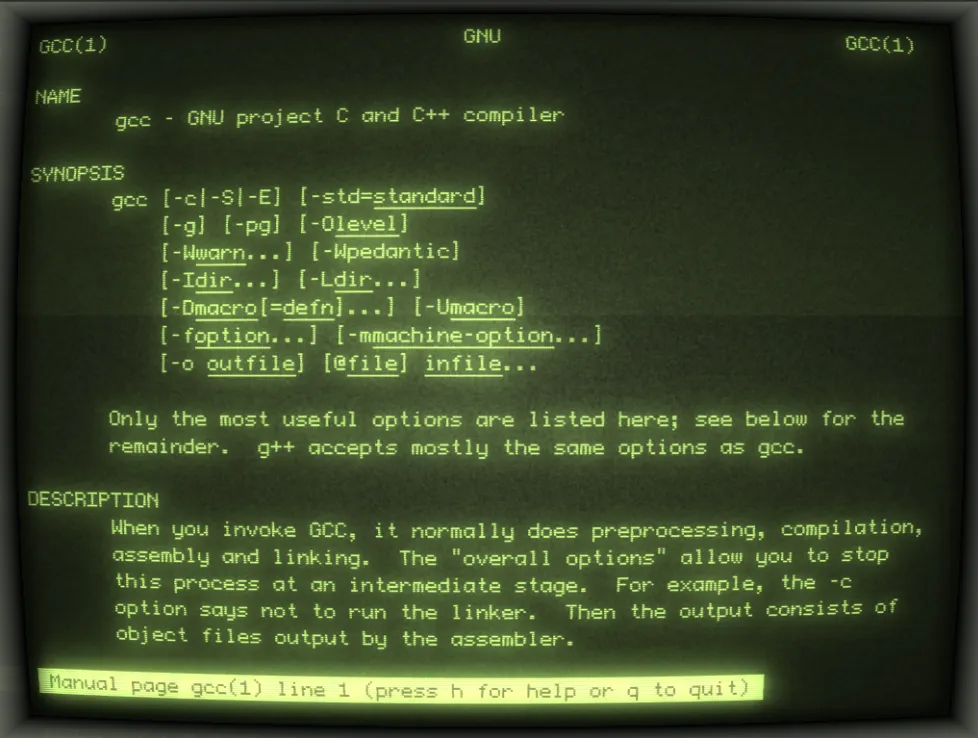
cool-retro-term是一个模仿旧式阴极管屏幕外观和感觉的漂亮终端模拟器,旨在提供美观、可定制且较为轻量的体验。它使用了QML版的qtermwidget(Konsole),兼容Linux和macOS,需依赖Qt5,建议使用最新的LTS版本。用户可通过上下文菜单调整颜色、字体和效果。(用这个 vibe coding 真的有那味了,黑客帝国 😂
Using Fortune to Reinforce Habits
https://www.judy.co.uk/blog/using-fortune-to-reinforce-habits/
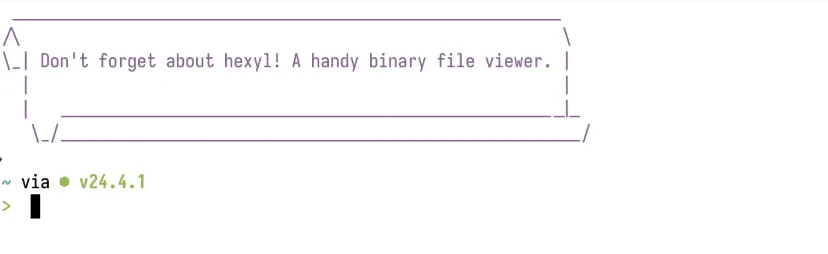
本文介绍了作者如何通过命令行工具 fortune,结合自定义文本文件,实现对新安装命令行工具的持续提醒,从而帮助自己养成使用新工具的习惯。
-
作者安装了许多现代命令行工具(如
eza、lazygit、duf、xh等),部分替代原有工具,部分提升了工作效率。 -
遇到两个主要问题:
-
肌肉记忆导致常常还是敲老命令(如
ls),即使新工具更好用。 -
遗忘工具名称或存在,尤其是一些不常用但很有用的工具。
-
-
希望每次打开终端时,能看到一条温馨提示,比如:“别忘了你已经安装了
xh——这是一款命令行HTTP客户端!” -
采用了fortune这个老牌UNIX工具,配合自定义内容,实现随机提醒。
GithubStarsManager
https://github.com/AmintaCCCP/GithubStarsManager
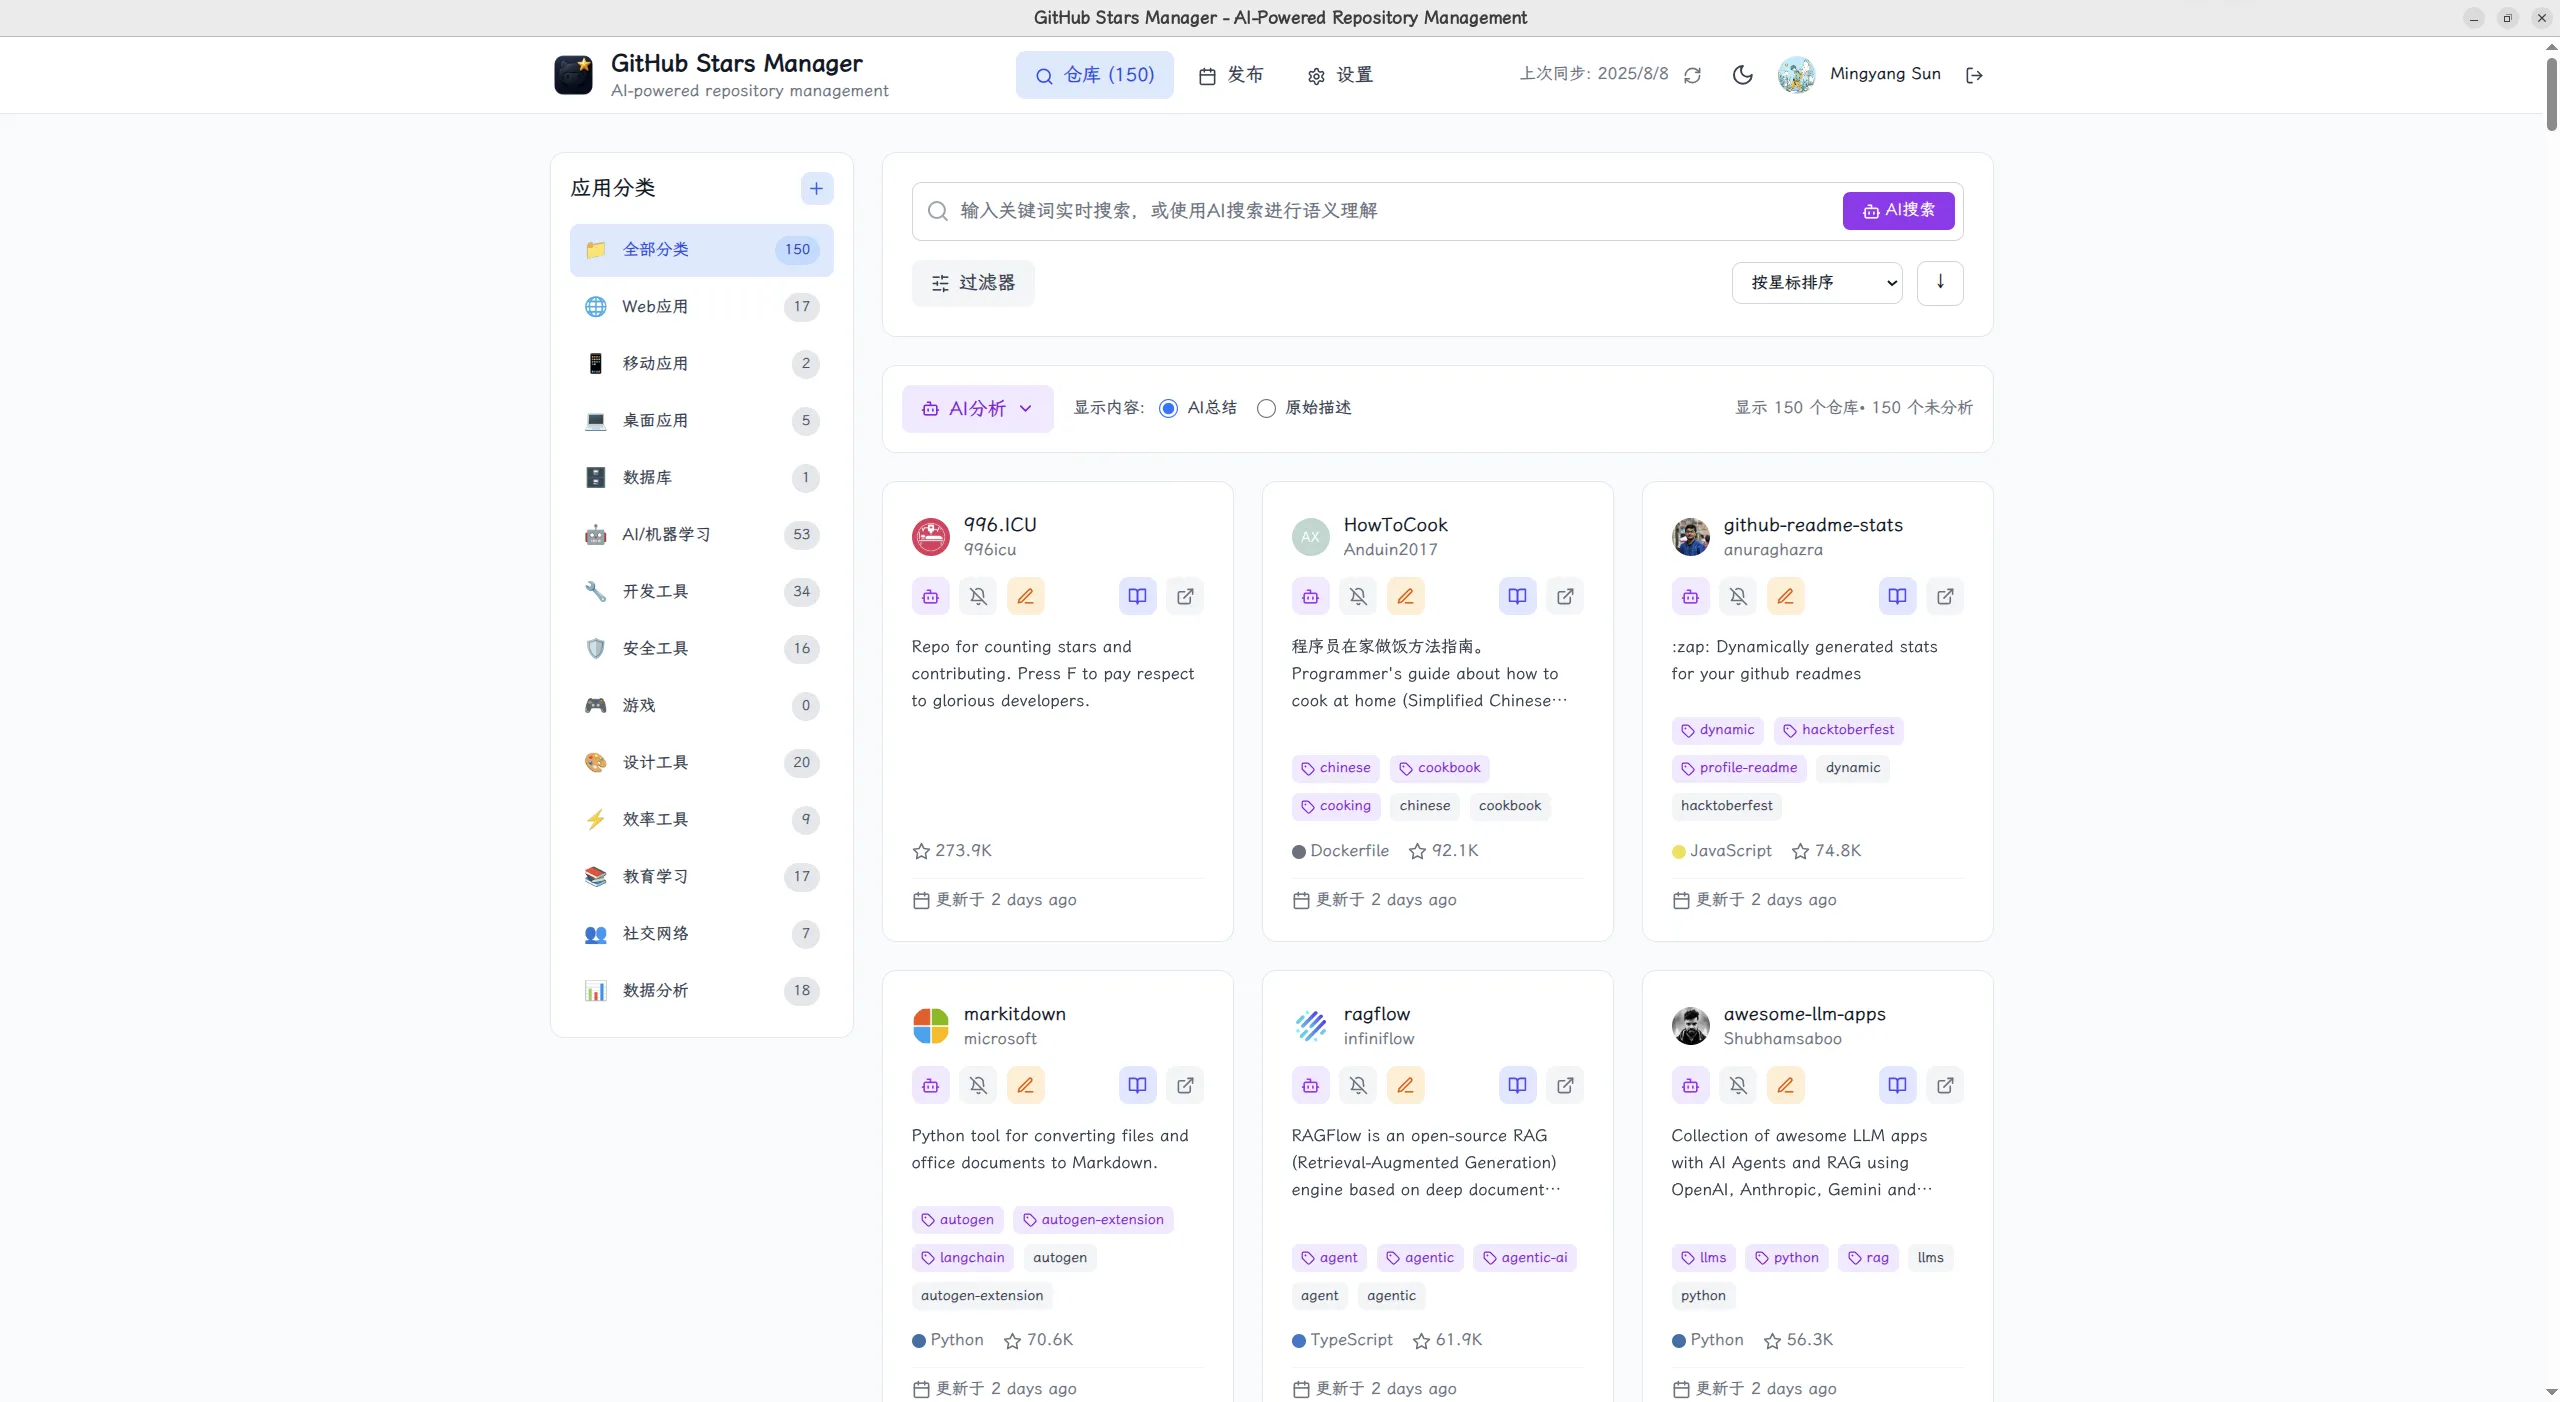
一个用于管理 GitHub 星标仓库的应用程序,适合对象包括拥有大量星标的开发者、需要系统化追踪版本的用户以及希望高效管理的使用者,主要功能包括:
-
自动同步星标仓库:通过连接 GitHub Token 来获取所有星标仓库。
-
AI智能摘要与分类:自动生成标签、主题以及简短的仓库概览。
-
语义搜索:通过搜索意图而不是准确名称来定位仓库。
-
版本追踪:订阅星标仓库的发布通知,在一个界面中查看新版本。
-
一键下载:一键下载 Release。
-
无需环境配置的客户端:直接使用打包后的客户端无需额外设置。
尝试了一下,还真挺不错的,之前也想着做一个同样需求的项目,但一直没开始,也试了试其他类似的项目,目前这个感觉体验最好的!
Research
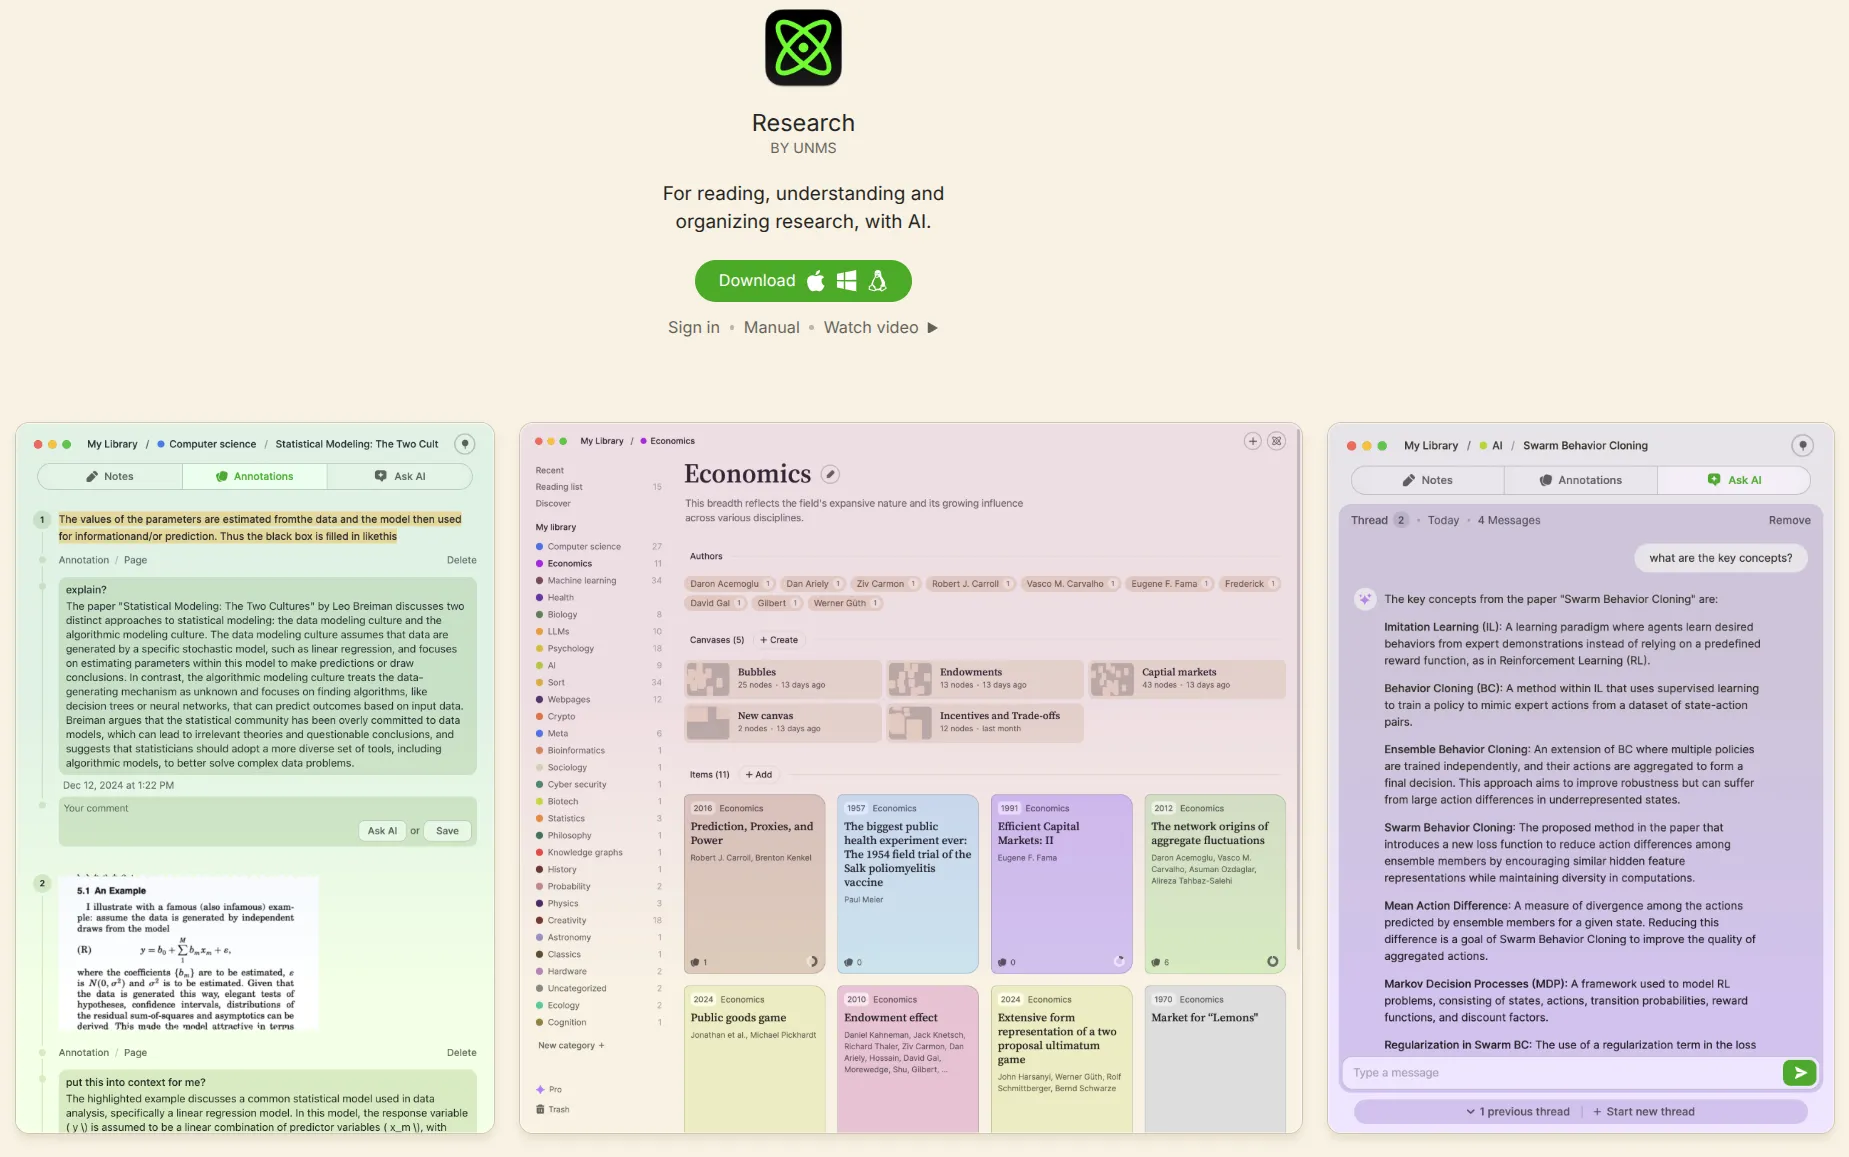
一款专为学者、研究人员和深度学习者设计的笔记与研究管理软件。它的核心目标是革新研究资料的阅读、理解和组织方式 ,将文献管理、笔记、标注和 AI 辅助分析融为一体,从而简化并深化整个研究工作流 。(挺好看的一个笔记软件哈,很吃这个 UI 和配色!还没尝试,工具淹没了😂
- 内置“发现”信息流 (Discovery Feed):软件不仅仅是一个被动的笔记工具,它还包含一个主动的“发现”功能 。系统会根据用户设定的兴趣类别(如机器学习、神经科学等),每天推送最新的研究论文。
随便说说
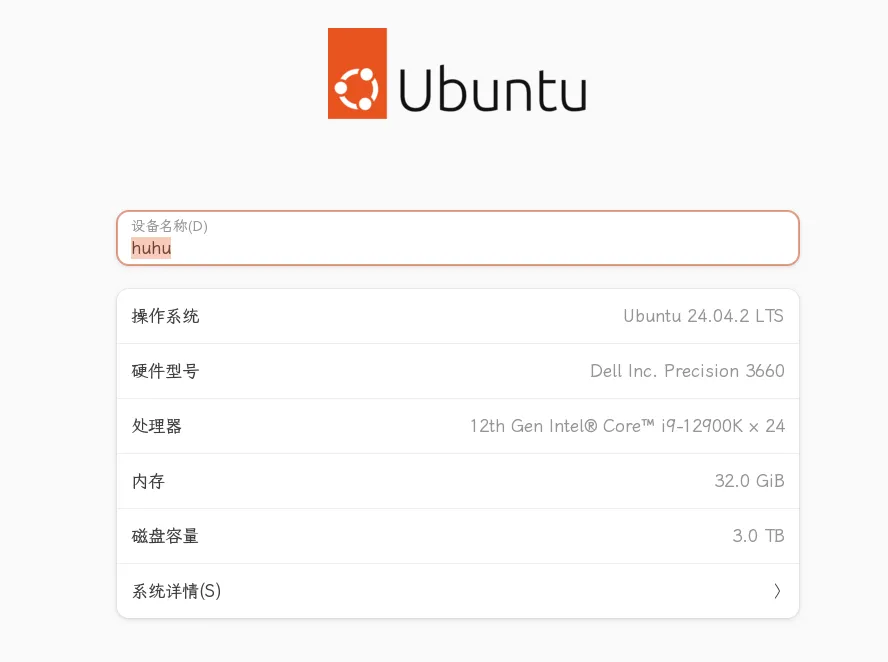
回所的生活刚开始些许不适应,最初分到一个硬盘损坏,处理器比较老的机子,使用起来很是嫌弃,后来组里突然采购了新的主机,拿到了一台性能还不错的机子,原装的 Ubuntu 22.04 系统,但是很多源已经不再更新维护了,而且 24.04 好像使用体验更好,就重装了一下,然后折腾了一些软件和插件,简单美化一下,目前使用下来很 Nice(有时间写个 blog 记录一下折腾的东西)!写代码体验 ++,环境管理太丝滑,比 WSL 还是好用的 hhh (有点小遗憾的是没有抢到 4090 的主机,来晚了,查了一下那三台主机一台 4w 多 😭,这我得住在工位)
安顿之后,主要在推项目,但是感觉每天的效率不是很高,不知道做了什么,时间就过去了,忙碌一天,不知道在忙什么,甚至不如湖里的效率高。可能我没习惯这种办公室的氛围?坐在过道容易被来往的人分散注意力,之前都是坐在宿舍,面对墙壁,比较封闭的空间,得迅速调整一下。项目我主要负责的是调模型,目前大概差不多了,调了 n 次 Prompt,蒸馏数据,SFT 模型,指标应该还能再升一些,得修改 loss 计算方式,目前用的 ms-swift 框架,设计自定义 loss 需要写个插件化的损失函数,还没尝试能不能跑通,如果可以,后面打算写个 blog 记录一下 swfit 框架自定义训练的流程。
自己的科研还没进展,努力找大致可行的 idea 中………
因为自己的一个开源小项目,周末很荣幸的被大厂的一个前辈邀请喝咖啡,交流了一些 AI、开发、产品设计等方面的东西,学到了很多,提供了很多产品优化、打磨的思路和见解,如何抓住用户的需求等。前辈在 AI 上面的涉猎也很让我赞叹,对新的技术和产品也侃侃而谈,而且付费了很多市面上知名的 AI 产品,我当时就说“太豪了”,他说“在这个时间节点,能够更多的学习、体验新的产品和 AI 所带来的能力,比钱可重要多了”,qs,我要有钱我也想 😭。交流中,也问了我一些问题,挺值得思考的,结束时,我自己在商场外面发呆了半小时…… 总之,很高兴能够有这样一次交流的机会😊~