🎶𝓦𝓮𝓮𝓴𝓵𝔂 𝓼𝓸𝓷𝓰 𝓹𝓲𝓬𝓴 🪗:
知识小品
DeepSeek R1
最近几天一直在被 DeepSeek 刷屏,X 上都是各种解说和评估使用案例,所以评价肯定是出奇的好。使用之后,我的感觉也是很赞,超过了一直使用的 gpt-4o 和 claude 3.5 以及之前的 Gemini 2.0,非常好用且很便宜,这难免不让人兴奋🎉。
当然这只是开始,DeepSeek 将具体的模型权重和技术细节公开之后,未来几个月肯定会出现更强大的模型,甚至小参数模型也能有非常好的效果,以后,我感觉不会久,本地有个实时交互的贾维斯真的不是梦!
‣
https://x.com/SirrahChan/status/1881488738473357753
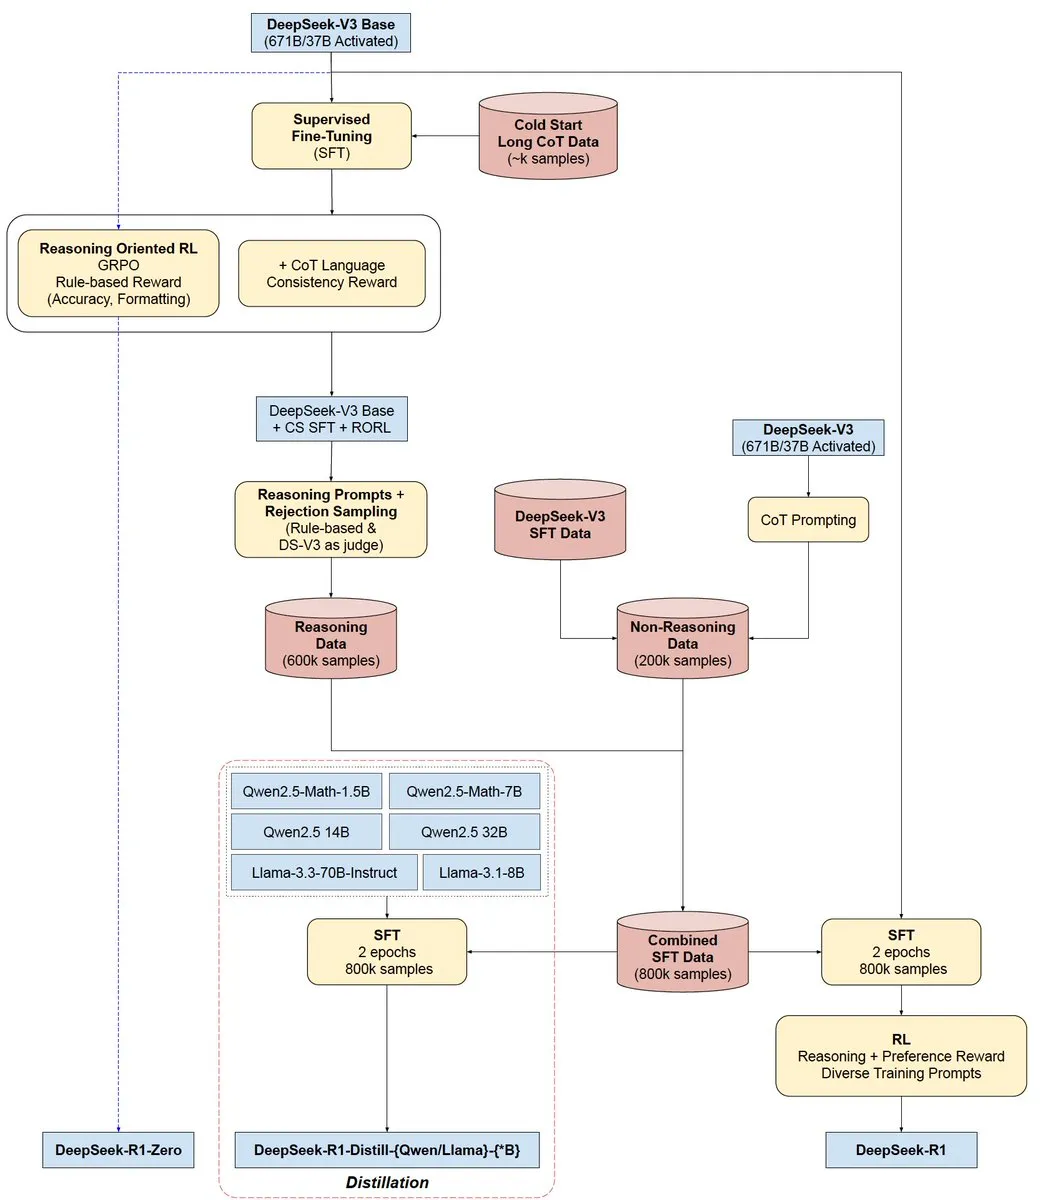
这张图很直观的阐述了 DeepSeek R1 和 DeepSeek R1 Zero 的训练流程。下面贴一些论文解读的文章和视频,当然如果是这个研究领域的,建议有时间自己读一读。
自学成才之路,DeepSeek R1 论文解读(通俗易懂的讲解)
Paper: DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
open-r1
https://github.com/huggingface/open-r1
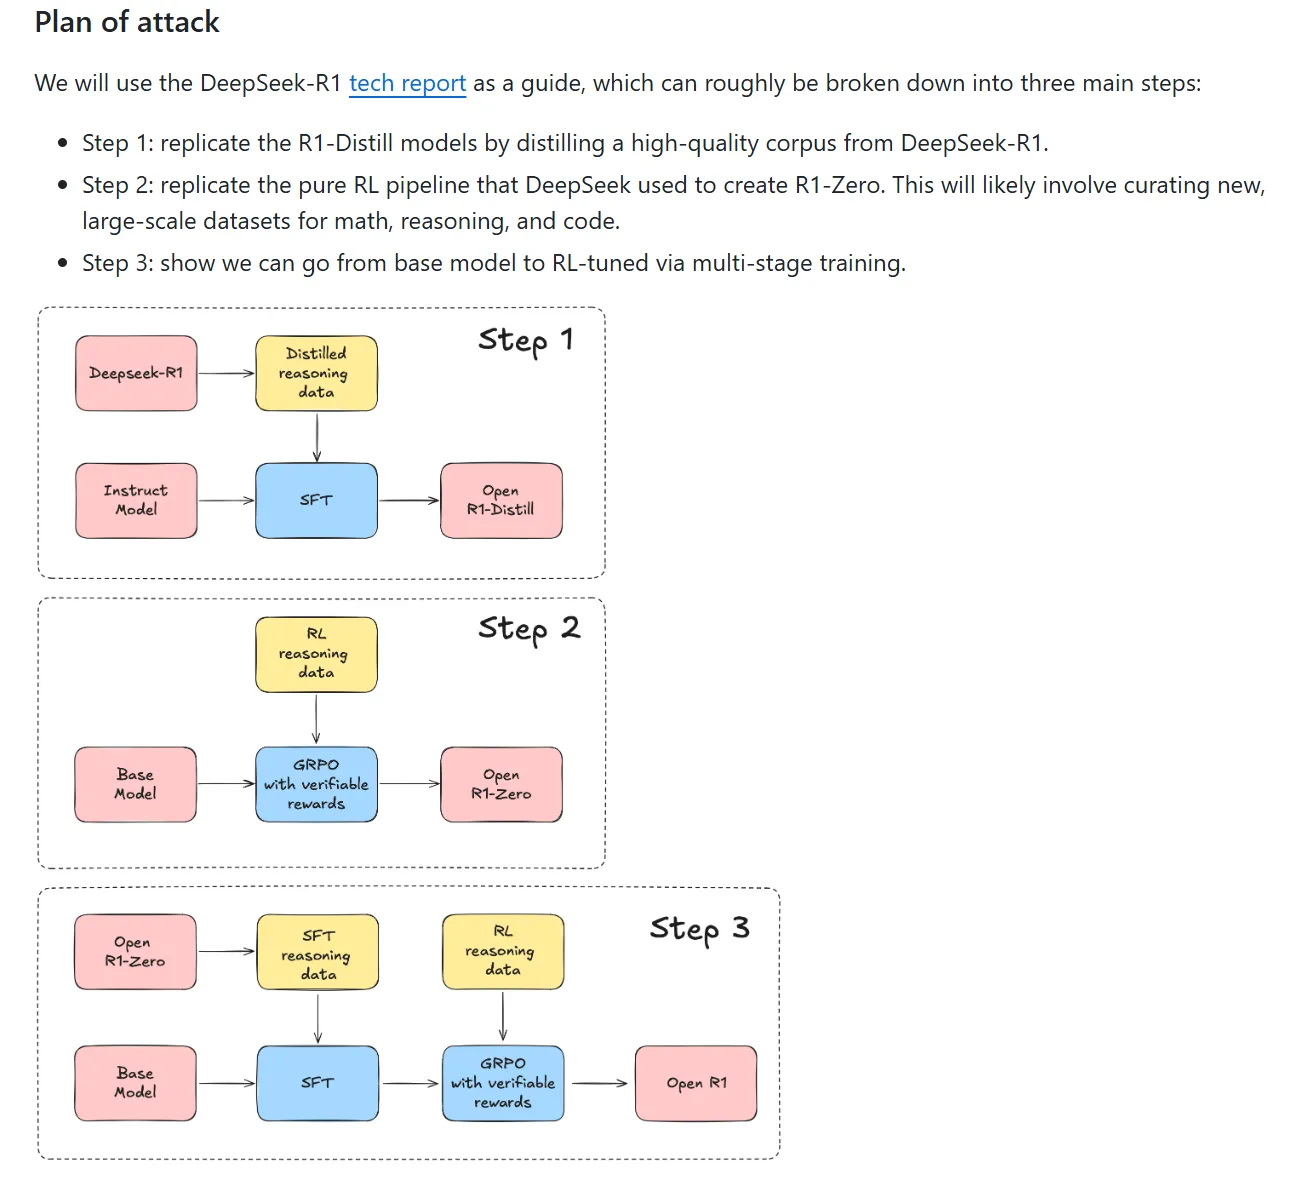
Open R1 是 Hugging Face 开源的 DeepSeek-R1 的完全复现项目,旨在构建 R1 流程的关键组件,方便社区复现和扩展。
R1+Sonnet set SOTA on aider’s polyglot benchmark
https://aider.chat/2025/01/24/r1-sonnet.html
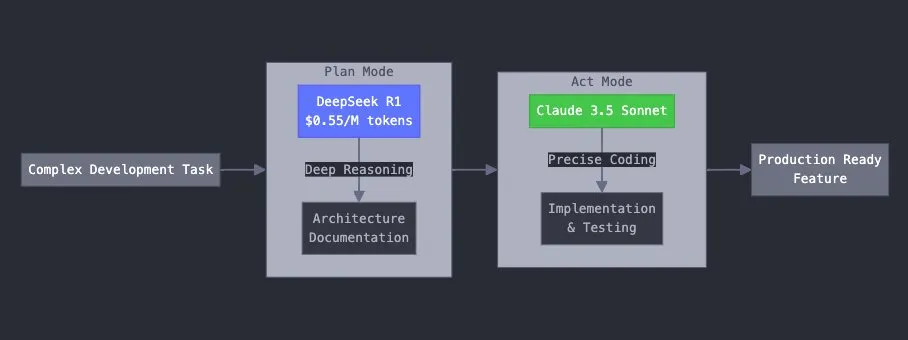
R1 与 Sonnet 模型在 Aider Polyglot Benchmark 上达成了新的 SOTA (State of the Art),以 64.0% 的准确率和14倍更低的成本超越了之前的 SOTA。
-
Architect 模型:负责推理和提出解决方案(如 R1)。
-
Editor 模型:根据 Architect 的输出生成具体的代码编辑指令(如 Sonnet)。
-
R1 + Sonnet 的组合在 Aider Polyglot Benchmark 上表现最佳。
| 模型组合 | 完成率 | 正确编辑格式率 | 总成本 | 备注 |
| R1 + Sonnet | 64.0% | 100.0% | $13.29 | Architect 模式,成本低,表现最佳 |
| o1 | 61.7% | 91.5% | $186.5 | Diff 模式,成本高 |
| R1 | 56.9% | 96.9% | $5.42 | Diff 模式 |
| Sonnet | 51.6% | 99.6% | $14.41 | Diff 模式 |
| DeepSeek V3 | 48.4% | 98.7% | $0.34 | Diff 模式,成本最低,但完成率较低 |
-
R1 + Sonnet 的优势:
-
准确率最高(64.0%)。
-
成本显著低于之前的 SOTA。
-
编辑格式正确率达到 100%。
-
-
o1 + Sonnet 的组合未能显著提升 o1 的表现。
-
第一代推理模型(如 o1-preview 和 o1-mini)在与多种 Editor 模型组合时表现有所提升,但 R1 和 o1 在独立使用时的表现更好。
-
R1 的推理输出(<think> tokens):
- 虽然有实验尝试将 R1 的
<think>token 提供给 Sonnet,但结果不如直接使用 Architect/Editor 模式。
- 虽然有实验尝试将 R1 的
rag-web-ui
https://github.com/rag-web-ui/rag-web-ui
RAG Web UI是一个基于RAG的智能对话系统,旨在帮助企业和个人构建基于自身知识库的智能问答系统。通过结合文档检索和大型语言模型,它提供准确可靠的知识问答服务。
-
智能文档管理
-
支持多种文档格式(PDF、DOCX、Markdown、Text)。
-
自动进行文档分块和向量化处理。
-
支持异步文档处理和增量更新。
-
-
高级对话引擎
-
基于 RAG 实现精确的检索和生成。
-
支持多轮上下文对话。
-
支持在对话中引用参考资料。
-
-
健壮的架构
-
采用前后端分离设计。
-
分布式文件存储。
-
高性能向量数据库:支持 ChromaDB 和 Qdrant,并且可以通过工厂模式轻松切换。
-
graph TB
    %% Role Definitions
    client["Caller/User"]
    open_api["Open API"]

    subgraph import_process["Document Ingestion Process"]
        direction TB
        %% File Storage and Document Processing Flow
        docs["Document Input<br/>(PDF/MD/TXT/DOCX)"]
        job_id["Return Job ID"]

        nfs["NFS"]

        subgraph async_process["Asynchronous Document Processing"]
            direction TB
            preprocess["Document Preprocessing<br/>(Text Extraction/Cleaning)"]
            split["Text Splitting<br/>(Segmentation/Overlap)"]

            subgraph embedding_process["Embedding Service"]
                direction LR
                embedding_api["Embedding API"] --> embedding_server["Embedding Server"]
            end

            store[(Vector Database)]

            %% Internal Flow of Asynchronous Processing
            preprocess --> split
            split --> embedding_api
            embedding_server --> store
        end

        subgraph job_query["Job Status Query"]
            direction TB
            job_status["Job Status<br/>(Processing/Completed/Failed)"]
        end
    end

    %% Query Service Flow
    subgraph query_process["Query Service"]
        direction LR
        user_history["User History"] --> query["User Query<br/>(Based on User History)"]
        query --> query_embed["Query Embedding"]
        query_embed --> retrieve["Vector Retrieval"]
        retrieve --> rerank["Re-ranking<br/>(Cross-Encoder)"]
        rerank --> context["Context Assembly"]
        context --> llm["LLM Generation"]
        llm --> response["Final Response"]
        query -.-> rerank
    end

    %% Main Flow Connections
    client --> |"1.Upload Document"| docs
    docs --> |"2.Generate"| job_id
    docs --> |"3a.Trigger"| async_process
    job_id --> |"3b.Return"| client
    docs --> nfs
    nfs --> preprocess

    %% Open API Retrieval Flow
    open_api --> |"Retrieve Context"| retrieval_service["Retrieval Service"]
    retrieval_service --> |"Access"| store
    retrieval_service --> |"Return Context"| open_api

    %% Status Query Flow
    client --> |"4.Poll"| job_status
    job_status --> |"5.Return Progress"| client

    %% Database connects to Query Service
    store --> retrieve

    %% Style Definitions (Adjusted to match GitHub theme colors)
    classDef process fill:#d1ecf1,stroke:#0077b6,stroke-width:1px
    classDef database fill:#e2eafc,stroke:#003566,stroke-width:1px
    classDef input fill:#caf0f8,stroke:#0077b6,stroke-width:1px
    classDef output fill:#ffc8dd,stroke:#d00000,stroke-width:1px
    classDef rerank fill:#cdb4db,stroke:#5a189a,stroke-width:1px
    classDef async fill:#f8edeb,stroke:#7f5539,stroke-width:1px,stroke-dasharray: 5 5
    classDef actor fill:#fefae0,stroke:#606c38,stroke-width:1px
    classDef jobQuery fill:#ffedd8,stroke:#ca6702,stroke-width:1px
    classDef queryProcess fill:#d8f3dc,stroke:#40916c,stroke-width:1px
    classDef embeddingService fill:#ffe5d9,stroke:#9d0208,stroke-width:1px
    classDef importProcess fill:#e5e5e5,stroke:#495057,stroke-width:1px

    %% Applying classes to nodes
    class docs,query,retrieval_service input
    class preprocess,split,query_embed,retrieve,context,llm process
    class store,nfs database
    class response,job_id,job_status output
    class rerank rerank
    class async_process async
    class client,open_api actor
    class job_query jobQuery
    style query_process fill:#d8f3dc,stroke:#40916c,stroke-width:1px
    style embedding_process fill:#ffe5d9,stroke:#9d0208,stroke-width:1px
    style import_process fill:#e5e5e5,stroke:#495057,stroke-width:1px
    style job_query fill:#ffedd8,stroke:#ca6702,stroke-width:1px
很完整的一个 RAG 流程图,大致也把代码看了看,主要是想看看现在的 RAG 是如何做 embedding 以及 retrieval 的,项目是直接调用两个第三方向量数据库的 API 进行向量存储和相似度计算,文本的 encode 使用的是 OAI 的 embedding model,然后相似度计算应该使用的是余弦相似度。
其实我比较好奇的是相似度的判定。计算一个 query 和 n 个文本片段的内容和语义上是否相关,应该就取决于 embedding model 的能力,其是否能够捕捉很好的语义。最近写代码时发现即使使用一些公认的比较好的预训练模型对文本进行 encode 之后,在进行 query 时,不相关的文本,也会有比较高的相似度分数,比如 0.45 左右。那如果我想过滤出所有相关的文本,相似度分数阈值该如何设置呢?比如下面的例子:
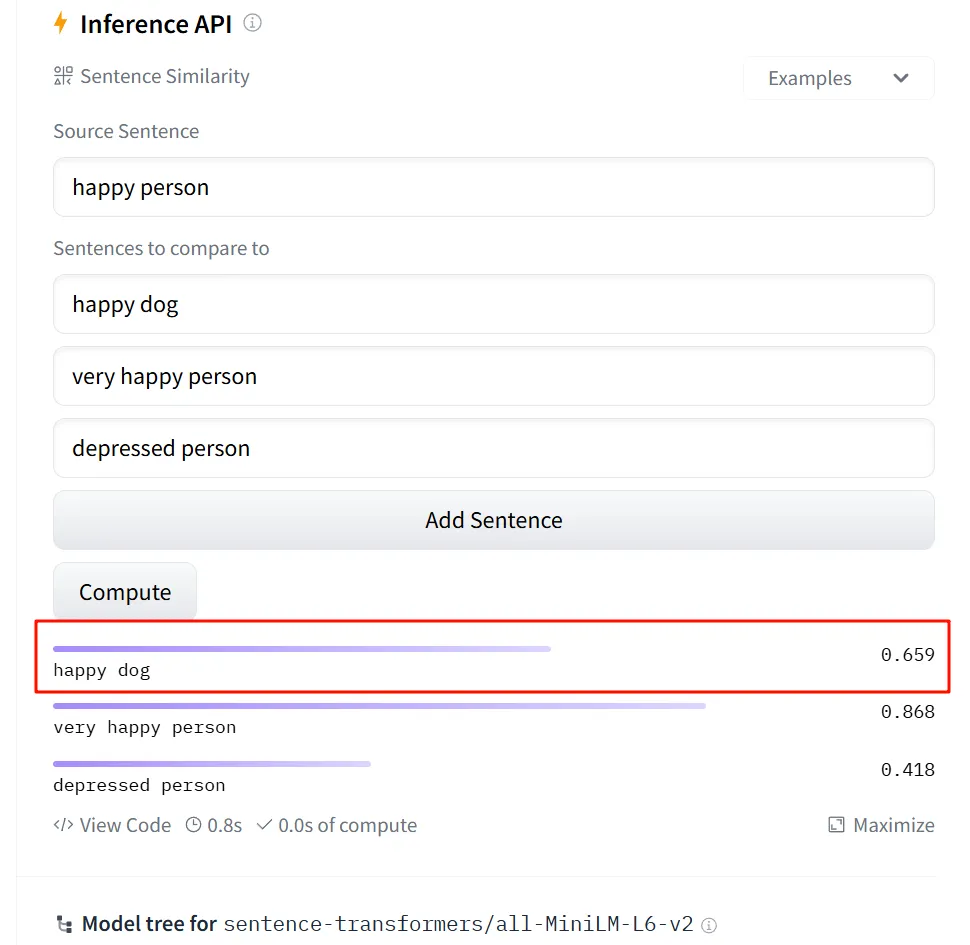
使用 all-MiniLM-L6-v2 模型对两个句子进行 embedding:happy person,happy dog,计算得到的相似度为 0.659? 但是两个意思完全不一样啊,一个主体是人,一个是狗,除了描述的都是开心状态。
"title": "Overconfidence is a Dangerous Thing: Mitigating Membership Inference Attacks by Enforcing Less Confident Prediction.",

"abstract": "Machine learning (ML) models are vulnerable to membership inference attacks (MIAs), which determine whether a given input is used for training the target model. While there have been many efforts to mitigate MIAs, they often suffer from limited privacy protection, large accuracy drop, and/or requiring additional data that may be difficult to acquire. This work proposes a defense technique, HAMP that can achieve both strong membership privacy and high accuracy, without requiring extra data. To mitigate MIAs in different forms, we observe that they can be unified as they all exploit the ML model's overconfidence in predicting training samples through different proxies. This motivates our design to enforce less confident prediction by the model, hence forcing the model to behave similarly on the training and testing samples. HAMP consists of a novel training framework with high-entropy soft labels and an entropy-based regularizer to constrain the model's prediction while still achieving high accuracy. To further reduce privacy risk, HAMP uniformly modifies all the prediction outputs to become low-confidence outputs while preserving the accuracy, which effectively obscures the differences between the prediction on members and non-members. We conduct extensive evaluation on five benchmark datasets, and show that HAMP provides consistently high accuracy and strong membership privacy. Our comparison with seven state-of-the-art defenses shows that HAMP achieves a superior privacy-utility trade off than those techniques."
query: Papers on detecting vulnerabilities in web applications
我就想判断 query 和 title + abstract 组成的文本段落,内容和语义上是否相关,然后过滤出所有相关的 paper。目前来看即使使用 mteb/leaderboard 上排名靠前的模型,效果也不是很好,不知道哪里不对。
Awesome-Framework-Gallery
https://github.com/LongHZ140516/awesome-framework-gallery
一个收集各种研究领域框架图的图库,旨在为研究人员提供科学论文插图的灵感。该项目会持续更新,收集各个领域的框架图像。
-
收集和整理各种研究领域的框架图像,涵盖机器学习、计算机视觉、遥感等多个领域。
-
为研究人员提供科学论文插图的灵感和参考。
-
该项目会持续更新,不断增加新的框架图像。
Reducing Docker Logs Size: A Practical Guide to Log Management
https://linuxiac.com/reducing-docker-logs-file-size/
之前用送的美国🐣搭建了一个公益的 docker 反代,但是最近有佬友反映 502 error了,查看是磁盘满了,df -h 发现 docker 容器缓存占满了 20G 的磁盘,镜像缓存占了7个G, /var/lib/docker/containers 中的日志文件占了7个G。我直接把镜像缓存 rm 了,然后用 truncate 命令清除日志: sudo truncate -s 0 /var/lib/docker/containers/3708db352dce/*-json.log ,然后
配置日志轮转,编辑 /etc/docker/daemon.json:
{
  "log-driver": "json-file",
  "log-opts": {
    "max-size": "10m",
    "max-file": "3"
  }
}
我通过 AI 直接给出的解决方案好像和文章提出的方法差不多哎哈哈哈:
-
Docker日志管理的重要性:Docker日志可以迅速增长,占用大量磁盘空间,因此需要定期管理和清理。
-
日志重置条件:Docker容器的日志并不会因为容器的重启而自动重置,只有当容器被删除并重新创建时,日志才会重置。
-
检查Docker日志大小:文章提供了命令
find /var/lib/docker/containers/ -name "*json.log" | xargs du -h | sort -hr来快速检查Docker日志文件的大小。 -
匹配容器名称和ID:可以使用
docker inspect --format='}' <container_id>命令通过容器ID查找容器的名称,以便了解哪个容器生成了哪个日志文件。 -
清理和管理Docker日志:推荐使用
truncate命令清除日志文件内容,以及如何配置Docker日志大小限制和轮换策略来自动管理日志。 -
应用日志大小限制:修改
daemon.json文件并重启Docker服务可以为所有新创建的容器设置全局日志大小限制和日志轮换。
随便看看
悲观者总是正确,乐观者正在前行
https://www.youtube.com/watch?v=Gs7cbVoTmh8
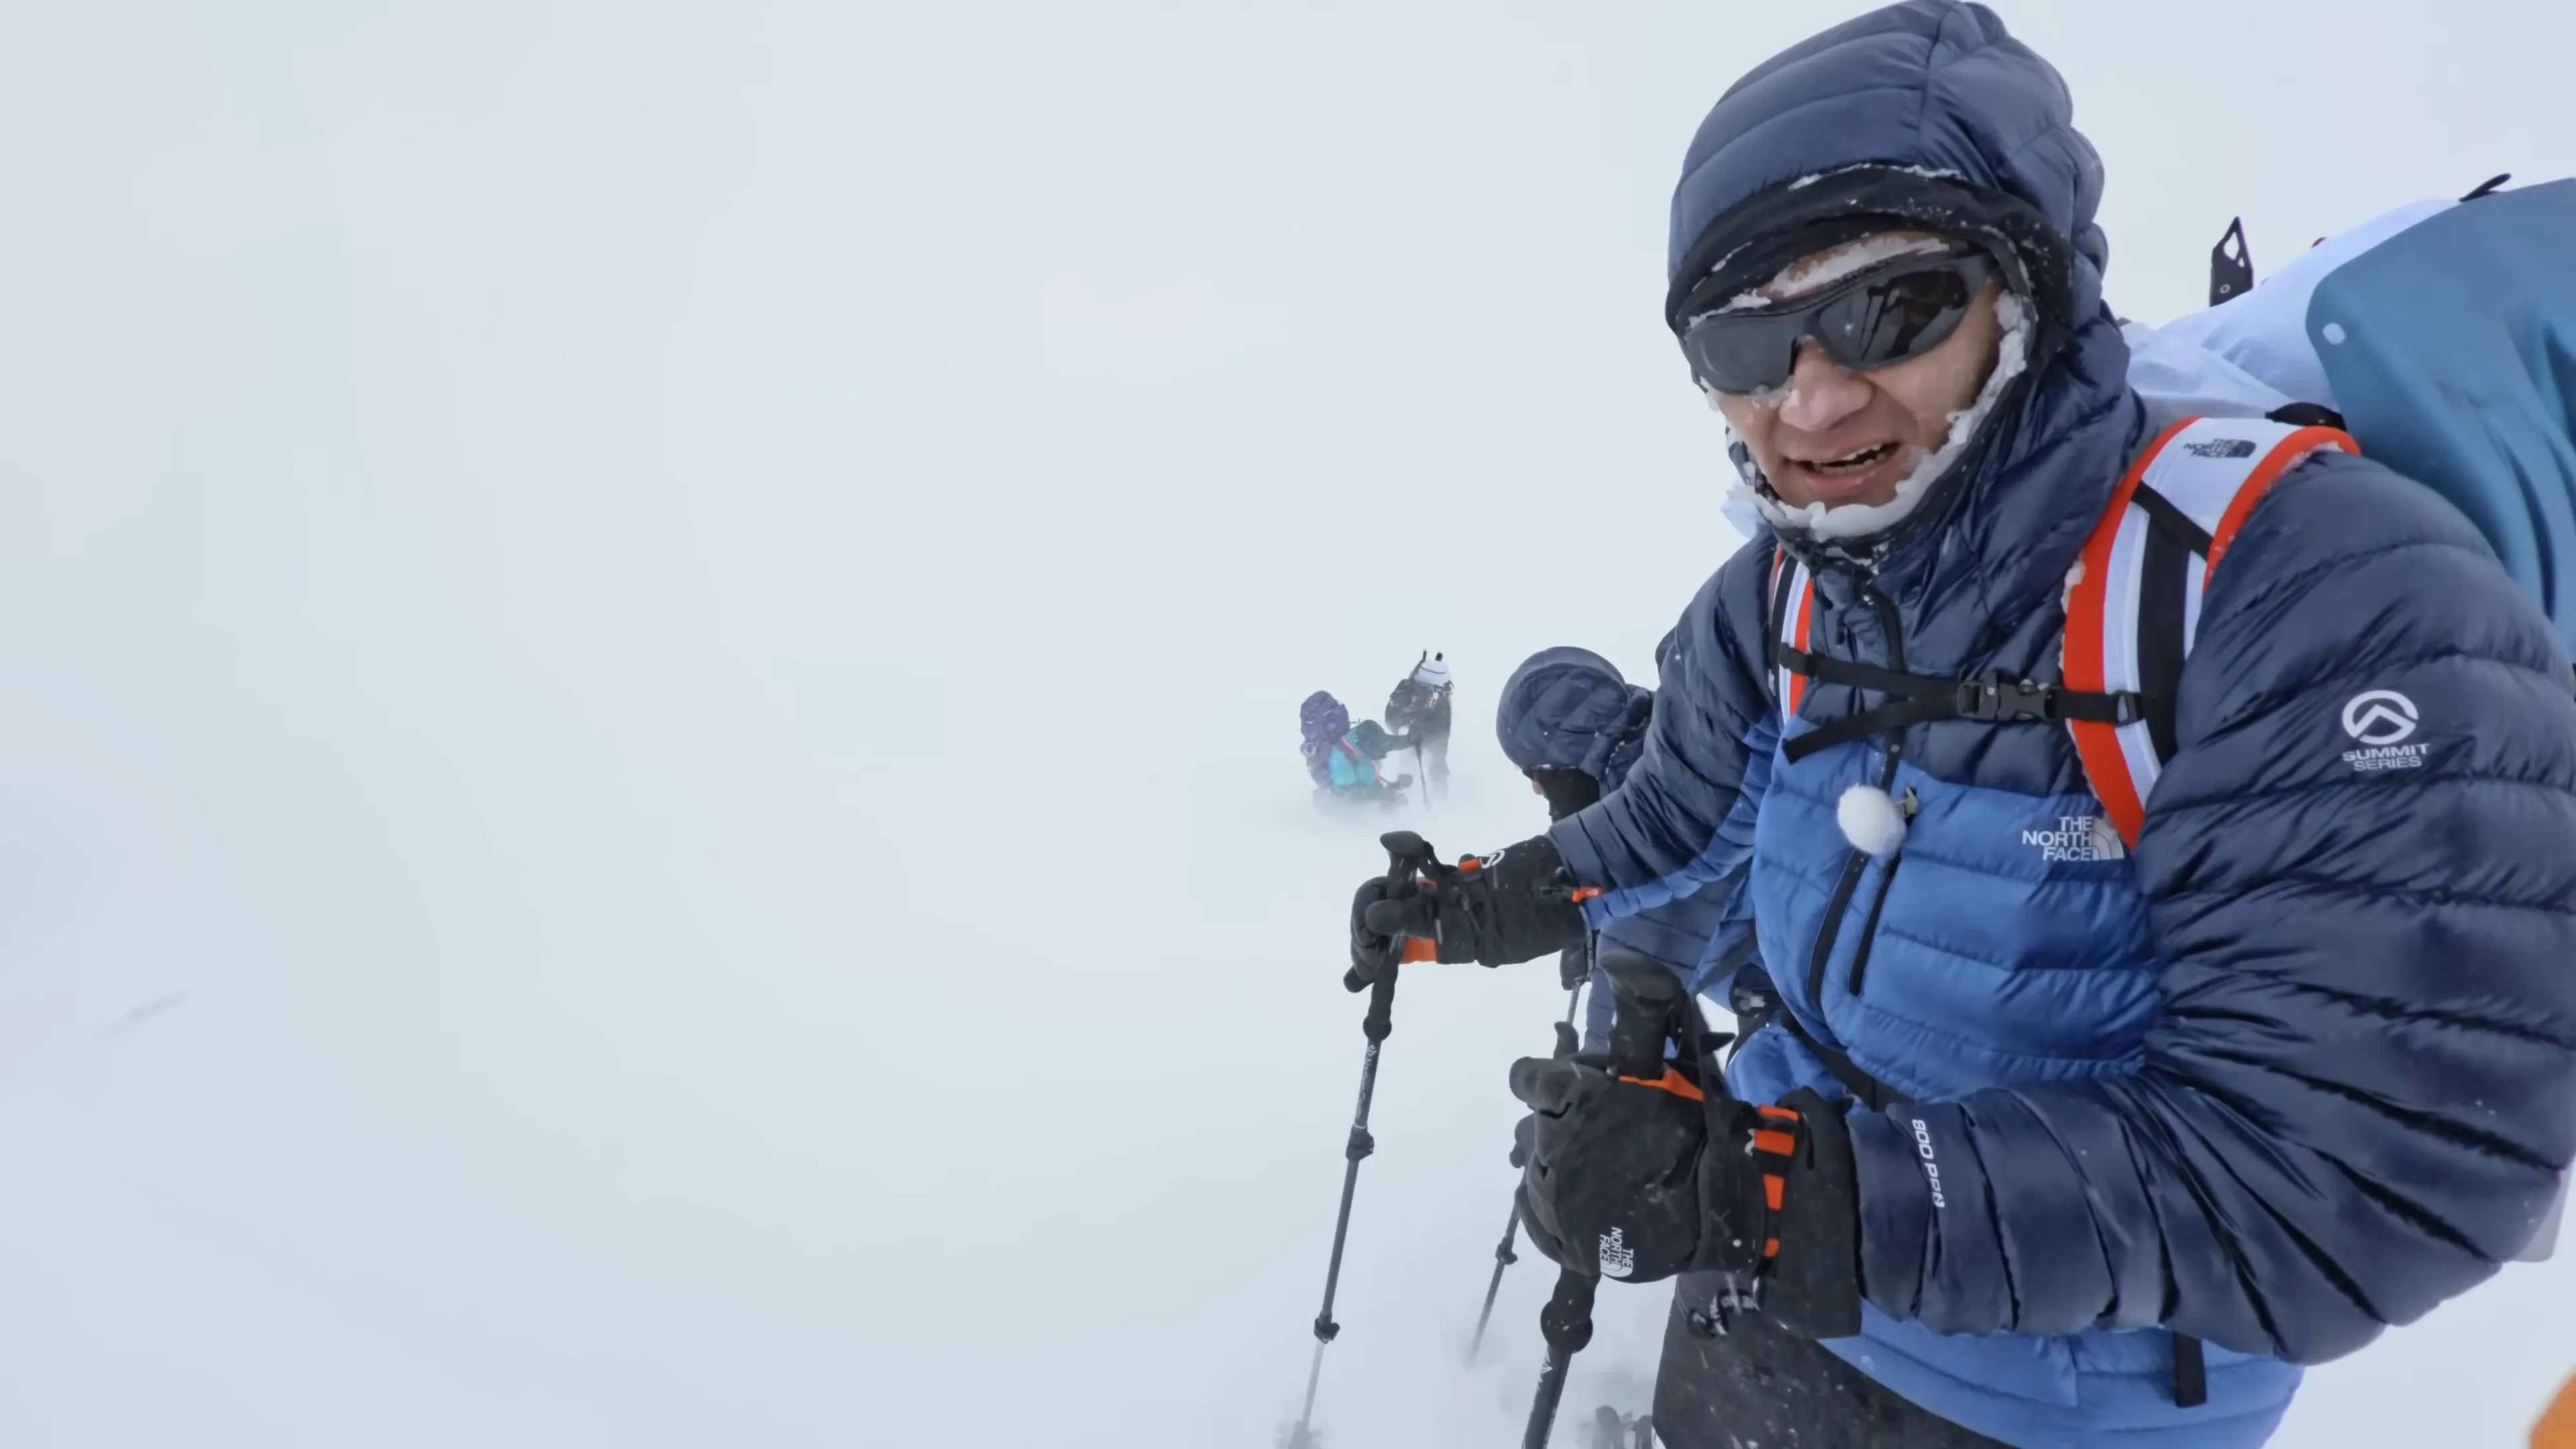
最喜欢的两个 UP 主终于同框啦!第一次同框就达到了我心中的年度最佳视频,历经坎坷,未知的风险,乐观的面对,互相鼓励,有好人的陌生人,以及,最特别的日出🌅,组成了人生最难忘的回忆
为什么要去想这些,比谁高,比谁快,比谁厉害,这是山,这不是社会。无论走到哪个高度,是不是登顶,山都会回馈你,它会给你这份只属于你的感受
2024 Gems of the year winners
https://obsidian.md/blog/2024-goty-winners/
Obsidian 官方博客发布了 2024 年度宝石奖(Gems of the Year)的获奖者名单,包括新插件、新主题、现有插件、工具、内容、模板和集成等多个类别的优秀贡献者。(我这种折腾了一堆主题插件,但是还没有正经写过笔记的,到底涂啥 🙉)
晒过阳光的被子
https://www.youtube.com/watch?v=lc7HiGCEW2Q
其实这个视频是讲螨虫的哈哈哈,但后面提到了晒过阳光被子的味道,确实让我比较好奇那个味道到底什么散发出来的,好闻,还有些香水味道是这个名字呢。
-
尘螨基本特征:属于蛛形纲动物,而非昆虫,长得像蜘蛛,有八条腿(幼螨六条腿,蜕壳后八条腿),体长0.1 - 0.5毫米,身体呈白色或淡黄色,有点透明 。
-
生活习性:常栖息于人类的床上、沙发、地毯及其他织物表面,平均寿命约三个月,条件适宜时一床被子上能滋生六百万只左右。主要以人或宠物的皮屑、分泌物为食,通过身体腺体吸收空气中的水蒸气补水。
-
对人类的影响:尘螨本身不咬人、不吸血,看似人畜无害,但它的排泄物和尸体是常见过敏原,可能引发打喷嚏、皮肤瘙痒、眼睛发痒甚至哮喘等症状。
-
去除尘螨的方法:常见方法有清理室内灰尘碎屑、清理晾晒床上用品等。不过,晒被子并不能烤焦螨虫,它们会躲到织物里层或阴凉面。
-
晒被子味道真相:晒被子时闻到的“阳光的味道”,并非螨虫尸体的气味,而是织物晾晒后产生的醛、酮、羧酸等有机化合物的气味。烤过的螨虫尸体闻起来有蛋白质的香味。
Refly
https://github.com/refly-ai/refly
Refly从创立之初就立志成为与Docker、K8S比肩的全球顶尖开源项目!他们的使命是为全球10亿创作者打造最优秀的AI原生创作工具,激发创意,加速创作!
有幸参与过内测,很不错的新一代白板内容创作工具,期待更好的发展~
随便玩玩
使用Caddy反向代理加速NotionNext博客图片访问
https://www.dolingou.com/article/caddy-reverse-proxy-for-notionnext-image-acceleration
-
Notion默认使用Notion图床,但由于Notion在国内没有服务器,访问速度较慢,尤其是图片加载延迟较高。
-
在国内访问包含大量图片的博客文章时,加载速度可能严重影响用户体验(LCP延迟约5秒)。
-
为了解决这一问题,尝试通过反向代理的方式加速图片资源的访问。
图片导致的博客延迟高确实是个肉眼可见的问题,特别是我还经常贴图,甚至是,高清图。正好有个 HK 低延迟的 vps,并且也是配置的 caddy 反代,所以就尝试一下。原文贴出的配置代码好像已经语法错误了:
INFO    using config from file  {"file": "/etc/caddy/Caddyfile"}
Error: adapting config using caddyfile: parsing caddyfile tokens for 'respond': unrecognized subdirective 'content_type', at /etc/caddy/Caddyfile:26
然后在 Deepseek R1 的帮助下修复了错误,在此之前使用了 claude 和 perplexity 都未给出正确的解决方案,Deepseek 真的好香,我哭死,既能推理还能联网 😭,修复后的配置如下:
notion.mwwlzz.top {
    # 1. 拒绝非授权域名请求
    @blocked {
        not host notion.mwwlzz.top
    }
    respond @blocked "403 Forbidden" 403

    # 2. 处理根目录请求
    @rootPath path /
    header @rootPath Content-Type "text/plain"
    respond @rootPath "OK" 200

    # 3. 配置反向代理
    @imagePath path_regexp imagePath ^/image.*$
    reverse_proxy @imagePath https://www.notion.so {
        header_up Host www.notion.so
        header_up Referer https://www.notion.so
        header_up User-Agent {http.request.header.User-Agent}
        header_up X-Real-IP {http.request.remote.host}
        header_up Accept-Encoding ""
        header_up Accept-Language {http.request.header.Accept-Language}
        transport http {
            tls
            tls_server_name www.notion.so
        }
    }
}
尝试访问 https://notion.mwwlzz.top/image/* 感觉延迟好像还是比较明显,看来封面图之后得压缩在上传了。
utools-qwen-ocr
https://github.com/huhusmang/utools-qwen-ocr
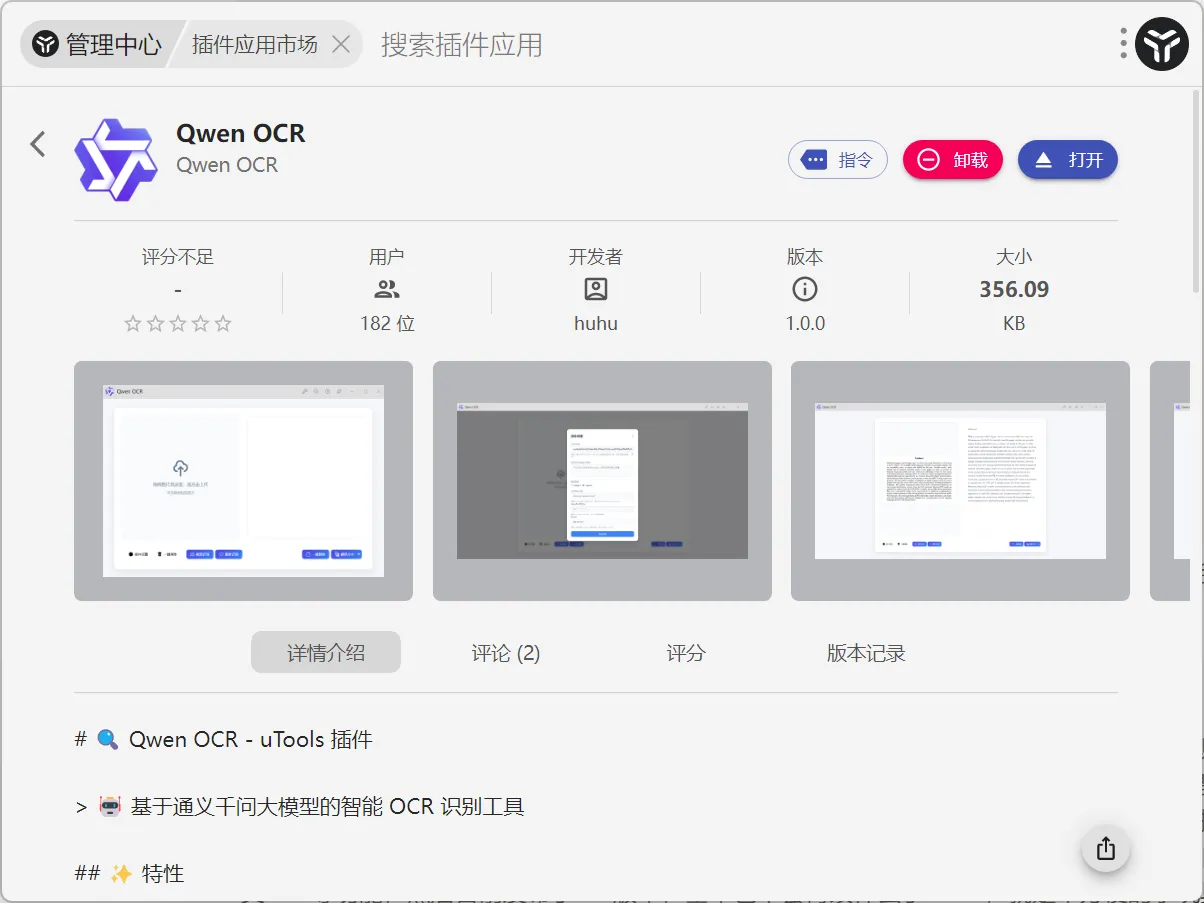
前段时间,看到有人逆向 qwen 的 openwebui 在线服务并提供了一个在线 OCR 的网站,发现效果还不错,相对于传统 OCR,可以设置提取的 prompt 以及识别提取规范的代码和数学公式,但是打开网页再 OCR 不方便。本地的工具是 Utools,也支持自定义插件,所以再 cursor 的帮助下很快搓了个 utools-qwen-ocr。开源之后佬友也迅速加了翻译等功能,还优化了 UI,我就在此基础上添加了自定义 API 等功能,然后目前发布了 1.0 版本,基本也不会再改什么了 hhhh,就是个方便的小玩具而已,加太多功能有点本末倒置了 😀
OhMyWeChat
https://github.com/chclt/oh-my-wechat
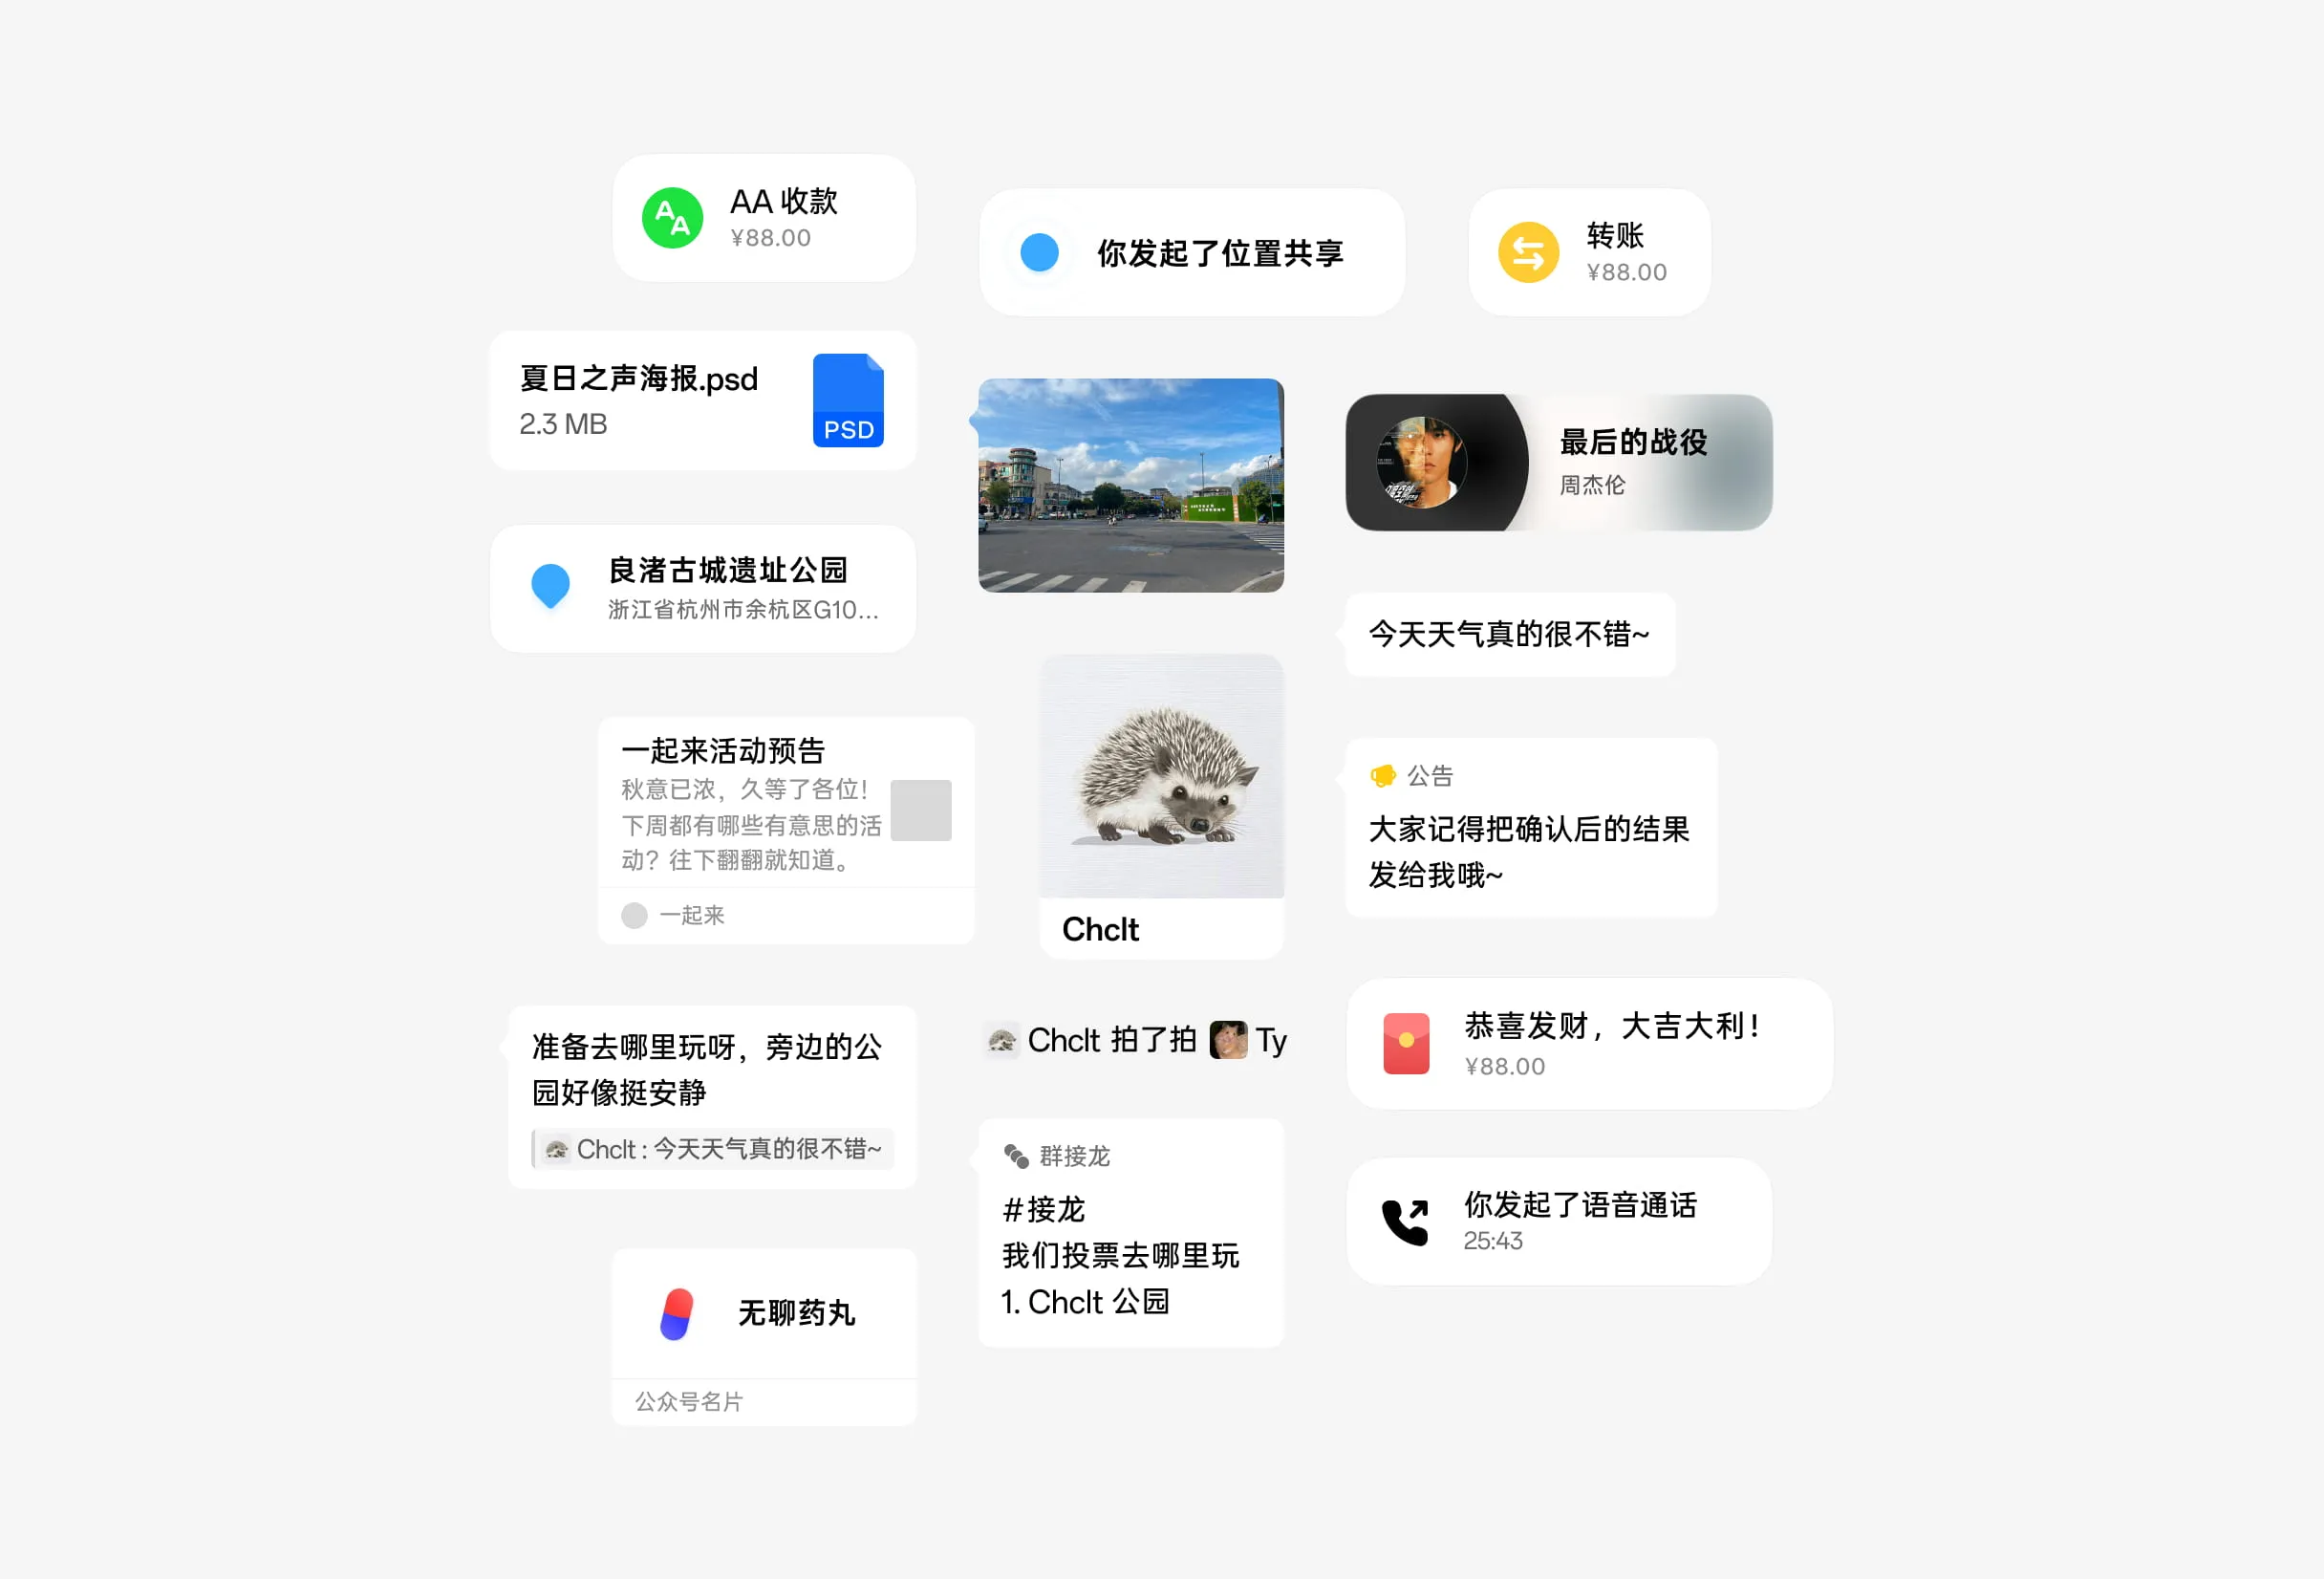
OhMyWeChat 是一个为微信设计的备份阅读器,旨在还原微信的功能并提供年度数据报告。UI 挺好看哎,可以试试~
随便说说
调研的论文看不进去,哎,被爆炸的信息流淹没了,些许浮躁
《影之刃零》蛇年贺岁实机演示,七星剑法看来好帅,期待明年的发售
我是 DeepSeek 写的:
暮色漫过光秃的枝桠时,我才惊觉腊月已至中旬。枝头最后几片枯叶在寒风中簌簌作响,像年历上即将撕尽的残页。今年冬假来得太迟,年节倒像被按下了倍速键。表亲们的寒暄裹挟着瓜子壳在暖空调里飘荡,程式化的吉祥话撞上手机屏幕又碎成散落的音节。孩子们举着仙女棒满屋疯跑,我配合着发出夸张的惊叹,指尖在糖果盘与充电线之间来回摩挲。朋友圈里雪山云海的九宫格突然闯入视线,老同学全家正裹着羽绒服追逐极光——这个画面倒让我真心笑出了声,或许来年真该把年货换成登机箱,让爆竹声化作行李箱滚过候机厅的轻响。
查看原文 😂
也许是今年放假晚的原因,刚放假不久刚觉就要过年了,也未感受到太多年味,还是重复的流程,和一年见一两次的亲戚寒暄几句,陪小孩玩,提不起兴趣。看朋友过年和家人出去旅游,这个确实挺适合我hhh