火锅店的小熊猫🐼糕点
🎶𝓦𝓮𝓮𝓴𝓵𝔂 𝓼𝓸𝓷𝓰 𝓹𝓲𝓬𝓴 🪗:
知识小品
ReFT: Reasoning with Reinforced Fine-Tuning
https://arxiv.org/pdf/2401.08967
https://github.com/lqtrung1998/mwp_ReFT
字节提出的 RFT(强化微调),好像也是第一个公开提出这个名词的,不得不说字节的 AI lab 真的很高产,影响力也都挺大!
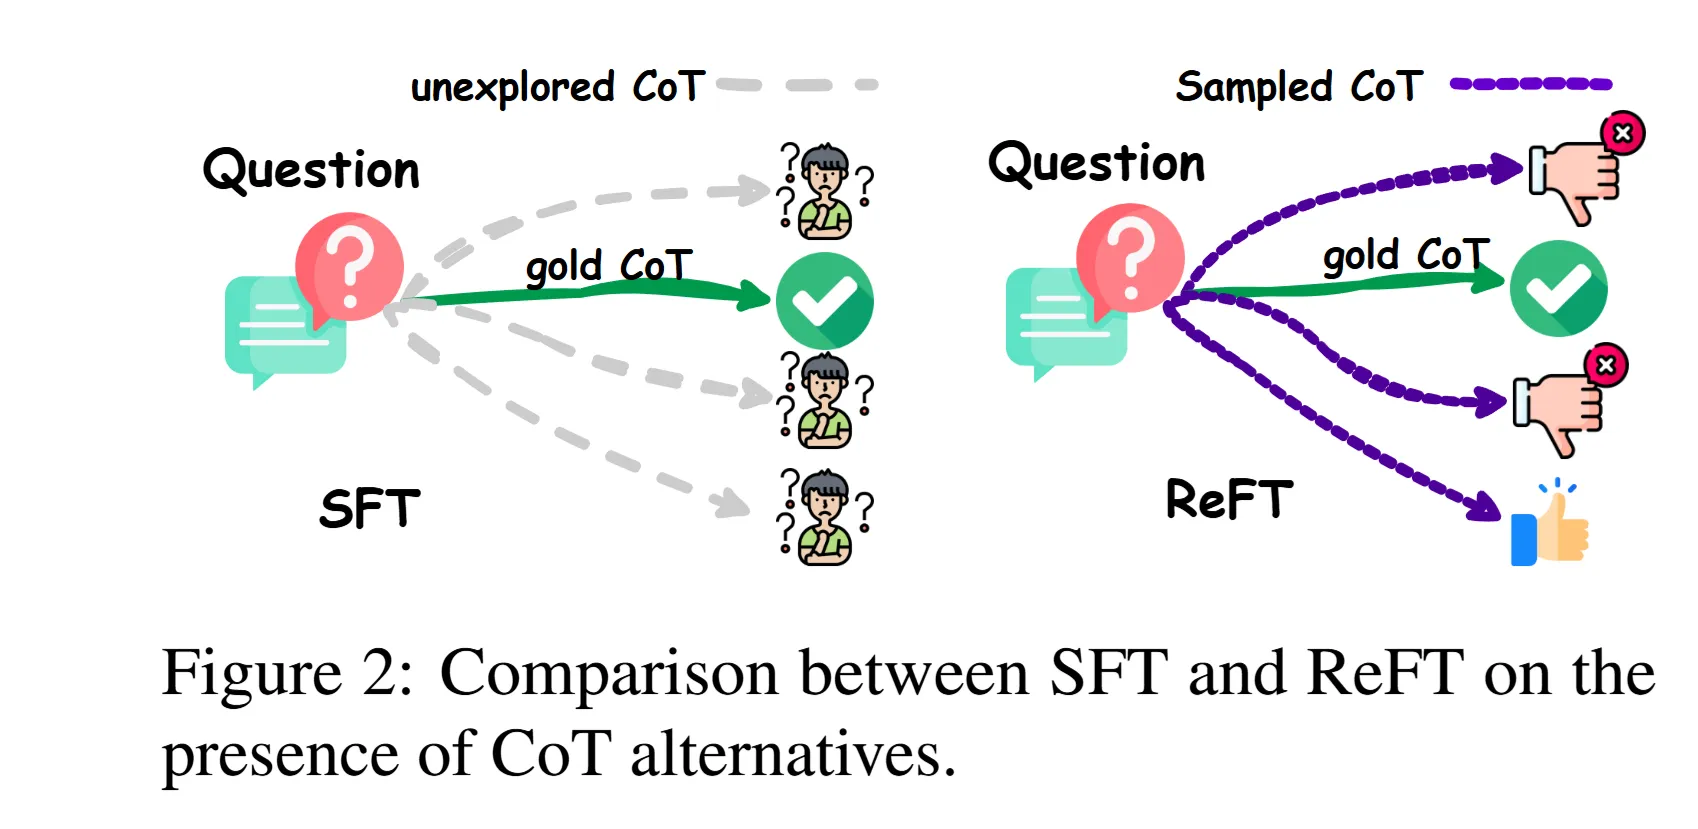
论文提出了一种名为Reinforced Fine-Tuning (ReFT)的新方法来解决大型语言模型在数学问题解决中的泛化能力问题。ReFT方法包含两个阶段:预热阶段和强化学习阶段。
-
预热阶段:
- 在这个阶段,模型通过监督微调在包含“问题和思考链”元组的数据集上进行微调。这个过程使得模型能够生成对数学问题的正确响应,从而为后续的强化学习阶段做好准备。
-
强化学习阶段:
-
在这个阶段,模型通过在线自我学习来提高性能,使用包含“问题和答案”元组的数据集。模型通过重复采样响应、评估响应答案的正确性,并在线更新其参数来进行学习。这里采用了近端策略优化(Proximal Policy Optimization, PPO)算法进行训练。
-
模型在强化学习过程中,会根据问题自动采样多个推理路径,然后从这些路径中提取答案,并与真实答案进行比较,以此来获得奖励。正确答案给予奖励1,错误答案给予奖励0(或部分奖励)。这种奖励机制使得模型能够从多个有效的推理路径中学习,从而提高了模型的泛化能力。
-
自行采样多个 CoT 路径(含负例和正例),除了多次合成路径外,还通过多数投票、奖励模型重排序方法来提升搜索的路径质量。
部分奖励:ReFT将推理正确打分为1,推理失败打分为0,不正确的结果打分为0.1。这样可以缓解稀疏奖励的问题,提升训练稳定性,鼓励模型探索更多的推理路径。
FullStackBench
https://huggingface.co/datasets/ByteDance/FullStackBench
https://github.com/bytedance/SandboxFusion
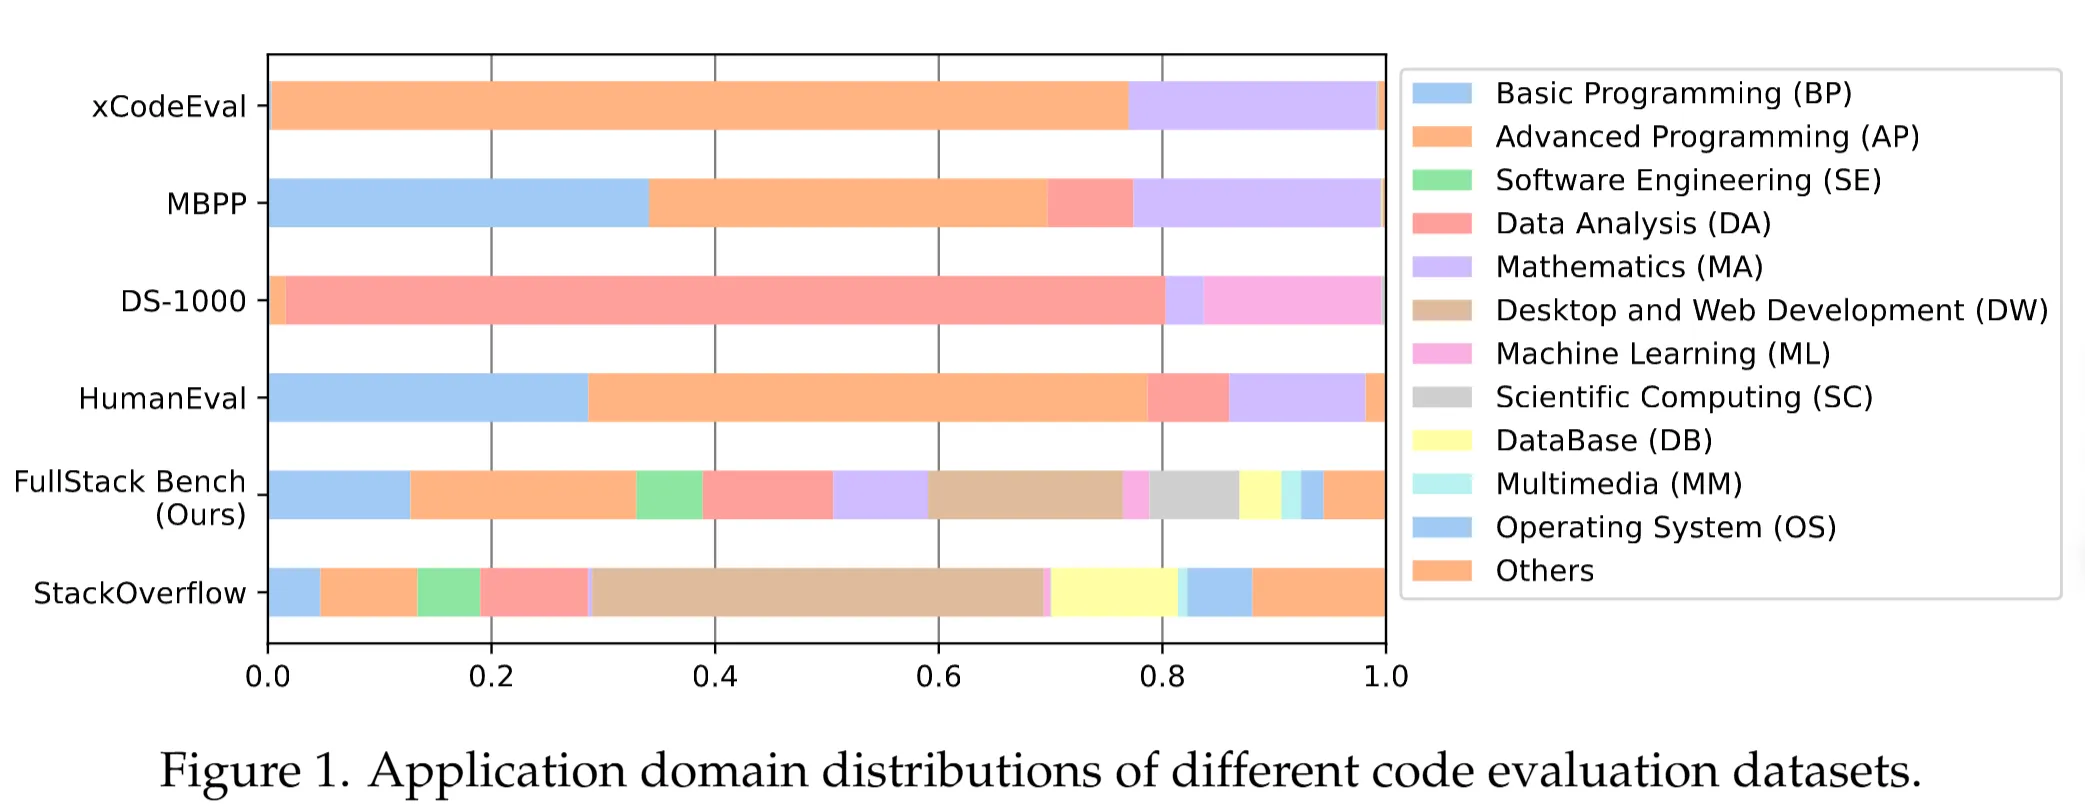
FullStackBench是一个全栈编程基准测试,涵盖了16种编程语言和3000多个测试样本,旨在评估大语言模型在真实世界代码开发场景中的编码能力。因为还是老问题,现在主流模型发布的时候,还是基本上使用的是 HumanEval Benchmark,但这个指标基本上没什么用处了,目前还有价值的比如 aider 的 code edit 指标以及 swe-bench,还有 livebench,但是 swe-bench 是公开可训练的,以及livebench 应该也不是能够反应真实世界代码开发场景的,所以挺需要一个比较复杂的数据集的。我当时毕设做的是收集最新的 Leetcode 中比较困难、具有复杂数据结构和算法的题目,但还是不能反应真实的代码开发场景 😶🌫️(能力有限,因为我认为这种工作工作量还是挺大的,而且得确保数据的正确性,所以也得很专业!)
除了 Benchmark,字节还配套开源了一个评估框架SandboxFusion,一个安全的沙箱环境,用于运行和评判由大语言模型生成的代码,提供了代码运行和在线评判的功能,支持多种编程语言。尝试了一下在线的框架,功能非常完备啊!不仅支持 FullStackBench 的评估,还支持目前的一些经典 Benchmark,比如 HumanEval 等,大气!
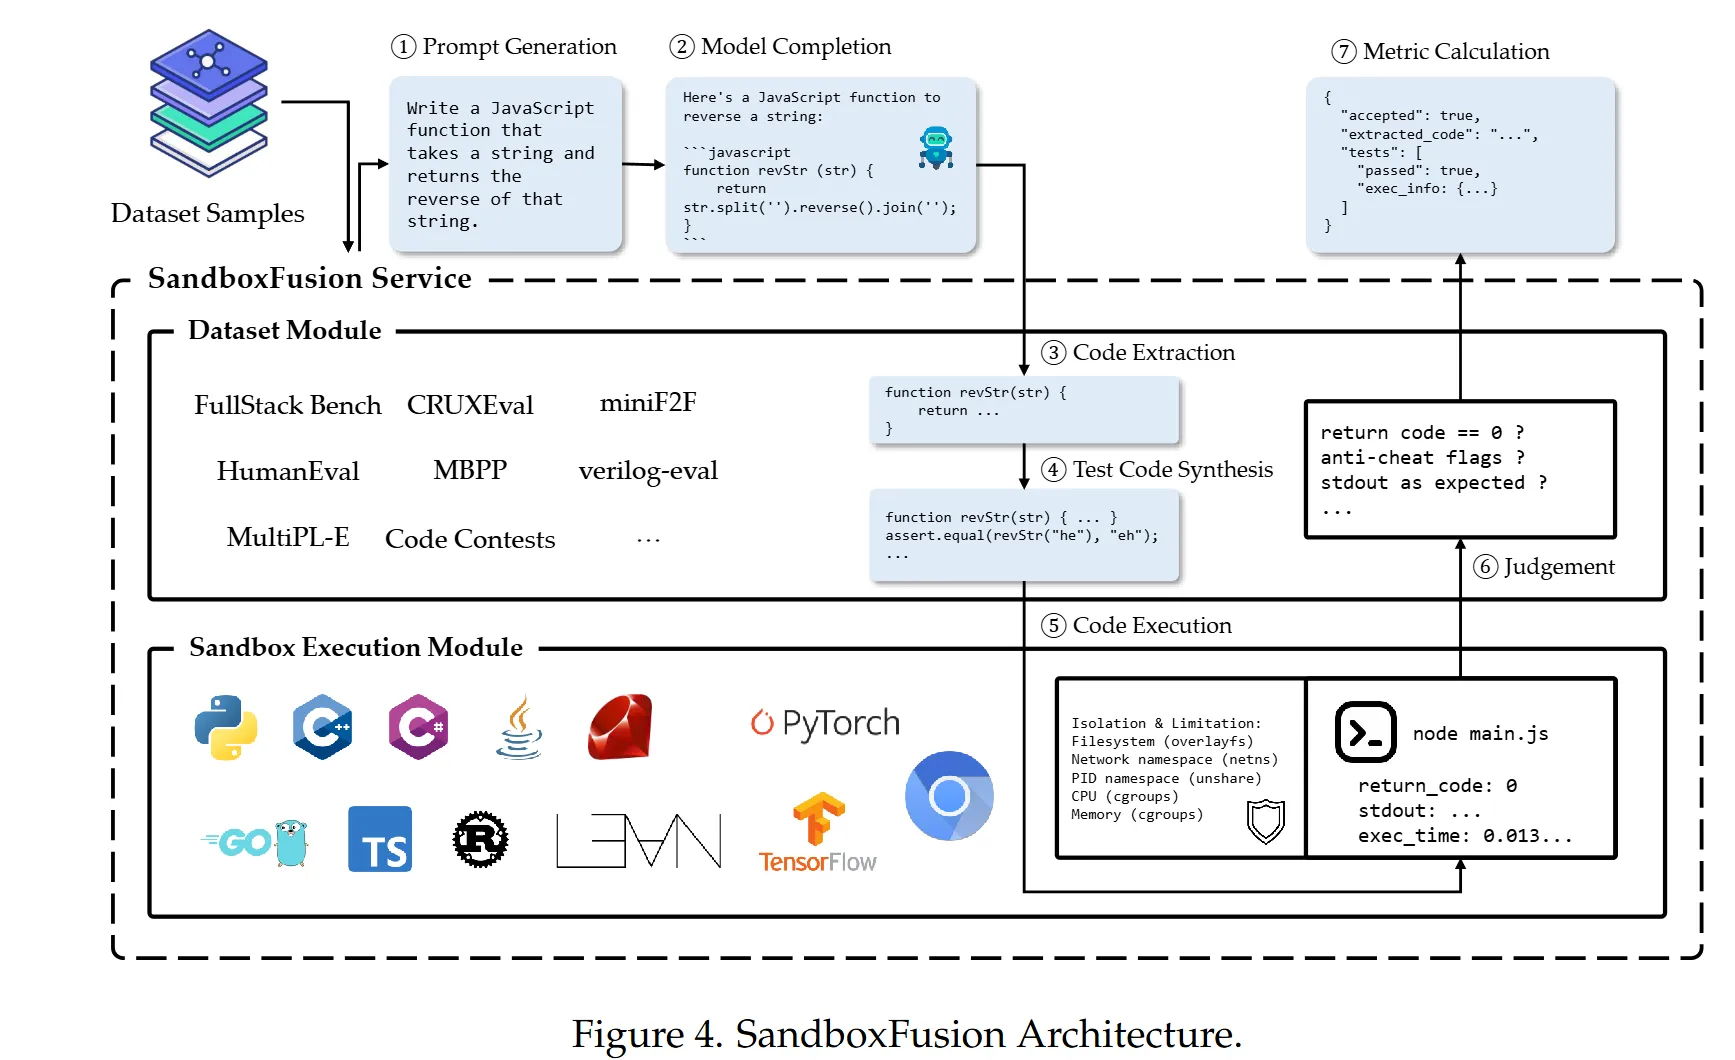
不得不说这七个流程和我毕设做的评估框架的流程是一模一样的,哈哈哈哈 😝,在实现的过程中其实我认为比较难的就是第三步代码提取和第五步代码执行。代码提取难是因为 LLM 不会按照你预期定义的格式返回答案,需要从输出的文本中提取相关的代码,这里不规则的情况有很多种:
-
文本 + 代码,相混合
-
代码格式不统一,要求是生成一个函数,但可能生成一个完整的文件
-
冗余的代码块
-
……
大致看了一下代码提取的方式是通过多层次的正则提取的:
class ExtractedType(Enum):
    Fenced = 'fenced'
    IncompleteFenced = 'incomplete_fenced'
    Heuristic = 'heuristic'
    Empty = 'empty'

class CodeBlock(BaseModel):
    priority: int
    language: str
code: str-
完整代码块提取:
def extract_fenced_code(completion: str) -> List[CodeBlock]: # 使用正则表达式匹配完整的代码块 code_matches = re.findall(fenced_code_block_pattern, completion) results = [] for m in code_matches: lang = aliases_to_language_tiled.get(m[0].strip(), '') results.append(CodeBlock(priority=30, language=lang, code=m[1])) return results -
不完整代码块提取:
def extract_incomplete_fenced_code(completion: str) -> List[CodeBlock]: code_matches = re.findall(incomplete_fenced_code_block_pattern, completion) results = [] for m in code_matches: lang = aliases_to_language_tiled.get(m[0].strip(), '') results.append(CodeBlock(priority=20, language=lang, code=m[1])) return results -
启发式代码提取:
def extract_heuristic_code(completion: str, language: NullableLang = '') -> List[CodeBlock]:
    def extract_py(text):
        code = "\\n".join([line for line in text.split("\\n") if line.strip() != ""]) + "\\n"
        pattern_py = "(?:^(?:import|from|#)[^\\n]+\\n)*" \\
            "^(?:def|class) [^\\n]+\\n" \\
            r"(?:\\s+[^\\n]+\\n)+"
        matches = re.findall(pattern_py, code, re.M)
        return matches

    def extract_sql(text):
        code = "\\n".join([line for line in text.split("\\n") if line.strip() != ""]) + "\\n"
        pattern_sql = r"^\\s*(?:select|with\\s[^\\n]+as)[^;]*"
        matches = re.findall(pattern_sql, code, re.M | re.IGNORECASE)
        return matches

    # 根据不同语言使用不同的提取逻辑
    if language == 'python':
        return [CodeBlock(priority=10, language='python', code=m) for m in extract_py(completion)]
    elif language == 'sql':
        return [CodeBlock(priority=10, language='sql', code=m) for m in extract_sql(completion)]
    elif language == 'bash':
        return [CodeBlock(priority=10, language='bash', code=completion)]
    else:
        return []
但我认为最 general 的方法是通过代码的语法树提取所需的代码
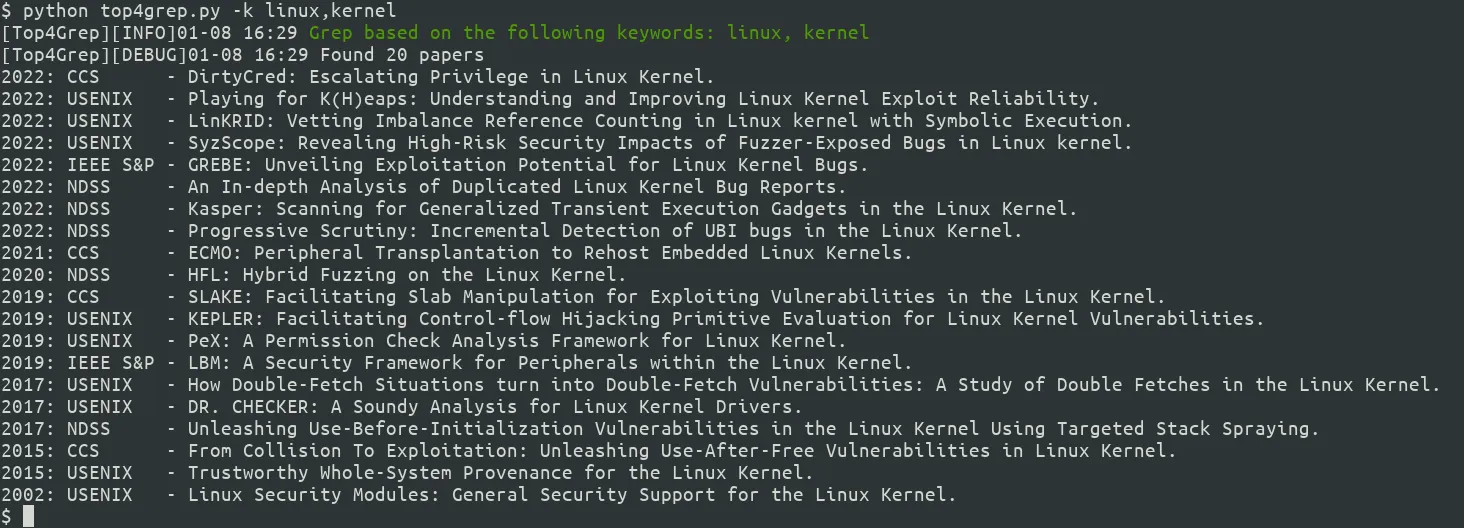
top4grep
https://github.com/Kyle-Kyle/top4grep
top4grep 是一个用于搜索顶级安全会议(S&P、USENIX、CCS、NDSS)发表的论文的 grep 工具。它可以帮助用户快速查找感兴趣的论文。
-
初始化论文数据库: 用户可以通过
top4grep --build-db命令重新构建论文数据库。 -
关键词搜索: 用户可以通过
top4grep -k <关键词>命令搜索包含指定关键词的论文。 -
支持多关键词搜索: 返回的结果必须包含所有输入的关键词。
scholarly
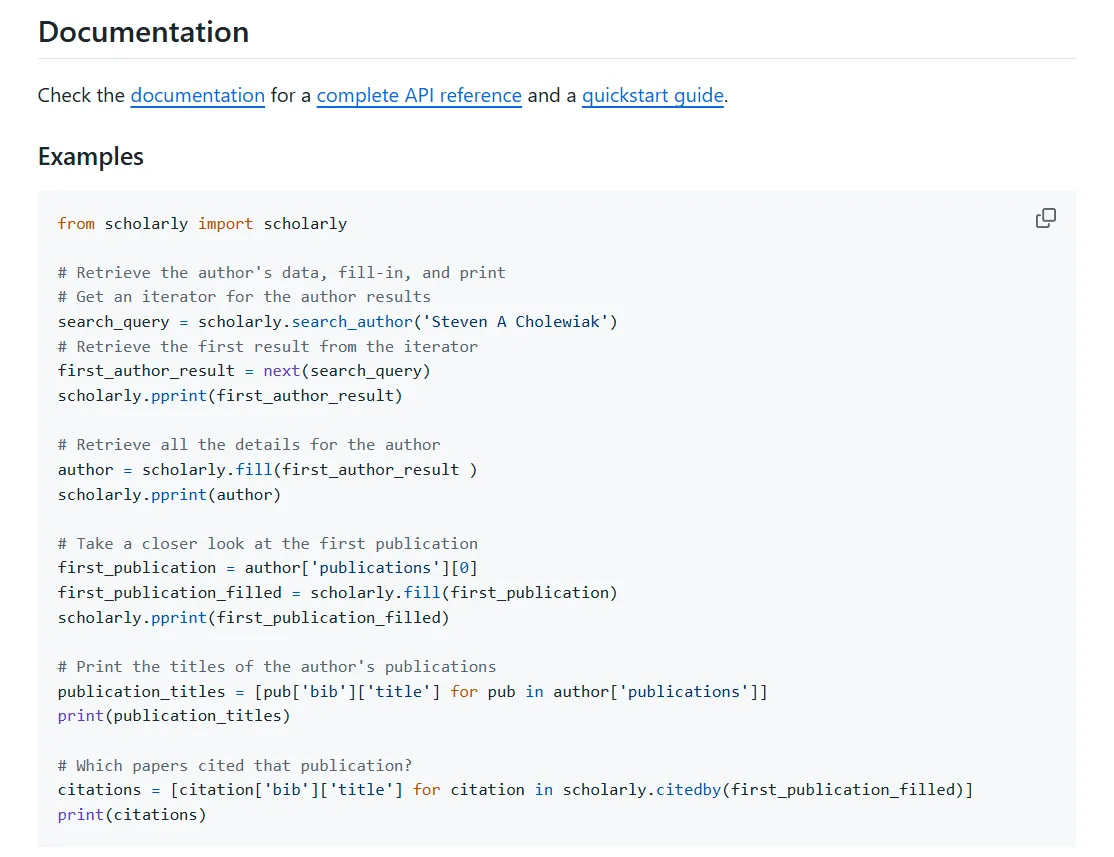
https://github.com/scholarly-python-package/scholarly
scholarly 是一个 Python 模块,可以以友好、Pythonic 的方式从 Google Scholar 检索作者和出版物信息,无需解决验证码问题。
-
从 Google Scholar 检索作者和出版物信息
-
以友好、Pythonic 的方式获取信息,无需解决验证码问题
-
支持使用代理服务绕过反爬虫措施
-
提供丰富的 API 供开发者使用
DSPy
https://github.com/stanfordnlp/dspy
DSPy是由斯坦福大学开发的开源框架,用于以编程而非提示工程的方式来使用大型语言模型,主要特点:
-
DSPy (Declarative Self-improving Python) 将与语言模型的交互转变为编程范式,而不是传统的提示工程方法。
-
主要功能:
-
允许快速迭代构建模块化AI系统
-
提供算法来优化提示词和权重
-
支持构建从简单分类器到复杂的RAG(检索增强生成)管道和Agent循环
-
-
应用场景:
-
构建分类器系统
-
开发检索增强生成(RAG)管道
-
创建智能体(Agent)循环系统
-
优化模型提示和权重
-
DSPy的目标是提供一个更系统化、更可编程的方式来使用大语言模型,使开发者能够以更结构化的方式构建和优化AI系统。
phply
https://github.com/viraptor/phply
phply 是一个使用 PLY(Python Lex-Yacc)编写的 PHP 编程语言解析器。它可以将 PHP 代码转换为 Python 或 Jinja2 代码。
-
提供与标准 PHP 词法分析器完全匹配的词法分析器
-
提供大部分 PHP 语法的解析器和抽象语法树
-
提供将 PHP 源代码转换为 JSON 格式抽象语法树的脚本
-
提供将 PHP 源代码转换为 Jinja2 模板的实验性脚本
随便看看
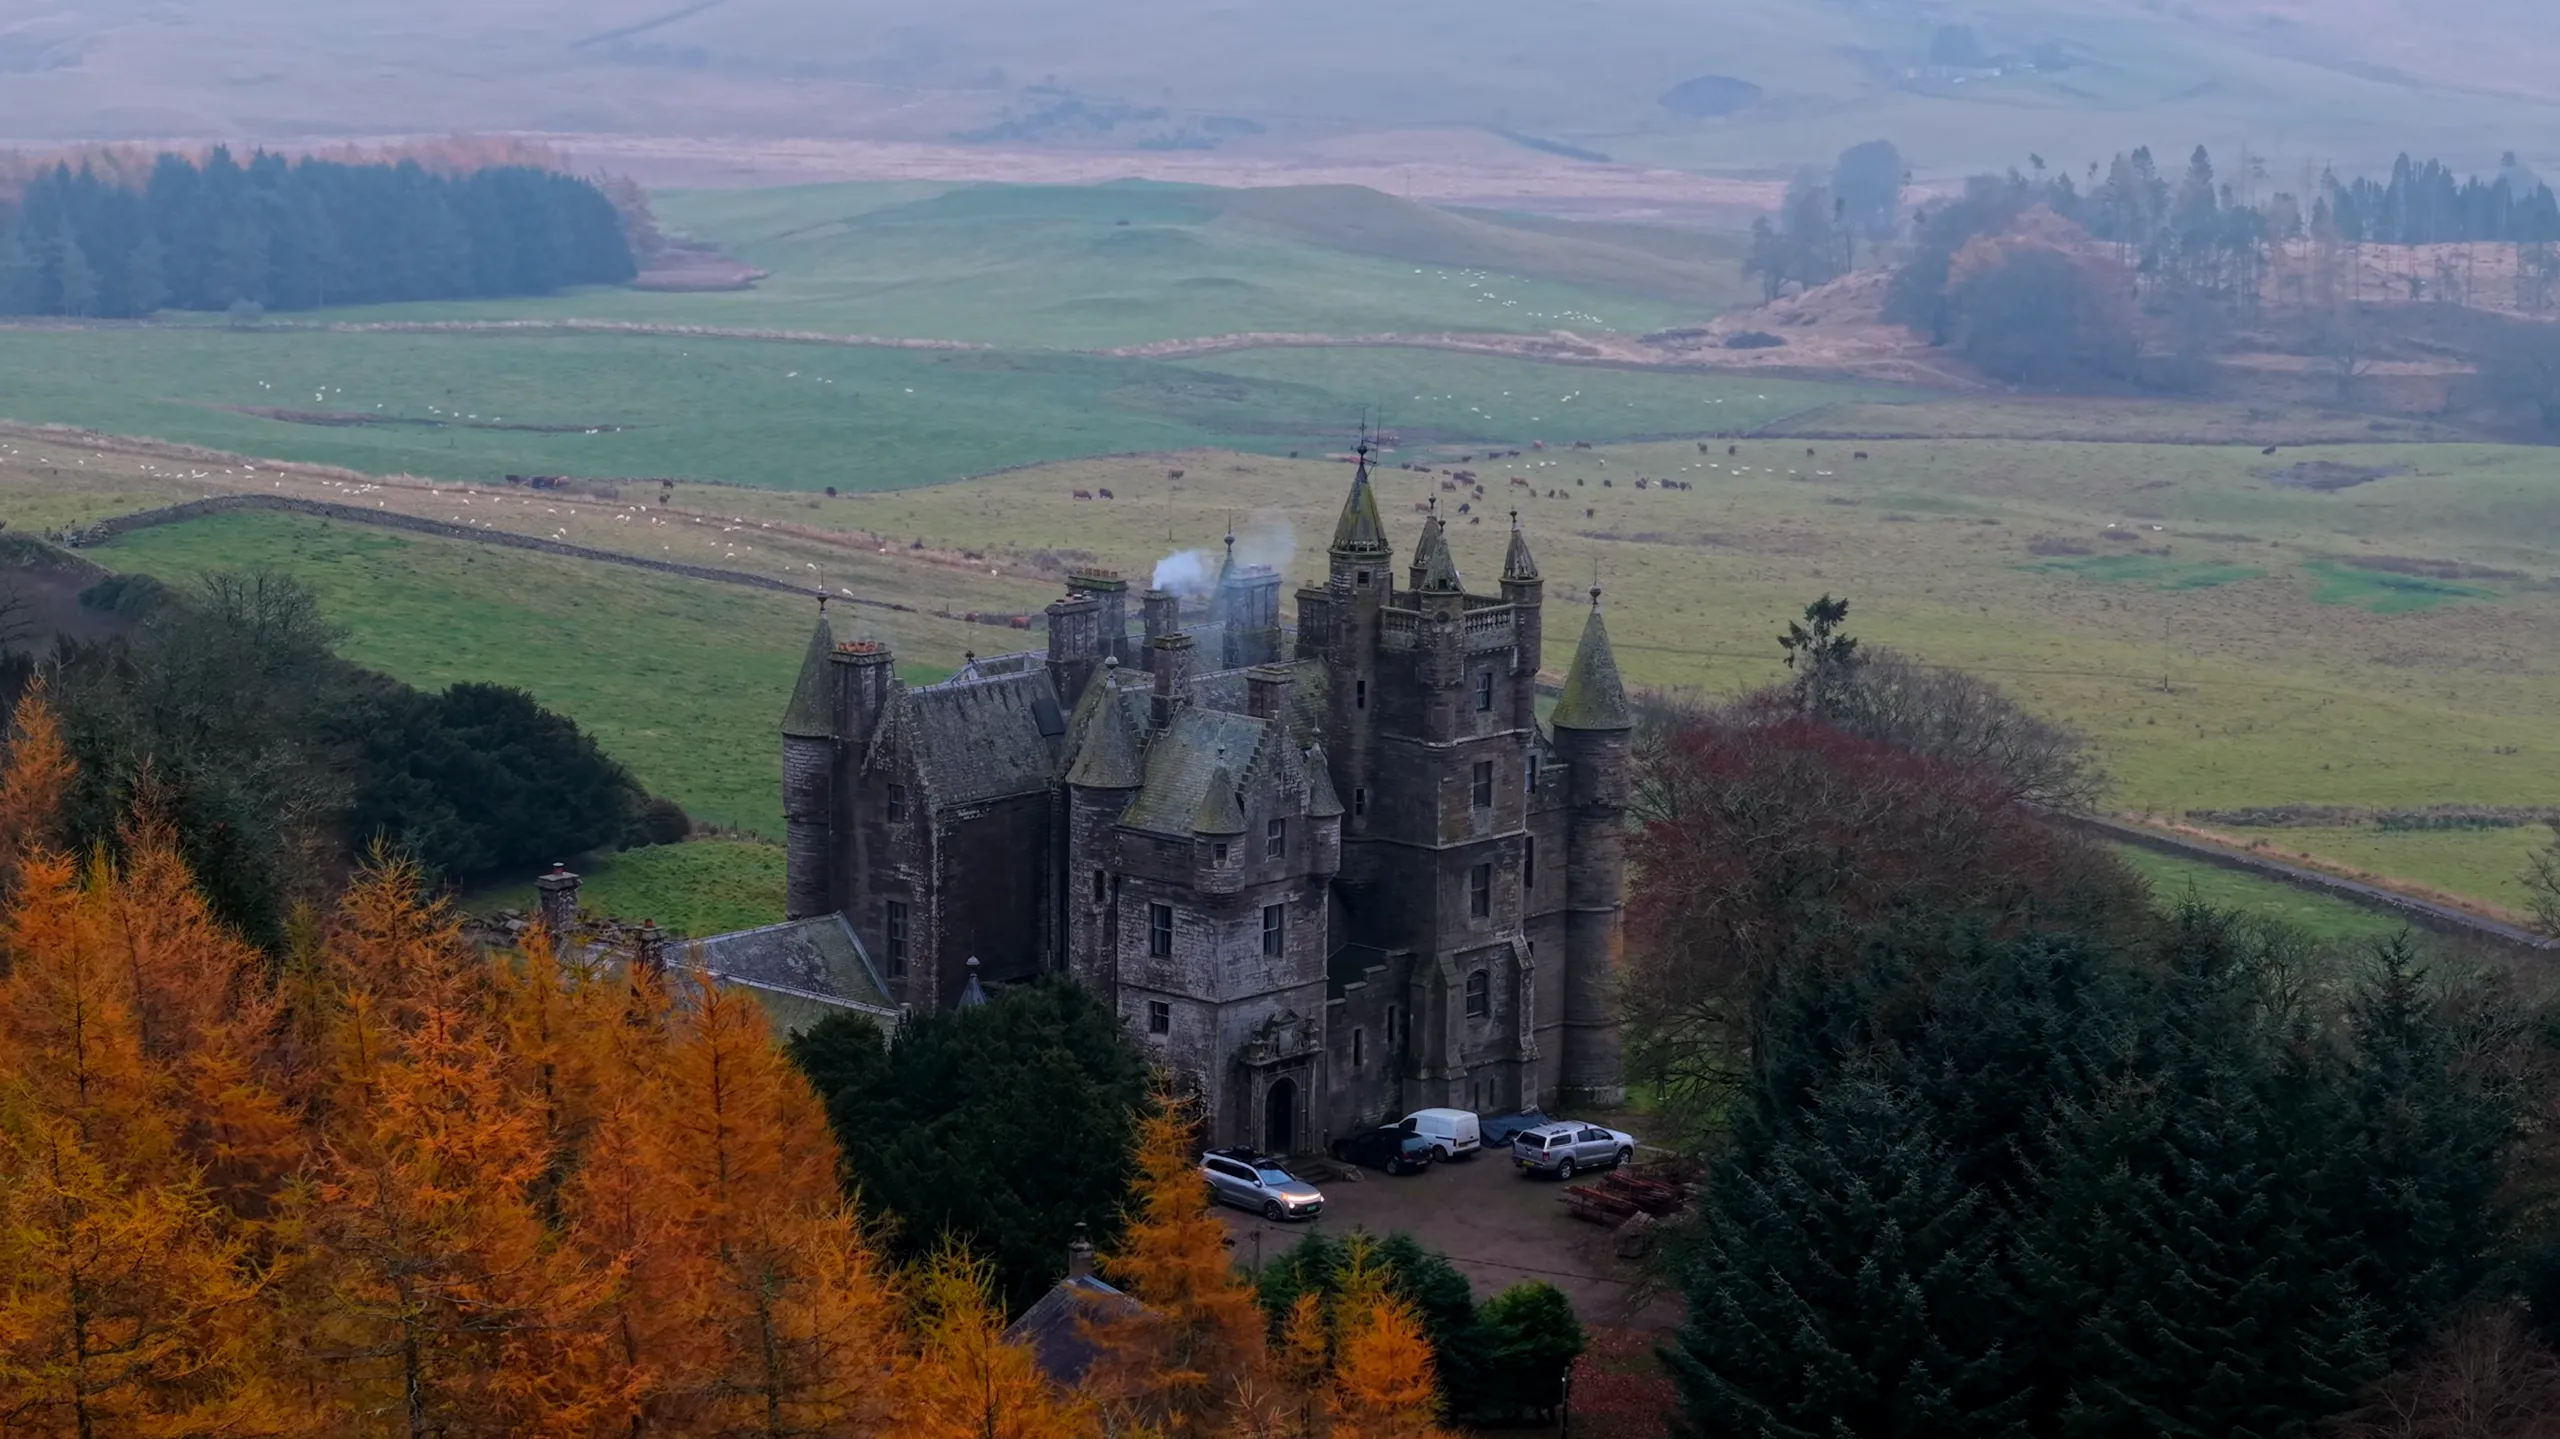
Links 又又又更新啦!这真的是太棒啦!(突然顺出来宝剑嫂的语调 😬)。视频还是一如既往的高质量,没得说,百年的古堡,在夜晚难免让人害怕,Links 住的古堡建于 1870 年,曾是贵族狩猎时居住的地方!好家伙,里面是真大,走廊里挂的是兽头,墙壁上是经典的西方人画像,感觉我住这里得睡不着觉,感觉有无数双眼睛盯着我 😱。视频最后的环境真的好惬意,外面是阴暗潮湿的下雨天,车内温馨暖和的小空间,满满的舒适感,不得不说这个视频还真的被理想种草了,但,我还是个穷学生 🤣🤣🤣
随便玩玩
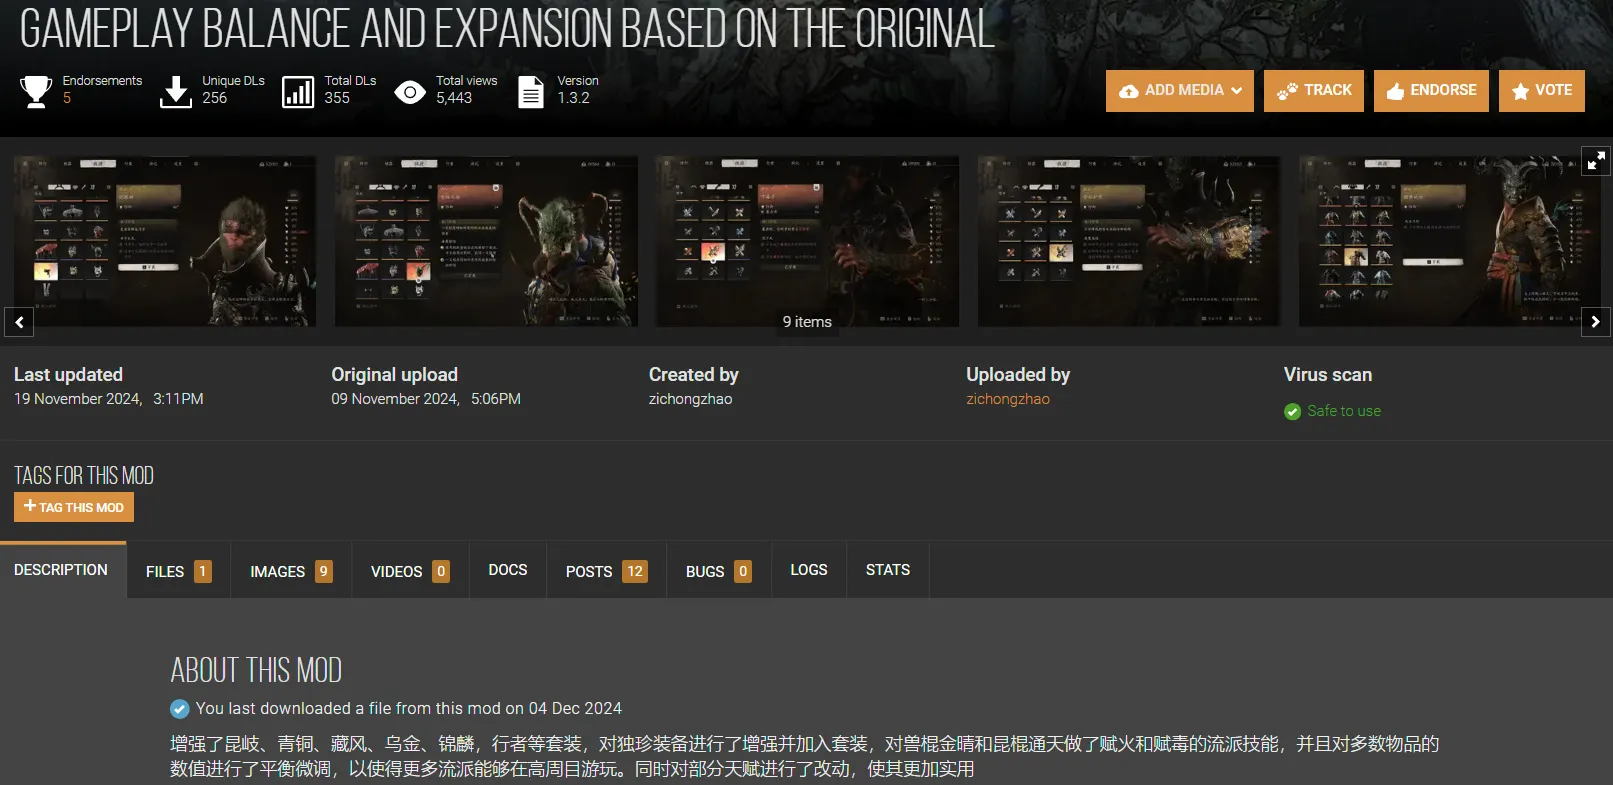
最近终于通关了黑神话一周目,四个月才玩完,时长为但是成就还没有收集完,而且感觉自己的手法还在逐渐🐂🍺(看我识破),所以果断开启二周目。二周目想试试 mod 了,下载了一个这个 mod,微增强武器和法宝等,还有一些皮肤 mod,后面再试试
随便说说
这周基本都在忙课内作业和准备考试,周日考完了英语,好难🤯,选择和排序看不懂一点。
这周吃到了最贵最难吃的烧烤,起因看到了一篇小红书的(超级虚假)帖子,说学校附近有一家(无)五榜第一的 烧烤店,然后就去了,结果又贵又难吃!!!一小盘炒的花生米十四块钱,什么概念!气得我直接举报那个帖子 🤬
OpenAI 正在进行他的为期十二天的直播,没想到周末不加班,凎,不过目前发布的 200$ 对我也没什么价值,穷学生不敢多看一眼 👻