Tree-sitter 是什么?
在软件开发领域,理解和操作代码的结构至关重要。无论是语法高亮、代码导航,还是更高级的静态分析和代码重构,都离不开对代码的精确解析。Tree-sitter 正是为此而生的一个强大的工具,它是一个通用的解析器生成器和增量解析库,能够为各种编程语言构建具体的语法树,并在代码编辑过程中高效地更新这些语法树 。
Tree-sitter 的核心在于其能够以高效且可靠的方式理解代码结构。它主要通过以下几个关键功能实现这一点:
-
解析器生成器和增量解析库: Tree-sitter 不仅是一个能够根据语言文法生成解析器的工具,更是一个在代码发生变化时能够智能地、只重新解析修改部分的库 。这种增量解析的能力使得在文本编辑器中进行实时代码分析成为可能。
-
具体的语法树(Concrete Syntax Tree, CST): Tree-sitter 将源代码解析成一棵包含代码中每一个词法单元(token)信息的具体语法树 。与抽象语法树(Abstract Syntax Tree, AST)不同,CST 保留了源代码的所有细节,这对于需要精确理解代码结构的应用场景非常有用。
-
查询语言: Tree-sitter 提供了一种简洁的、基于 S-表达式的查询语言,允许开发者方便地在生成的语法树中查找特定的代码模式 。这种查询能力是实现语法高亮、代码导航等功能的基础。
-
语言绑定: 为了方便在不同的编程环境中使用,Tree-sitter 提供了多种语言的绑定,包括官方支持的 C#, Go, Haskell, Java, JavaScript, Kotlin, Python, Rust, Zig,以及社区贡献的更多语言绑定 。这使得开发者可以使用自己熟悉的编程语言来操作 Tree-sitter。
Tree-sitter 的语法系统
Tree-sitter 语法本质上是一个 grammar.js 文件,这个文件用 JavaScript 描述语言的语法规则。虽然语法规则是用 JavaScript 描述的,但这只是用来生成最终 C 程序的中间描述。编写完 grammar.js 文件之后,使用 tree-sitter generate [OPTIONS] [GRAMMAR_PATH] 命令即可生成对应语言的解析器。
tree-sitter generate读取当前工作目录中的grammar.js文件,并创建一个名为src/parser.c的文件,该文件实现了分析器。更改语法后,只需再次运行tree-sitter generate。1
经过观察,在 src 目录下还有几个固定的文件,比如 grammar.json 等,在官方的文档中并没有找到明确的说明 grammar.json 来源,但是在一些 issue 中可以看到核心开发者的说明:
grammar.jsonis generated withtree-sittergenerate (along with everything insrcminusscanner.c)
所以,执行 tree-sitter generate 命令后,Tree-sitter 工具链会处理 grammar.js 文件,并在 src/ 目录下生成多个文件,包括 grammar.json 以及解析器的 C 代码。
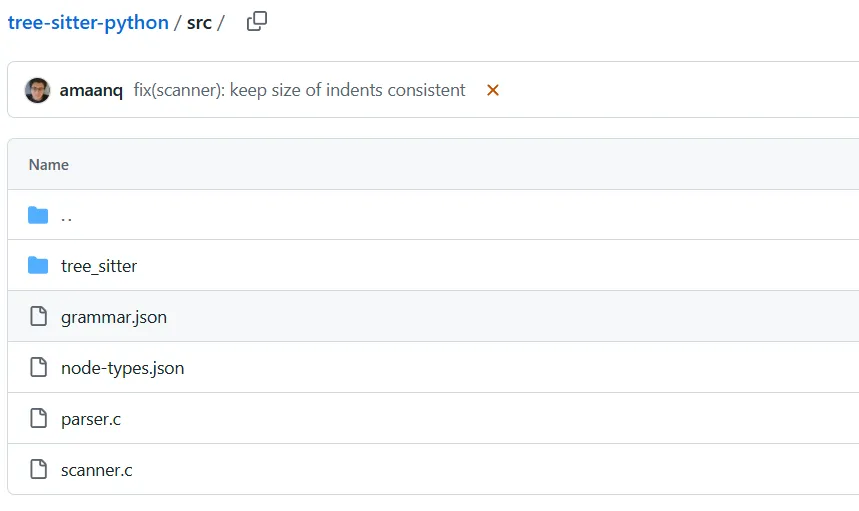
所以,grammar.json 是从 grammar.js 文件自动生成的,生成过程如下:
-
首先,开发者在 JavaScript 文件
grammar.js中定义语言语法规则 -
当运行 Tree-sitter CLI 命令
tree-sitter generate时,Tree-sitter 工具会:-
解析
grammar.js文件 -
提取语法规则
-
将这些规则转换为标准化的 JSON 格式
-
自动生成
src/grammar.json文件
-
对于 grammar.json ,因为其组织方式是 json,所以通过这个文件来学习对应语言的语法解析规则较于 grammar.js 是容易的。但是对于其存在的具体作用,下面是 AI 搜索给出的答案:
grammar.json文件扮演着重要的角色:
中间表示:它作为 JavaScript 语法定义和最终 C 解析器代码之间的中间表示
规则标准化:提供了语法规则的标准化表示
解析器生成:Tree-sitter 的解析器生成器使用这个文件来生成实际的解析器代码
跨平台兼容:JSON 格式确保语法定义可以在不同平台和工具之间共享
grammar.json 的构成
一个完整的grammar.json 通常包含一万行左右的规则定义,所以如果要全部理解不同 statement 的语法还是需要学习一段时间的。不过全部学习也不是必要的,因为不同 statement 的语法规则声明方式是类似的,所以可以掌握基本的定义方式,直接搜索需要处理的 statement 即可。下面通过 PHP 语言的 grammar.json 来分析具体的内容。
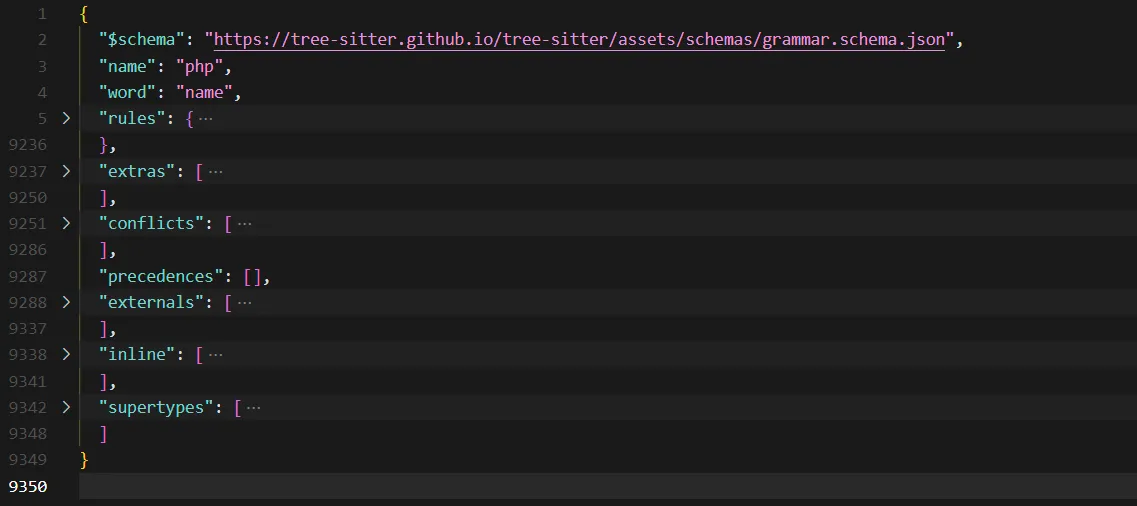
grammar.json 的结构和组织方式是通过 $schema 字段指向的 URL 规定的,JSON Schema 文件描述了 Tree-sitter 语法的结构和规则,下面是一个 grammar.json 应该包含的顶层键以及对应内容的类型:
-
$schema:- 类型为
string,表示 schema 的 URL。
- 类型为
-
name:-
描述语法的名称。
-
类型为
string,必须匹配正则表达式^[a-zA-Z_]\\w*,即以字母或下划线开头,后面可以跟字母、数字或下划线。
-
-
inherits:-
可选字段,表示继承自的父语法名称。
-
类型为
string,同样需要匹配正则表达式^[a-zA-Z_]\\w*。
-
-
rules:-
定义语法的核心规则。
-
类型为
object,其键需要匹配正则表达式^[a-zA-Z_]\\w*$,值引用了#/definitions/rule。
-
-
extras:-
定义额外的规则(通常是空白字符或注释)。
-
类型为
array,元素是rule,且不允许重复。
-
-
precedences:-
定义规则的优先级。
-
类型为
array,每个元素是另一个数组,包含唯一的字符串或symbol-rule。
-
-
reserved:-
定义保留的规则。
-
类型为
object,键是规则名称,值是rule的数组。
-
-
externals:-
定义外部规则。
-
类型为
array,元素是rule。
-
-
inline:-
定义内联规则。
-
类型为
array,元素是字符串,表示规则名称。
-
-
conflicts:-
定义冲突规则。
-
类型为
array,每个元素是一个字符串数组,表示可能冲突的规则名称。
-
-
word:-
定义一个特殊的规则名称,用于标识“单词”。
-
类型为
string,需要匹配正则表达式^[a-zA-Z_]\\w*。
-
-
supertypes:-
定义隐藏规则的名称,这些规则会被视为“超类型”。
-
类型为
array,元素是字符串,表示规则名称。
-
Rules
https://tree-sitter.github.io/tree-sitter/creating-parsers/2-the-grammar-dsl.html
整个 grammar.json 的核心内容便是 rules 字段,它定义了具体的语法核心规则,每个子键值对定义一个语法规则:
-
键: 这些是语法规则的名称(例如
program、statement、for_statement、expression)。这些名称会成为抽象语法树(AST)中的节点类型,当 tree-sitter 解析代码时会生成这些节点。可以将它们视为语言中不同的语法结构。 -
值(规则定义): 这些是规则定义本身。每个值是一个 JSON 对象,用于指定如何识别和解析由键命名的语法规则。这些定义告诉 tree-sitter 在输入文本中寻找哪些模式,以识别该规则的实例。
每个规则定义(rules 字典中的值)是一个 JSON 对象,并且必须包含一个 "type" 属性。这个 "type" 属性决定了正在定义的语法规则的类型,以及 tree-sitter 应该如何解析它。grammar.schema.json 中的 definitions 定义了全部类型的规则,它们是语法规则的基础构件:
1. blank-rule
-
含义: 表示空或空规则。它通常用于
CHOICE规则中,使语法的某些部分可选。 -
属性: 没有特别显著的属性,仅作为占位符。
-
必须包含字段:
"type": "BLANK"。
"simple_parameter": {
  "type": "SEQ",
  "members": [
    // ... 属性
    {
      "type": "FIELD",
      "name": "type",
      "content": {
        "type": "CHOICE",
        "members": [
          { "type": "SYMBOL", "name": "type" },
          { "type": "BLANK" } // 类型是可选的
        ]
      }
    },
    // ... simple_parameter 规则的其余部分
  ]
}
在 simple_parameter 中,参数的 type 是可选的,由 BLANK 选项表示。
2. string-rule
-
含义: 这种规则类型表示必须在输入中精确匹配的字面字符串。
-
关键属性:
"value""value": 需要精确匹配的字符串。
-
必须包含字段:
-
"type": "STRING" -
"value": 字符串值。
-
"_semicolon": {
  "type": "CHOICE",
  "members": [
    {
      "type": "SYMBOL",
      "name": "_automatic_semicolon"
    },
    {
      "type": "STRING",
      "value": ";" // 字面分号字符串
    }
  ]
}
在 _semicolon (分号,主要作用是标识语句的结束)规则中,";" 表示它会精确匹配 PHP 代码中的分号字符。
3. pattern-rule
-
含义: 这种规则类型使用正则表达式匹配一个标记。
-
关键属性:
"value""value": 正则表达式模式。
-
可选属性:
"flags""flags": 正则表达式标志(例如"i"表示不区分大小写匹配)
-
必须包含字段:
-
"type": "PATTERN" -
"value": 正则表达式。
-
"php_tag": {
  "type": "PATTERN",
  "value": "<\\?([pP][hH][pP]|=)?" // 匹配 PHP 起始标签的正则表达式
}
php_tag 规则使用正则表达式匹配 PHP 起始标签的各种变体(如 <?php、<?PHP、<?=、<?)。
4. symbol-rule
-
含义: 这种规则类型表示对同一
rules字段中定义的另一个规则的引用。它用于从简单规则构建更复杂的规则。 -
关键属性:
"name""name":"name"的值是另一个规则的名称,此规则引用该名称。
-
必须包含字段:
-
"type": "SYMBOL" -
"name": 符号名称。
-
"program": {
  "type": "SEQ",
  "members": [
    {
      "type": "CHOICE",
      "members": [
        {
          "type": "SYMBOL",
          "name": "text"  // 引用 'text' 规则
        },
        {
          "type": "BLANK"
        }
      ]
    },
    // ... program 规则的其余部分
  ]
},
"text": { // 'text' 规则的定义
  "type": "REPEAT1",
  // ... 'text' 规则的定义
}
在此示例中,program 规则使用 SYMBOL 引用了 text 规则。在解析时,tree-sitter 会查看 text 规则的定义以理解 text 的组成。
5. seq-rule
-
含义: 这种规则类型定义了必须按顺序匹配的一组规则。可以理解为“规则 A 后接规则 B 后接规则 C”。
-
关键属性:
"members""members": 一个规则定义数组(可以是SYMBOL、STRING、PATTERN或其他规则类型)。这个数组中的每个元素都是一个子规则的定义。SEQ规则要求输入文本必须按照"members"数组中子规则定义的顺序依次匹配。
-
必须包含字段:
-
"type": "SEQ" -
"members": 一个rule的数组。
-
"function_static_declaration": {
  "type": "SEQ",
  "members": [
    {
      "type": "ALIAS",
      "content": {
        "type": "PATTERN",
        "value": "static",
        "flags": "i"
      },
      "named": false,
      "value": "static"
    },
    {
      "type": "SEQ",
      "members": [
				// ... 其余部分
      ]
    },
    {
      "type": "SYMBOL",
      "name": "_semicolon"
    }
  ]
}
function_static_declaration 规则的 "type" 是 "SEQ",它定义了 PHP 中函数内部 static 变量声明的语法结构。
-
固定开头:
SEQ的第一个成员确保了每个函数内的静态变量声明必须以static关键字开始。 -
变量声明序列:
SEQ的第二个成员(本身也是一个SEQ)处理了静态变量声明的列表。它强制至少要有一个static_variable_declaration,并且允许通过逗号分隔声明多个变量。这种嵌套的SEQ结构展示了如何用SEQ组合更复杂的序列模式。 -
语句结束符:
SEQ的第三个成员确保了整个static变量声明语句以分号结束,符合 PHP 语句的语法规则。
<?php
function myFunction() {
  static $count = 0;
  static $name = "example", $value;
  // ... 函数体 ...
}
?>
在这个例子中,第二行 static $count = 0; 和第三行 static $name = "example", $value; 都匹配 function_static_declaration 规则。
-
static $count = 0;匹配function_static_declaration,因为:-
以
static关键字开始 (members[0])。 -
接着是一个
static_variable_declaration($count = 0) (members[1]的内部SEQ的members[0])。 -
最后以分号
;结束 (members[2])。
-
-
static $name = "example", $value;也匹配function_static_declaration,因为:-
以
static关键字开始 (members[0])。 -
接着是第一个
static_variable_declaration($name = "example") (members[1]的内部SEQ的members[0])。 -
然后是逗号
,和第二个static_variable_declaration($value), 这部分通过members[1]的内部SEQ的members[1](即REPEAT规则) 来处理。 -
最后以分号
;结束 (members[2])。
-
6. choice-rule
-
含义: 这种规则类型定义了多个规则之间的选择。它表示“匹配规则 A 或规则 B 或规则 C”。
-
关键属性:
"members""members": 一个规则定义数组。
-
必须包含字段:
-
"type": "CHOICE" -
"members": 一个rule的数组。
-
"statement": {
  "type": "CHOICE",
  "members": [
    { "type": "SYMBOL", "name": "empty_statement" },
    { "type": "SYMBOL", "name": "compound_statement" },
    // ... 许多其他语句类型
  ]
}
statement 规则可以是列出的任何语句类型(空语句、复合语句、if 语句等)。
7. alias-rule
-
含义: 这种规则类型重命名 AST 中的节点类型。这对于使 AST 更具语义意义或一致性非常有用,即使底层语法规则名称不同。
-
关键属性:
"content"、"value"、"named"-
"content":需要重命名的规则。 -
"value":希望在 AST 中为节点命名的新名称。 -
"named":布尔值,决定了通过别名创建的节点是命名节点(named node)还是匿名节点(anonymous node),通常关键字为false,命名节点为true。
-
-
必须包含字段:
-
"type": "ALIAS" -
"value": 别名值。 -
"named": 是否命名规则。 -
"content": 引用的规则。
-
Tree-sitter 的语法树中存在两种主要的节点类型:
1. 命名节点 (named: true)
代表语言中的有意义语法结构(如变量声明、函数定义等)
在语法树中明确可见,可以通过名称引用
通常表示更高层次的语法概念
在查询语言中可以直接通过名称选择
2. 匿名节点 (named: false)
代表语法标记、分隔符或其他辅助性元素(如括号、逗号、关键字等)
在语法树的可视化表示中通常不作为独立节点显示
被视为父节点的一部分而不是独立实体
在查询语言中不能直接通过名称选择,但可以通过其字面值匹配
区别:
语法树结构:
命名节点 (
named: true) 在树中作为独立节点存在匿名节点 (
named: false) 仅作为字符串值存在,不产生独立节点查询影响:
可以编写查询来捕获命名节点:
(parameter_name) @param无法直接通过名称查询匿名节点,但可以通过内容匹配:
"let" @keyword
named字段决定了别名节点是作为语法树中的独立实体存在(named: true),还是仅作为父节点的一部分存在(named: false)。理解这一区别对于正确设计语法、编写查询以及处理语法树至关重要。
"final_modifier": {
  "type": "ALIAS",
  "content": {
    "type": "PATTERN",
    "value": "final",
    "flags": "i"
  },
  "named": false,
  "value": "final" // 将 'final' 关键字别名为 'final' 节点
},
"_class_const_declaration": {
  "type": "SEQ",
  "members": [
     {
       "type": "ALIAS",
       "content": {
         "type": "SYMBOL",
         "name": "_class_const_declaration"
       },
       "named": true,
       "value": "const_declaration" // 将 _class_const_declaration 别名为 AST 中的 const_declaration 节点
     },
     // ... 规则的其余部分
  ]
}
final_modifier 规则将关键字 “final” 别名为 AST 中名为 “final” 的节点。_class_const_declaration 规则将 _class_const_declaration 规则别名为 AST 中的 const_declaration 节点。
8. repeat-rule & repeat1-rule
-
含义: 这些规则类型定义重复。
-
"REPEAT":匹配content规则零次或多次。 -
"REPEAT1":匹配content规则一次或多次。
-
-
关键属性:
"content""content": 要重复的规则定义。
-
必须包含字段:
-
"type": "REPEAT"||"type": "REPEAT1" -
"content": 引用的规则。
-
"program": {
  "type": "SEQ",
  "members": [
    // ...
    {
      "type": "CHOICE",
      "members": [
        {
          "type": "SEQ",
          "members": [
            {
              "type": "SYMBOL",
              "name": "php_tag"
            },
            {
              "type": "REPEAT", // 'statement' 的零次或多次重复
              "content": {
                "type": "SYMBOL",
                "name": "statement"
              }
            }
          ]
        },
        {
          "type": "BLANK"
        }
      ]
    }
  ]
},
"text": {
  "type": "REPEAT1", // 至少重复一次的内容
  "content": {
    "type": "CHOICE",
    "members": [
      // ... text 的标记定义
    ]
  }
}
在 program 规则中,在 php_tag 之后可以有零次或多次 statement。text 规则被定义为其内容至少重复一次。
9. token-rule
token 规则的核心功能是将一个复杂的规则整体视为单一词法单元。它指示解析器将匹配的内容作为一个原子单元处理,而不是分解为更小的部分。当使用 token 方法时,我们创建了一个单一的文本标记。token 方法只接受终结规则(terminal rules),因此不能引用其他规则。
-
含义: 将一个复杂的模式标记为单个词法单元,适用于“当多个字符应该被视为单个不可分割的标记时”,通常用于语法中的终结符号(标记)。
-
关键属性:
"content""content":定义标记的规则
-
必须包含字段:
-
"type": 可以是"TOKEN"或"IMMEDIATE_TOKEN"。 -
"content": 引用的规则。
-
"integer": {
  "type": "TOKEN",
  "content": {
    "type": "CHOICE",
    "members": [
      { "type": "PATTERN", "value": "[1-9]\\d*(_\\d+)*" }, // 匹配十进制整数的模式
      { "type": "PATTERN", "value": "0[oO]?[0-7]*(_[0-7]+)*" }, // 匹配八进制整数的模式
      // ... 更多整数模式
    ]
  }
}
integer 规则是一个 TOKEN,它可以是几种模式之一(十进制、八进制、十六进制、二进制)。
10. field-rule
-
含义:为 AST 中的子节点命名。
-
关键属性:
"name"、"content"-
"name":希望赋予子节点的名称(例如"condition"、"body"、"name")。 -
"content":子节点的规则定义。
-
-
必须包含字段:
-
"name": 字段名称。 -
"type": "FIELD" -
"content": 引用的规则。
-
"if_statement": {
  "type": "SEQ",
  "members": [
    { "type": "ALIAS", /* ... "if" 关键字 ... */ },
    {
      "type": "FIELD",
      "name": "condition", // 将括号中的表达式命名为 'condition'
      "content": {
        "type": "SYMBOL",
        "name": "parenthesized_expression"
      }
    },
    {
      "type": "FIELD",
      "name": "body", // 将语句命名为 'body'
      "content": {
        "type": "SYMBOL",
        "name": "statement"
      }
    },
    // ... if 语句规则的其余部分
  ]
}
在 if_statement 规则中,parenthesized_expression 被命名为 "condition",紧随其后的 statement 被命名为 "body",使其在 AST 中清楚地表示每个部分的含义。
11. prec-rule 和优先级规则(PREC_LEFT、PREC_RIGHT、PREC_DYNAMIC)
-
含义: 这些规则用于处理语法中的运算符优先级和结合性,尤其是在表达式中。它们帮助解析时解决歧义。
-
"PREC":设置一个通用的优先级级别。 -
"PREC_LEFT":设置左结合性和优先级。 -
"PREC_RIGHT":设置右结合性和优先级。 -
"PREC_DYNAMIC":动态优先级,通常用于更复杂的情况。
-
-
关键属性:
"value"和"content"-
"value":优先级级别(数字越大优先级越高)。 -
"content":优先级适用的规则。
-
-
必须包含字段:
-
"type": 可以是"PREC"、"PREC_LEFT"、"PREC_RIGHT"或"PREC_DYNAMIC"。 -
"value": 优先级值,可以是整数或字符串。 -
"content": 引用的规则。
-
"unary_op_expression": {
  "type": "PREC_LEFT", // 左结合的一元运算符
  "value": 19,
  "content": {
    "type": "SEQ",
    "members": [
      { /* 运算符 */ },
      { "type": "SYMBOL", "name": "expression" } // 参数是 'expression'
    ]
  }
},
"sequence_expression": {
  "type": "PREC",  // 序列(逗号)表达式的低优先级
  "value": -1,
  "content": {
    "type": "SEQ",
    "members": [
      { "type": "SYMBOL", "name": "expression" },
      { "type": "STRING", "value": "," },
      { /* 序列的下一部分的选择 */ }
    ]
  }
}
在 unary_op_expression 中,PREC_LEFT 使得像 -5 中的 - 这种一元运算符具有左结合性,优先级为 19。sequence_expression 中的 PREC 使用一个较低的值,使逗号运算符的优先级非常低。
示例阐述
下面通过 if_statement 的规则定义进行具体的示例讲解。
👇 展开查看完整的 if_statement 定义
"if_statement": {
  "type": "SEQ",
  "members": [
    {
      "type": "ALIAS",
      "content": {
        "type": "PATTERN",
        "value": "if",
        "flags": "i"
      },
      "named": false,
      "value": "if"
    },
    {
      "type": "FIELD",
      "name": "condition",
      "content": {
        "type": "SYMBOL",
        "name": "parenthesized_expression"
      }
    },
    {
      "type": "CHOICE",
      "members": [
        {
          "type": "SEQ",
          "members": [
            {
              "type": "FIELD",
              "name": "body",
              "content": {
                "type": "SYMBOL",
                "name": "statement"
              }
            },
            {
              "type": "REPEAT",
              "content": {
                "type": "FIELD",
                "name": "alternative",
                "content": {
                  "type": "SYMBOL",
                  "name": "else_if_clause"
                }
              }
            },
            {
              "type": "CHOICE",
              "members": [
                {
                  "type": "FIELD",
                  "name": "alternative",
                  "content": {
                    "type": "SYMBOL",
                    "name": "else_clause"
                  }
                },
                {
                  "type": "BLANK"
                }
              ]
            }
          ]
        },
        {
          "type": "SEQ",
          "members": [
            {
              "type": "FIELD",
              "name": "body",
              "content": {
                "type": "SYMBOL",
                "name": "colon_block"
              }
            },
            {
              "type": "REPEAT",
              "content": {
                "type": "FIELD",
                "name": "alternative",
                "content": {
                  "type": "ALIAS",
                  "content": {
                    "type": "SYMBOL",
                    "name": "else_if_clause_2"
                  },
                  "named": true,
                  "value": "else_if_clause"
                }
              }
            },
            {
              "type": "CHOICE",
              "members": [
                {
                  "type": "FIELD",
                  "name": "alternative",
                  "content": {
                    "type": "ALIAS",
                    "content": {
                      "type": "SYMBOL",
                      "name": "else_clause_2"
                    },
                    "named": true,
                    "value": "else_clause"
                  }
                },
                {
                  "type": "BLANK"
                }
              ]
            },
            {
              "type": "ALIAS",
              "content": {
                "type": "PATTERN",
                "value": "endif",
                "flags": "i"
              },
              "named": false,
              "value": "endif"
            },
            {
              "type": "SYMBOL",
              "name": "_semicolon"
            }
          ]
        }
      ]
    }
  ]
}
可以看到 if_statement 规则的 "type" 是 "SEQ",这意味着一个 PHP 的 if 语句必须按照 "members" 数组中定义的顺序出现。接下来逐个分析 "members" 数组中的元素:
-
members[0]:{ "type": "ALIAS", "content": { "type": "PATTERN", "value": "if", "flags": "i" }, "named": false, "value": "if" }-
这是一个
ALIAS规则,它将一个PATTERN规则别名为"if"。 -
PATTERN规则匹配字符串"if"(value: "if"),并且flags: "i"表示匹配是大小写不敏感的,所以可以匹配if,If,IF等。 -
named: false表示这个节点在抽象语法树中不会被明确命名,而是作为其父节点的匿名子节点。 -
value: "if"表示在 AST 中,这个节点会被标记为"if"类型。 -
含义:
if_statement必须以关键字if开头。
-
-
members[1]:{ "type": "FIELD", "name": "condition", "content": { "type": "SYMBOL", "name": "parenthesized_expression" } }-
这是一个
FIELD规则,它给子规则命名为"condition"。 -
content是一个SYMBOL规则,引用了另一个规则"parenthesized_expression"。 -
含义: 在
if关键字之后,必须紧跟着一个用圆括号包裹的表达式,这个表达式会被解析为"parenthesized_expression"规则,并且在 AST 中被标记为"condition"字段,表示if语句的条件。
-
-
members[2]:{ "type": "CHOICE", "members": [ // ... 第一个 CHOICE 分支 // ... 第二个 CHOICE 分支 ] }-
这是一个
CHOICE规则,表示在条件表达式之后,if_statement可以有两种不同的结构。 -
members数组包含两个SEQ规则,分别对应了两种if语句的语法形式:-
第一个
SEQ分支: 对应使用花括号{}包裹代码块的if语句。 -
第二个
SEQ分支: 对应使用冒号:和endif关键字的代码块形式。
-
让我们进一步看 第一个
SEQ分支(使用花括号的代码块):{ "type": "SEQ", "members": [ { "type": "FIELD", "name": "body", "content": { "type": "SYMBOL", "name": "statement" } }, { "type": "REPEAT", "content": { "type": "FIELD", "name": "alternative", "content": { "type": "SYMBOL", "name": "else_if_clause" } } }, { "type": "CHOICE", "members": [ { "type": "FIELD", "name": "alternative", "content": { "type": "SYMBOL", "name": "else_clause" } }, { "type": "BLANK" } ] } ] }-
members[0]:FIELD规则,命名为"body",content是SYMBOL规则"statement"。- 含义:
if条件之后,可以紧跟着一个statement,作为if的主体代码块,在 AST 中标记为"body"字段。
- 含义:
-
members[1]:REPEAT规则,表示重复零次或多次。content是FIELD规则,命名为"alternative",content是SYMBOL规则"else_if_clause"。- 含义: 在
if主体代码块之后,可以有零个或多个elseif分支,每个elseif分支会被解析为"else_if_clause"规则,并在 AST 中标记为"alternative"字段。
- 含义: 在
-
members[2]:CHOICE规则,表示选择。members数组包含两个规则:-
members[0]:FIELD规则,命名为"alternative",content是SYMBOL规则"else_clause"。- 含义: 可以有一个
else分支,解析为"else_clause"规则,并在 AST 中标记为"alternative"字段。
- 含义: 可以有一个
-
members[1]:BLANK规则。- 含义:
else分支是可选的,可以没有else分支。
- 含义:
-
-
SEQ规则在if_statement中起着至关重要的作用,它定义了if语句的语法结构和各个组成部分的顺序:
强制顺序:
SEQ确保了if语句必须按照if关键字 -> 条件表达式 -> 主体代码块 (->elseif分支 ->else分支) 的顺序出现。如果顺序不对,例如条件表达式在if关键字之前,解析器就会报错。构建 AST 结构: 通过
SEQ规则的结构,结合FIELD规则的命名,tree-sitter 可以正确地构建if_statement的 AST 节点,并且明确地标记出条件、主体、elseif和else分支等各个部分,方便后续的语法分析和代码处理。
<?php
if ($condition) {
  // if body
  echo "Condition is true";
} elseif ($condition2) {
  // elseif body
  echo "Condition 2 is true";
} else {
  // else body
  echo "All conditions are false";
}
?>
这个 PHP 代码会成功匹配 if_statement 规则,因为它的结构符合 SEQ 规则定义的顺序:
-
以
if关键字开始 (members[0]). -
紧跟圆括号包裹的条件表达式
($condition)(members[1]). -
然后是一个花括号
{}包裹的代码块 (members[2]的第一个SEQ分支的members[0]). -
之后是一个
elseif分支 (members[2]的第一个SEQ分支的members[1]). -
最后是一个
else分支 (members[2]的第一个SEQ分支的members[2]).
Tree-sitter 的一些 Python package
-
官方的 python tree-sitter 库:https://github.com/tree-sitter/py-tree-sitter
-
很方便的集成调用库,看起来不打算维护了:https://github.com/grantjenks/py-tree-sitter-languages
- fork 出来,最新维护的库:https://github.com/Goldziher/tree-sitter-language-pack
1. 使用 py-tree-sitter(基础库)
1.1 手动编译
适用于需要直接控制和自定义语法的情况:
from tree_sitter import Language, Parser

# 编译 C++ 语法(首次设置)
Language.build_library(
    'build/cpp.so',  # 输出路径
    ['path/to/tree-sitter-cpp']  # 从 <https://github.com/tree-sitter/tree-sitter-cpp> 克隆
)

# 初始化解析器
cpp_language = Language('build/cpp.so', 'cpp')
parser = Parser()
parser.set_language(cpp_language)
关键点:
-
需要手动编译语法
-
可完全控制语法版本
1.2 联动 tree-sitter-{language}
Tree-sitter 语言的实现也提供预编译的二进制程序。(不知道 Python 以外的其他语言是否试用)
# pip install tree-sitter-python

import tree_sitter_python as tspython
from tree_sitter import Language, Parser

PY_LANGUAGE = Language(tspython.language())
parser = Parser(PY_LANGUAGE)
2. 使用 py-tree-sitter-languages
from tree_sitter_languages import get_language, get_parser

cpp_language = get_language('cpp')
parser = get_parser('cpp')

tree = parser.parse(b"int main() { return 0; }")
优点:
-
包含预编译的 C++ 语法
-
无需构建依赖
3. 使用 tree-sitter-language-pack
from tree_sitter_language_pack import get_language, get_parser

cpp_language = get_language('cpp')
parser = get_parser('cpp')

tree = parser.parse(b"template<typename T> class Widget;")
特点:
-
维护良好的分支,支持 100+ 种语言
-
兼容 Tree-sitter ≥0.22.0
-
提供适用于所有主流平台的预构建包
一般的解析步骤:
# 解析 C++ 代码
source_code = b'''
#include <iostream>
int main() { std::cout << "Hello\\\\n"; }
'''
tree = parser.parse(source_code)

# 检查 AST
root_node = tree.root_node
print(root_node.sexp())  # (translation_unit...)
主要区别:
| 库名称 | 是否需要编译 | 语法更新方式 | 支持的语言数量 |
py-tree-sitter |
是 | 手动更新 | 任意语言 |
py-tree-sitter-languages |
否 | 定期更新 | 50+ |
tree-sitter-language-pack |
否 | 频繁更新 | 100+ |
可视化 Tree-sitter 解析的 AST
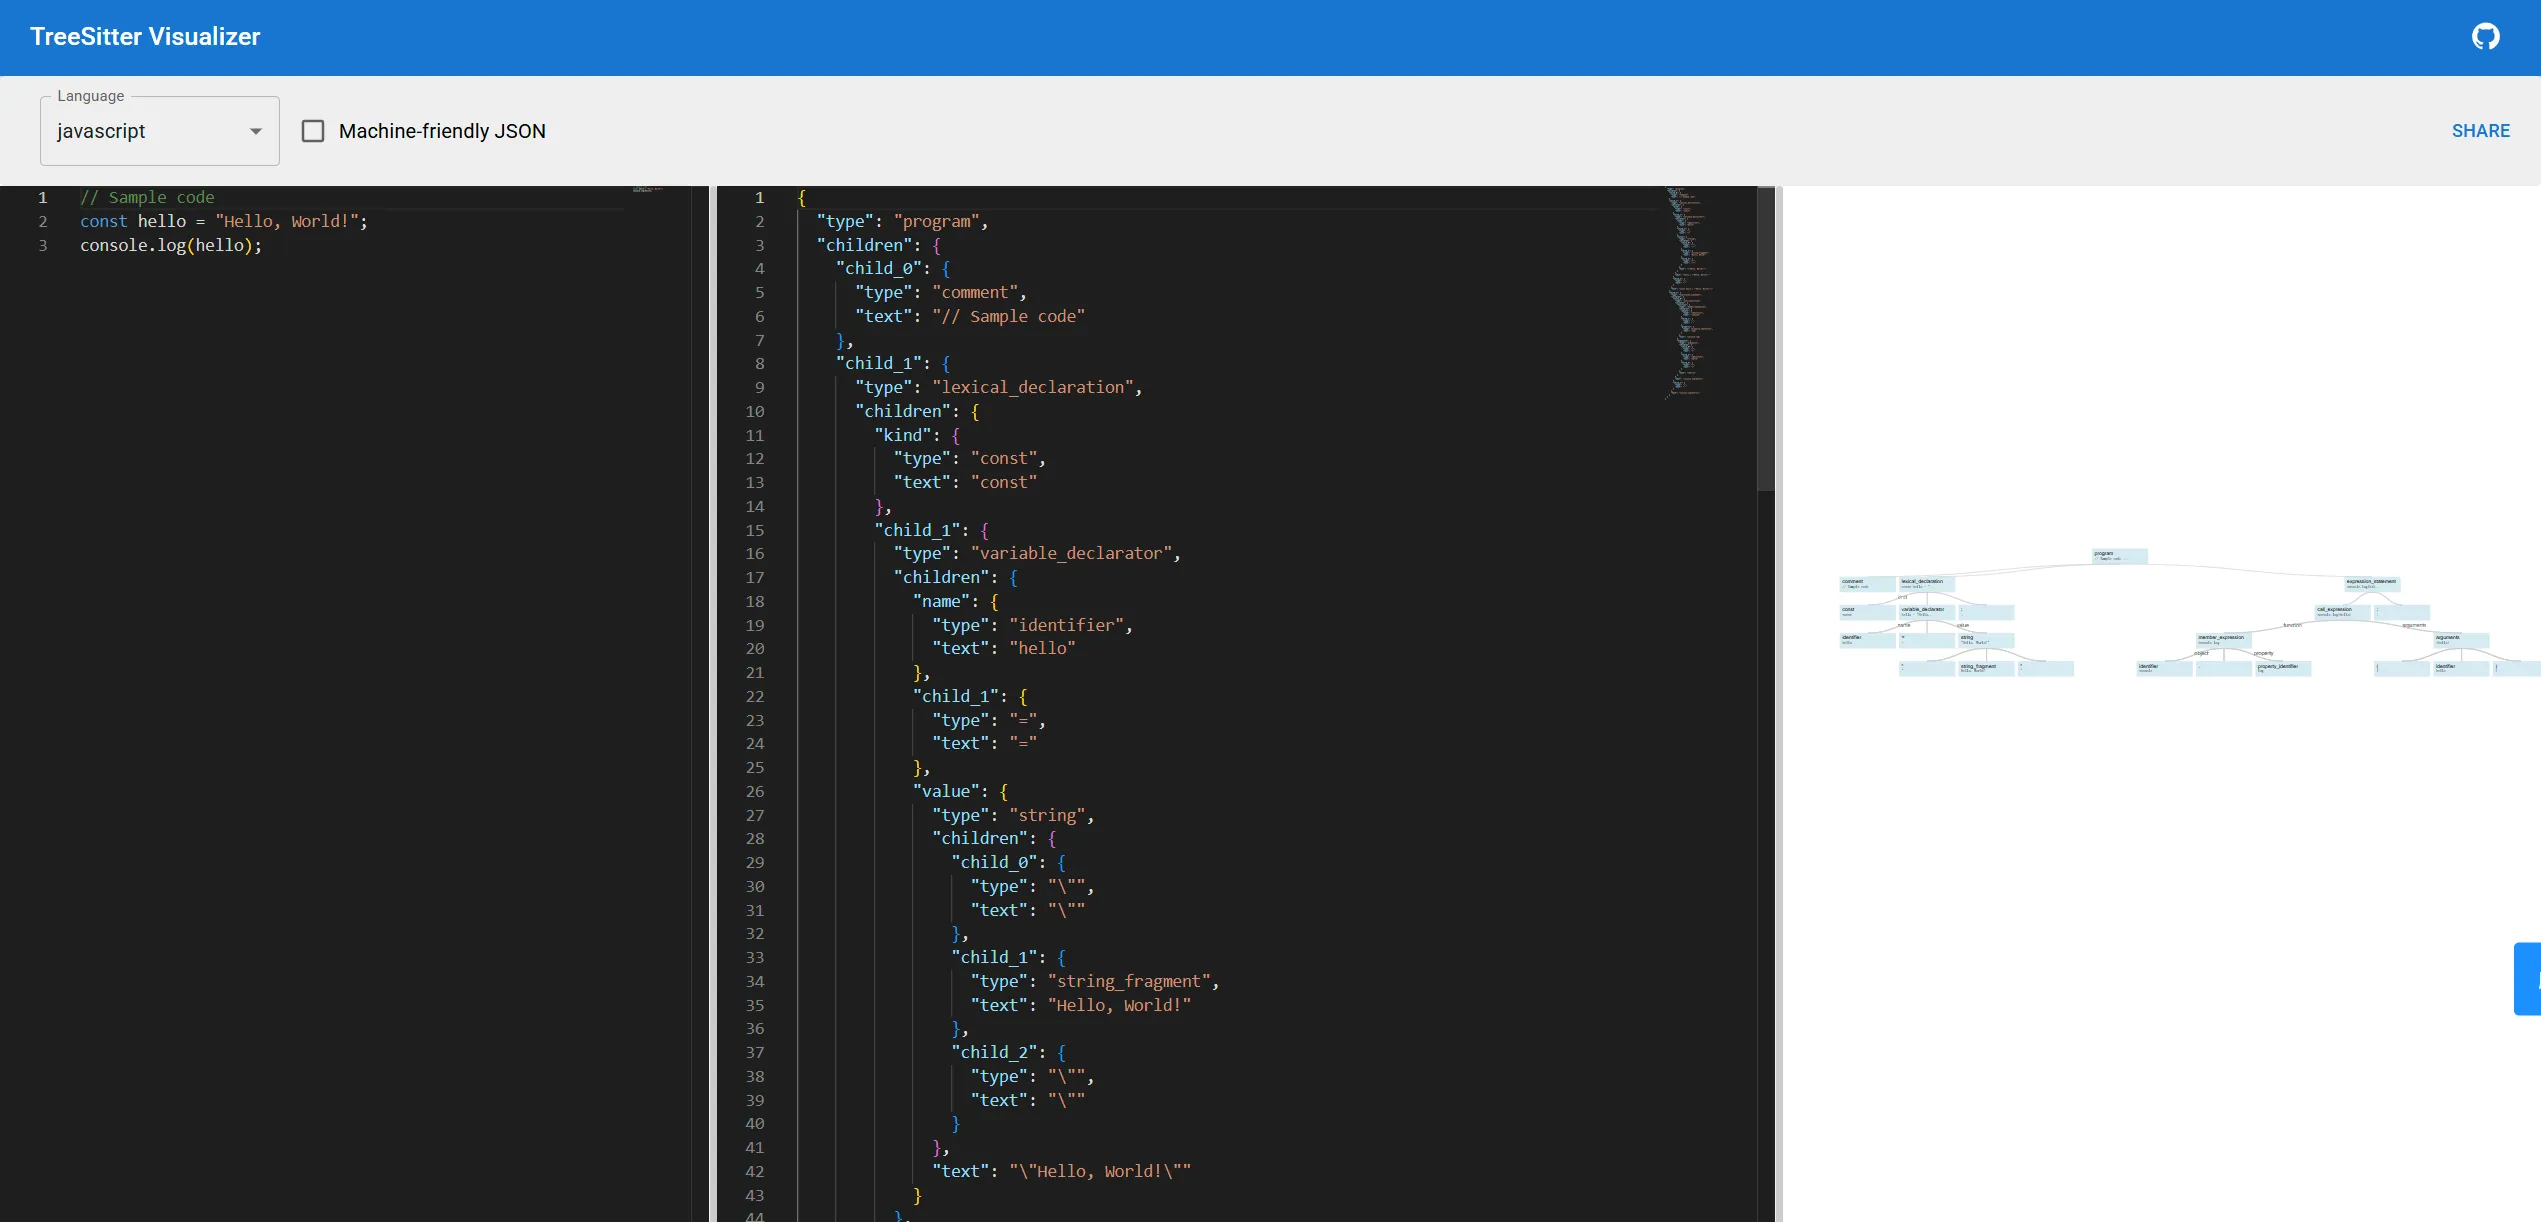
https://github.com/htfy96/ts-visualizer
TS-Visualizer 是一个支持本地和网页端的 AST 解析和可视化工具项目,通过 Tree-Sitter 的 WASM 支持在浏览器中解析源码,并使用 tree-sitter-langs 提供的语言解析器编译完成。
总结
学习 Tree-sitter 最好的方法是实践,找一段简短的代码,解析出 AST,然后可以通过可视化查看 AST 中的节点及其字段中的具体内容,通过代码尝试便利某个节点的 children 等,看的多了就慢慢熟悉整个结构了~